WO2020148919A1 - 情報処理装置、提示システム、及び情報処理プログラム - Google Patents
情報処理装置、提示システム、及び情報処理プログラム Download PDFInfo
- Publication number
- WO2020148919A1 WO2020148919A1 PCT/JP2019/009241 JP2019009241W WO2020148919A1 WO 2020148919 A1 WO2020148919 A1 WO 2020148919A1 JP 2019009241 W JP2019009241 W JP 2019009241W WO 2020148919 A1 WO2020148919 A1 WO 2020148919A1
- Authority
- WO
- WIPO (PCT)
- Prior art keywords
- information
- learner
- unit
- difference
- presentation
- Prior art date
- Legal status (The legal status is an assumption and is not a legal conclusion. Google has not performed a legal analysis and makes no representation as to the accuracy of the status listed.)
- Ceased
Links
Images



Classifications
-
- G—PHYSICS
- G09—EDUCATION; CRYPTOGRAPHY; DISPLAY; ADVERTISING; SEALS
- G09B—EDUCATIONAL OR DEMONSTRATION APPLIANCES; APPLIANCES FOR TEACHING, OR COMMUNICATING WITH, THE BLIND, DEAF OR MUTE; MODELS; PLANETARIA; GLOBES; MAPS; DIAGRAMS
- G09B19/00—Teaching not covered by other main groups of this subclass
-
- G—PHYSICS
- G09—EDUCATION; CRYPTOGRAPHY; DISPLAY; ADVERTISING; SEALS
- G09B—EDUCATIONAL OR DEMONSTRATION APPLIANCES; APPLIANCES FOR TEACHING, OR COMMUNICATING WITH, THE BLIND, DEAF OR MUTE; MODELS; PLANETARIA; GLOBES; MAPS; DIAGRAMS
- G09B5/00—Electrically-operated educational appliances
- G09B5/02—Electrically-operated educational appliances with visual presentation of the material to be studied, e.g. using film strip
-
- G—PHYSICS
- G09—EDUCATION; CRYPTOGRAPHY; DISPLAY; ADVERTISING; SEALS
- G09B—EDUCATIONAL OR DEMONSTRATION APPLIANCES; APPLIANCES FOR TEACHING, OR COMMUNICATING WITH, THE BLIND, DEAF OR MUTE; MODELS; PLANETARIA; GLOBES; MAPS; DIAGRAMS
- G09B5/00—Electrically-operated educational appliances
- G09B5/06—Electrically-operated educational appliances with both visual and audible presentation of the material to be studied
-
- G—PHYSICS
- G10—MUSICAL INSTRUMENTS; ACOUSTICS
- G10L—SPEECH ANALYSIS TECHNIQUES OR SPEECH SYNTHESIS; SPEECH RECOGNITION; SPEECH OR VOICE PROCESSING TECHNIQUES; SPEECH OR AUDIO CODING OR DECODING
- G10L15/00—Speech recognition
-
- H—ELECTRICITY
- H04—ELECTRIC COMMUNICATION TECHNIQUE
- H04N—PICTORIAL COMMUNICATION, e.g. TELEVISION
- H04N23/00—Cameras or camera modules comprising electronic image sensors; Control thereof
- H04N23/60—Control of cameras or camera modules
Definitions
- the present invention relates to an information processing device, an information processing method, a presentation system, and an information processing program.
- an information processing apparatus includes a face information acquisition unit that acquires face information including information of at least a part of a face of a work learner who learns customer service, The difference between the voice information acquisition unit that acquires voice information including the information about the utterance by the work learner and the state of at least a part of the face indicated by the face information acquired by the face information acquisition unit and the first reference information First difference information indicating the first difference information and a difference information deriving unit deriving second difference information indicating a difference between the voice information acquired by the voice information acquiring unit and the second reference information, and the first difference information. And a presentation information generation unit that generates presentation information according to at least one of the second difference information.
- an information processing device that can support learning of a work learner regarding customer service work.
- the learner's information and reference information include, for example, the visually recognizable object, the degree of concentration on the visually recognizable object, the utterance content, the tone and movement of the voice, and the like.
- the presentation system 800 includes an information processing device 100, a head mounted display 200, a wearable interface 300, an information management server 400, and a display unit 500.
- the presentation system 800 according to the present embodiment can provide learning support to the learner.
- the control unit 250 of the head mounted display 200 centrally controls each unit of the head mounted display 200.
- Each function of the control unit 250 and all the functions included in the head mounted display 200 may be realized by the CPU executing a program stored in a storage unit (not shown) or the like, for example.
- the communication unit 260 communicates with the information processing device 100 under the control of the control unit 250.
- the form of communication is not particularly limited, and may be communication using Bluetooth (registered trademark), WiFi (registered trademark), other short-range wireless communication technology, or other communication.
- the speaker 240 outputs the sound input to the head mounted display 200 via the communication unit 260.
- the display 270 outputs the image input to the head mounted display 200 via the communication unit 260.
- the image output by the display 270 may display a virtual space, and the display example of the display 270 may be the image shown in FIG.
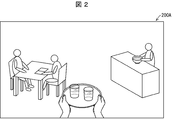
- FIG. 2 is a diagram showing an example of an image displayed on the display of the head mounted display according to the embodiment of the present invention.
- An image 200A shown in FIG. 2 is a view of the inside of a restaurant from the viewpoint of a learner who is a store clerk, and the image 200A shows customers, his/her own hands, a clerk other than himself, a table, and the like.
- the face information acquisition unit 111 acquires face information including information on at least a part of the learner's face at each time point.
- the face information acquisition unit 111 can acquire the learner's face information from the image acquired from the camera 210 included in the head mounted display 200, for example.
- the learner's face information is information indicating the face feature amount.
- the feature amount of the face indicates, for example, position information indicating the position of each part of the face (for example, eyes, nose, mouth, eyebrows, etc.), shape information indicating the shape, size information indicating the size, and the like.
- the motion information acquisition unit 115 acquires motion information indicating the motion of at least a part of the body of the work learner at each time point.
- the motion information acquisition unit 115 acquires from the motion sensor 230 of the head mounted display 200, the motion sensor 310 of the wearable interface 300, or the button 320, as shown in FIG. 1, for example.
- the camera 210 of the head mounted display 200 obtains the learned body from the captured image.
- the motion information acquired by the motion information acquisition unit 115 is input to the decision making information specifying unit 116.
- the decision making information specifying unit 116 specifies the utterance content and the tone of the voice uttered by the learner. For example, as shown in FIG. 3, the decision-making information identifying unit 116 identifies the utterance content as text indicating the utterance content such as "Welcome to you" or "What do you want to order?" The tone is specified as one of high, medium and low as an example.
- decision making information specifying unit 116 may specify the decision making information by using the machine learning method described in (state detecting unit).
- the decision-making information identifying unit 116 identifies that the tone of the learner's voice is “medium”. .. Further, as shown in event ID1 of FIG. 4, according to the information stored in advance in the storage unit 140, the tone of the voice of the veteran customer at the timing “00;00;03” is “high”.
- the difference information derivation unit 118 determines that the tone of the learner's voice is lower than that of the veteran customer based on the both data, and as the difference information regarding the item of the voice tone, as shown in event ID1 of FIG. -" is derived.
- the difference information derivation unit 118 may derive the difference information using the machine learning method described in (State detection unit).
- the learner information acquisition unit 117 inputs the learner information acquired from the information management server 400 to the presentation information generation unit 119.
- the presentation information generation unit 119 uses the difference information derived by the difference information derivation unit 118 (the visual recognition target and the degree of concentration identified by the visual identification target identification unit 113 from the face information, and the utterance and movement identified by the decision making information identification unit 116 from the voice information) The presentation information is generated based on the information derived from the action specified from the information). In one example, the presentation information generated by the presentation information generation unit 119 is an image.
- the presentation information generation unit 119 generates presentation information in which the object visually recognized by the veteran customer is highlighted when the object visually recognized by the learner is different from the visually recognized object.
- FIG. 8 is a diagram showing an example of the presentation information generated by the presentation information generation unit 119.
- An image 200C shown in FIG. 8 is an image in which an object to be visually recognized by the learner is highlighted, and an arrow pointer 200C1 is added as a symbol to the image 200A shown in FIG.
- the arrow pointer 200C1 has an arrow shape, but may have any shape and color.
- highlighting of the visual target in addition to surrounding the visual target, changing the background color around the visual target, displaying the visual target larger than other images, and For example, displaying an image as a pop-up window.
- the presentation information generation unit 119 may calculate a score according to the difference information derived by the difference information derivation unit 118, and may include the calculated score in the presentation information.
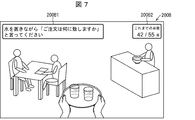
- FIG. 7 is a diagram showing an example of the presentation information generated by the presentation information generating unit 119.
- the image 200B shown in FIG. 7 includes an instruction window 200B1 and a score window 200B2 as text.
- the instruction window 200B1 in the image 200B is a window for displaying the text indicating the utterance content and the action to be performed by the learner.
- the content of the guide is based on the data of the experienced customer who is stored in the storage unit 140 in advance.
- the text may indicate all the utterance contents and actions that the learner should perform, for example, “A guest lifted his face from the menu, what do you do? ", etc. may be used to give a hint to the learner.
- the method of changing the deduction points according to the degree of deviation and (ii) not only the difference information for judging the degree of deviation, but also the difference information for judging whether they match or not If it does not deviate from the specified range (for example, a veteran customer's visual target is the "customer's eye", whereas the learner's visual target is the "customer's nose", the utterance of the veteran customer The content is "What do you want to order?", but the content of the learner's utterance was "Ask for your order, etc.)" Examples of the method include, but are not limited to.
- the presentation information generation unit 119 refers to the learner information acquired by the learner information acquisition unit 117 when generating the presentation information. By referring to the learner information, the presentation information generation unit 119 can present the presentation information such that each learner can effectively learn according to the attribute of each learner.
- the presentation information generation unit 119 when the learner in the present embodiment has never experienced hospitality business, the presentation information generation unit 119 generates the presentation information in which the visual recognition target is more emphasized, or a guide with more specific content. The presentation information including is generated. Further, for example, when the learner's previous learning period is longer than the predetermined period, the presentation information generating unit 119 generates the presentation information including the score indicating the learner's proficiency level calculated under a more severe condition. You can Further, in one example, the presentation information generation unit 119 can generate presentation information including a voice such as an anime character that the learner likes.
- the presentation information generation unit 119 transmits the generated presentation information to the head mounted display 200.
- the presentation information generation unit 119 also transmits the presentation information to the display unit 500.
- the presentation system 800 includes a display unit 500.
- the display unit 500 displays the presentation information generated by the presentation information generation unit 119, mainly for an instructor who teaches a learner.
- the image displayed by the display unit 500 may include the table showing the learner's data shown in FIG. 3 and the table showing the difference information shown in FIG. 5.
- the image of the veteran customer shown in FIG. It may include a table showing the data.
- the image displayed by the display unit 500 may include a part of the image displayed by the display 270 of the head mounted display 200.
- FIG. 6 is a flowchart showing processing of the presentation system 800. The processing of the presentation system 800 will be described based on FIG.
- the face information acquisition unit 111 acquires from the camera 210 in the learner's head-mounted display 200 and extracts each part of the face from the face image (face information acquisition step). Details of the processing are as described in (Face information acquisition unit). The face information acquisition unit 111 transmits the extracted result to the state detection unit 112, and proceeds to S106.
- the state detection unit 112 detects the learner's visual recognition target, blink, pupil state, and the state of each part of the face (state detection step). The details of the processing are as described in (State detection unit). The detection result is transmitted to the visual recognition target specifying unit 113, and the process proceeds to S108.
- At least one of the voice information acquisition unit 114 and the motion information acquisition unit 115 refers to whether voice information, motion information, or the like (hereinafter, sometimes referred to as “decision-making information”) is acquired, The presence or absence of decision information is determined. If there is decision-making information, the voice information acquisition unit 114 and the movement information acquisition unit 115 transmit the acquired decision-making information to the decision-making information specifying unit 116, and the process proceeds to S113. If there is no decision-making information, the process proceeds to S114.
- the difference information deriving unit 118 acquires reference information such as the visual recognition target of the veteran customer and the decision-making information stored in the storage unit 140 in advance (reference information acquisition step). Proceed to S116.
- the program may be supplied to the computer via any transmission medium (communication network or broadcast wave) capable of transmitting the program.
- any transmission medium communication network or broadcast wave
- one aspect of the present invention can also be realized in the form of a data signal embedded in a carrier wave, in which the program is embodied by electronic transmission.
- the information processing apparatus may be realized by a computer.
- the information processing apparatus is converted into a computer by operating the computer as each unit (software element) included in the information processing apparatus.
- the control program of the information processing device realized by the above, and a computer-readable recording medium recording the program are also included in the scope of the present invention.
- An information processing apparatus includes a face information acquisition unit that acquires face information including information of at least a part of a face of a work learner who learns customer service, and information about a utterance by the work learner.
- a voice information acquisition unit that acquires voice information that includes the first difference information that indicates a difference between at least a part of the state of the face indicated by the face information acquired by the face information acquisition unit and the first reference information;
- a difference information derivation unit that derives second difference information indicating a difference between the voice information acquired by the voice information acquisition unit and the second reference information, and at least the first difference information and the second difference information.
- An information processing apparatus comprising: a presentation information generation unit that generates presentation information corresponding to any one of them.
- An information processing apparatus further includes a visual target identification unit that identifies an object visually recognized by the work learner with reference to the face information, and the difference information derivation unit identifies the visual identification target. It is preferable to derive the first difference information with reference to the visual recognition target specified by the section.
- the presentation information generation unit may be configured such that, when a target visually recognized by the work learner is different from a target indicated by the first reference information, the first reference information. It is preferable to generate the presentation information in which the target indicated by is highlighted.
- the presentation information generation unit generate presentation information according to a difference in sound indicated by the second difference information.
- the presentation information generation unit calculates a score according to the first difference information and the second difference information, and includes the calculated score in the presentation information. It is preferable.
- the work information learner may further include a motion information acquisition unit that acquires motion information indicating a motion of at least a part of the body of the work learner, and the difference information derivation unit may include the motion information and It is preferable that the presentation information generated by the presentation information generation unit that derives the third difference information indicating the difference from the third reference information includes information according to the third difference information.
- a presentation system is a presentation system including the above-described information processing device and a head mounted display, wherein the head mounted display images at least a part of a face of the work learner.
- the present invention is a presentation system including an imaging unit, a sound collection unit that collects the voice of the work learner, and a presentation unit that presents the presentation information.
- control unit 111 face information acquisition unit 112 state detection unit 113 visual recognition target identification unit 114 voice information acquisition unit 115 motion information acquisition unit 116 decision information identification unit 117 learner information acquisition unit 118 difference information derivation unit 119 presentation Information generation unit 130 Communication unit 140 Storage unit 200 Head mounted display 210 Camera 220 Microphone 230 Motion sensor 240 Speaker 250 Control unit 260 Communication unit 270 Display 300 Wearable interface 310 Motion sensor 320 Button 400 Information management server 500 Display unit
Landscapes
- Engineering & Computer Science (AREA)
- Business, Economics & Management (AREA)
- Physics & Mathematics (AREA)
- General Physics & Mathematics (AREA)
- Theoretical Computer Science (AREA)
- Educational Administration (AREA)
- Educational Technology (AREA)
- Multimedia (AREA)
- Entrepreneurship & Innovation (AREA)
- Signal Processing (AREA)
- Computational Linguistics (AREA)
- Health & Medical Sciences (AREA)
- Audiology, Speech & Language Pathology (AREA)
- Human Computer Interaction (AREA)
- Acoustics & Sound (AREA)
- Electrically Operated Instructional Devices (AREA)
- Studio Devices (AREA)
- User Interface Of Digital Computer (AREA)
Abstract
接客作業に関する作業学習者の学習を支援することのできる情報処理装置を実現すること。接客作業を学習する作業学習者の顔の少なくとも一部の情報を含む顔情報を取得する顔情報取得部(111)と、作業学習者による発話の情報を含む音声情報を取得する音声情報取得部(114)と、顔情報取得部(111)が取得した顔情報が示す顔の少なくとも一部の状態と第1の参照情報との差異を示す第1の差異情報、及び、音声情報取得部(114)が取得した音声情報と第2の参照情報との差異を示す第2の差異情報を導出する差異情報導出部(118)と、第1の差異情報及び第2の差異情報の少なくとも何れかに応じた提示情報を生成する提示情報生成部(119)とを備えている情報処理装置(100)。
Description
本発明は情報処理装置、情報処理方法、提示システム、及び情報処理プログラムに関する。
近年、作業者が作業内容を習得することを支援するシステムが開発されている。例えば、特許文献1には、画像情報に基づき、模範作業者と学習作業者との視線又は作業動作の違いを表示する作業教育システムが開示されている。
一方で、接客作業等においては、画像情報のみを用いる上述の従来技術では、作業内容の習得を適切に支援することができないという問題がある。
本発明の一態様は、接客作業に関する作業学習者の学習を支援することのできる情報処理装置を実現することにある。
上記の課題を解決するために、本発明の一態様に係る情報処理装置は、接客作業を学習する作業学習者の顔の少なくとも一部の情報を含む顔情報を取得する顔情報取得部と、前記作業学習者による発話の情報を含む音声情報を取得する音声情報取得部と、前記顔情報取得部が取得した顔情報が示す顔の少なくとも一部の状態と第1の参照情報との差異を示す第1の差異情報、及び、前記音声情報取得部が取得した音声情報と第2の参照情報との差異を示す第2の差異情報を導出する差異情報導出部と、前記第1の差異情報及び前記第2の差異情報の少なくとも何れかに応じた提示情報を生成する提示情報生成部とを備えていることを特徴とする。
本発明の一態様によれば、接客作業に関する作業学習者の学習を支援することのできる情報処理装置を実現することができる。
以下、本発明の一実施形態について、詳細に説明する。以下の特定の項目(実施形態)における構成について、それが他の項目で説明されている構成と同じである場合は、説明を省略する場合がある。また、説明の便宜上、各項目に示した部材と同一の機能を有する部材については、同一の符号を付し、適宜その説明を省略する。
1.提示システム
本実施形態に係る提示システム800は、接客作業を学習する作業学習者に対して学習支援を行う。学習支援装置の形態としては、例えばVR等を用いた体験的な学習装置が挙げられる。本実施形態に係る提示システム800は、作業学習者(例えば、新米アルバイト。以下、単に学習者と記載することがある)の情報と、予め記憶されている模範作業者(例えば、ベテラン接客者)の情報(「参照情報」とも呼ぶ)との差異(「差異情報」とも呼ぶ)を、提示情報として学習者へ提示することで、作業学習者に対して、自立的かつ体験的な学習を支援することが可能である。以下においては、接客が必要とされる飲食店等で働く学習者が接客作業を学習する状況において提示システム800を用いる場合を例に挙げて説明する。
本実施形態に係る提示システム800は、接客作業を学習する作業学習者に対して学習支援を行う。学習支援装置の形態としては、例えばVR等を用いた体験的な学習装置が挙げられる。本実施形態に係る提示システム800は、作業学習者(例えば、新米アルバイト。以下、単に学習者と記載することがある)の情報と、予め記憶されている模範作業者(例えば、ベテラン接客者)の情報(「参照情報」とも呼ぶ)との差異(「差異情報」とも呼ぶ)を、提示情報として学習者へ提示することで、作業学習者に対して、自立的かつ体験的な学習を支援することが可能である。以下においては、接客が必要とされる飲食店等で働く学習者が接客作業を学習する状況において提示システム800を用いる場合を例に挙げて説明する。
学習者の情報及び参照情報は、例えば、視認する対象及び視認する対象への集中度、発話内容及び声のトーン及び動作等を含む。
図1は、本発明の一実施形態に係る提示システムの構成要素を示すブロック図である。図1に示すように、本実施形態に係る提示システム800は、情報処理装置100、ヘッドマウントディスプレイ200、装着型インターフェース300、情報管理サーバ400及び表示部500を備えている。このような構成により、本実施形態に係る提示システム800は、学習者に対して学習支援を行うことができる。
<ヘッドマウントディスプレイ>
図1に示すように、ヘッドマウントディスプレイ200は、学習者の顔の少なくとも一部を撮像するカメラ210(「撮像部」とも呼ぶ)、学習者の発話音声を集音するマイク220(「集音部」とも呼ぶ)、スピーカー240及びディスプレイ270(いずれも「提示部」と呼ぶことがある)、動きセンサ230、制御部250及び通信部260を備えている。
図1に示すように、ヘッドマウントディスプレイ200は、学習者の顔の少なくとも一部を撮像するカメラ210(「撮像部」とも呼ぶ)、学習者の発話音声を集音するマイク220(「集音部」とも呼ぶ)、スピーカー240及びディスプレイ270(いずれも「提示部」と呼ぶことがある)、動きセンサ230、制御部250及び通信部260を備えている。
ヘッドマウントディスプレイ200の制御部250は、ヘッドマウントディスプレイ200の各部を統括的に制御するものである。制御部250の各機能、及びヘッドマウントディスプレイ200に含まれる全ての機能は、例えば、記憶部(図示せず)等に記憶されたプログラムを、CPUが実行することによって実現されてもよい。
通信部260は、制御部250の制御を受けて、情報処理装置100と通信する。通信の形態は、特に限定されることなく、Bluetooth(登録商標)、WiFi(登録商標)、その他の近距離無線通信技術による通信であってもよいし、他の通信であってもよい。
カメラ210は、学習者の顔の画像を顔情報として取得する。カメラ210は、学習者の身体の少なくとも一部の画像を顔の画像と同時に取得してもよい。マイク220は、学習者の発する声を音声情報として取得する。動きセンサ230は、例えば加速度センサであり、学習者の動きを動き情報として取得する。
スピーカー240は、通信部260を介してヘッドマウントディスプレイ200に入力された音を出力する。ディスプレイ270は、通信部260を介してヘッドマウントディスプレイ200に入力された画像を出力する。ディスプレイ270が出力する画像は、仮想空間を表示するものであってよく、ディスプレイ270の表示例として図2に示す画像が挙げられる。図2は、本発明の一実施形態に係るヘッドマウントディスプレイのディスプレイが表示する画像の一例を示す図である。図2に示す画像200Aは、店員である学習者の視点から見た飲食店内の様子であり、画像200Aには、客、自分の手元、自分以外の店員、及びテーブル等が表示されている。
また、図3は、視認対象特定部又は意思決定情報特定部が特定した学習者の視認対象、発話(発話内容及び声のトーン)、動作及び集中度(瞬き、瞳孔の状態、視線停留時間及び表情)の一例を示す表である。
<装着型インターフェース>
図1に示すように、提示システム800は、装着型インターフェース300を備えている。一例において、装着型インターフェース300は、動きセンサ310及びボタン320を備えおり、学習者が行う操作を情報処理装置100に入力する。学習者が行う操作としては、一例において、動きセンサ310を上げたり下げたりする操作、及びボタン320を押下する操作等が挙げられる。
図1に示すように、提示システム800は、装着型インターフェース300を備えている。一例において、装着型インターフェース300は、動きセンサ310及びボタン320を備えおり、学習者が行う操作を情報処理装置100に入力する。学習者が行う操作としては、一例において、動きセンサ310を上げたり下げたりする操作、及びボタン320を押下する操作等が挙げられる。
一例において、提示システム800は、情報処理装置100における動き情報取得部115が取得する学習者の動き情報に、学習者の手の動き等に関するより詳細な情報を含めることができる。本実施形態における学習者の手の動きの例としては、水の入ったコップを持ったりテーブルに置いたりする動き、及び食事の注文を取る動き等が挙げられる。
また、装着型インターフェース300を介して入力された学習者の手の動き等の情報は、マウントディスプレイ200におけるディスプレイ270が出力する画像において、学習者の手の動き等として反映させることができる。
動きセンサ310及びボタン320としては、公知のセンサ及びボタンを用いることができ、動きセンサ310は、例えば加速度センサでる。
<情報処理装置>
図1に示すように、本実施形態における情報処理装置100は、制御部110、記憶部140及び通信部130を備えている。
図1に示すように、本実施形態における情報処理装置100は、制御部110、記憶部140及び通信部130を備えている。
本実施形態における情報処理装置100の制御部110は、作業学習者の顔の少なくとも一部の情報を含む顔情報を取得する顔情報取得部111と、作業学習者による発話の情報を含む音声情報を取得する音声情報取得部114と、顔情報取得部111が取得した顔情報が示す顔の少なくとも一部の状態と記憶部140が記憶している情報(「第1の参照情報」とも呼ぶ)との差異を示す差異情報(「第1の差異情報」とも呼ぶ)、及び、音声情報取得部114が取得した音声情報と記憶部140が記憶している情報(「第2の参照情報」とも呼ぶ)との差異を示す差異情報(「第2の差異情報」とも呼ぶ)を導出する差異情報導出部118と、差異情報に応じた提示情報を生成する提示情報生成部119とを備えている。
情報処理装置100は、一例として、ローカルネットワーク又はグローバルネットワークに接続可能な端末装置(例えば、スマートフォン、タブレット、パソコン、又はテレビジョン受像機等)に実装される。
〔制御部〕
図1に示すように、本実施形態における情報処理装置100の制御部110は、顔情報取得部111、状態検出部112、視認対象特定部113、音声情報取得部114、動き情報取得部115、意思決定情報特定部116、学習者情報取得部117、差異情報導出部118及び提示情報生成部119を備えている。制御部110は、情報処理装置100の各部を統括的に制御する。制御部110の各機能、及び情報処理装置100に含まれる全ての機能は、例えば、記憶部(図示せず)等に記憶されたプログラムを、CPUが実行することによって実現されてもよい。
図1に示すように、本実施形態における情報処理装置100の制御部110は、顔情報取得部111、状態検出部112、視認対象特定部113、音声情報取得部114、動き情報取得部115、意思決定情報特定部116、学習者情報取得部117、差異情報導出部118及び提示情報生成部119を備えている。制御部110は、情報処理装置100の各部を統括的に制御する。制御部110の各機能、及び情報処理装置100に含まれる全ての機能は、例えば、記憶部(図示せず)等に記憶されたプログラムを、CPUが実行することによって実現されてもよい。
(顔情報取得部)
顔情報取得部111は、各時点において、学習者の顔の少なくとも一部の情報を含む顔情報を取得する。顔情報取得部111は、例えば、ヘッドマウントディスプレイ200が備えるカメラ210から取得した画像から、学習者の顔情報を取得することができる。学習者の顔情報とは、顔の特徴量を示す情報である。顔の特徴量とは、例えば、顔の各部位(例えば、目、鼻、口及び眉等)の位置を示す位置情報、形状を示す形状情報及び大きさを示す大きさ情報等を指す。
顔情報取得部111は、各時点において、学習者の顔の少なくとも一部の情報を含む顔情報を取得する。顔情報取得部111は、例えば、ヘッドマウントディスプレイ200が備えるカメラ210から取得した画像から、学習者の顔情報を取得することができる。学習者の顔情報とは、顔の特徴量を示す情報である。顔の特徴量とは、例えば、顔の各部位(例えば、目、鼻、口及び眉等)の位置を示す位置情報、形状を示す形状情報及び大きさを示す大きさ情報等を指す。
特に、目の情報からは、学習者が視認する対象を特定することができるため、特に有用である。目の情報としては、例えば目頭及び目尻の端点、虹彩及び瞳孔等のエッジ等が挙げられる。また、顔情報取得部111は、撮像部から取得した画像に、ノイズ低減、エッジ強調等の補正処理を適宜行ってもよい。顔情報取得部111は、抽出した顔情報を状態検出部112に送信する。
(状態検出部)
状態検出部112は、顔情報取得部111が取得した学習者の顔情報から上記学習者の状態を検出する。例えば、状態検出部112は、各時点における学習者が視認しているオブジェクト(図3における「視認対象」)、各時点における1分あたりの瞬きの回数(図3における「瞬き」)、各時点における瞳孔の開閉(図3における「瞳孔の状態」)、視認対象を視認している時間(図3における「視線停留時間」)、又は表情(図3における表情)等を検出する。
状態検出部112は、顔情報取得部111が取得した学習者の顔情報から上記学習者の状態を検出する。例えば、状態検出部112は、各時点における学習者が視認しているオブジェクト(図3における「視認対象」)、各時点における1分あたりの瞬きの回数(図3における「瞬き」)、各時点における瞳孔の開閉(図3における「瞳孔の状態」)、視認対象を視認している時間(図3における「視線停留時間」)、又は表情(図3における表情)等を検出する。
状態検出部112は、顔情報取得部111が抽出した顔情報に基づき、学習者の状態を検出する。状態検出部112は、学習者の状態を検出した後、該検出結果を視認対象特定部113へ送信する。
状態検出部112は、一例として、顔情報取得部111が取得した顔の特徴量である顔の各部位(例えば、目、鼻、口、頬及び眉等)の位置を示す位置情報、形状を示す形状情報及び大きさを示す大きさ情報等を参照し、学習者の状態として、例えば、上記学習者の視認対象、瞳孔の状態、瞬きの回数、眉の動き、頬の動き、瞼の動き、唇の動き及び顎の動きのうち少なくとも1つを検出する。
このように、状態検出部を備えることで、情報処理装置は、学習者の状態を好適に検出することできる。
視認対象の検出方法としては、特に限定されないが、情報処理装置100に、点光源(図示せず)を設け、点光源からの光の角膜反射像を撮像部で所定時間撮影することにより、学習者の視認対象を検出する方法が挙げられる。点光源の種類は特に限定されず、可視光、赤外光が挙げられるが、例えば赤外線LEDを用いることで、学習者に不快感を与えることなく、視認対象を検出することができる。
学習者の状態として、視認対象の他には、集中度を挙げることができる。一般的に、人間は、集中している場合、低い頻度で安定した間隔で瞬きしており、瞳孔が開く傾向にあるため、瞬きの回数及び瞳孔の状態(サイズ)を検出することで、学習者の集中度を評価することができる。例えば、瞬きの回数を所定時間検出し、所定時間内で瞬きが安定した間隔で行われている場合、学習者がある対象を注視している可能性が高いといえる。また、瞳孔のサイズを所定時間検出し、所定時間内で瞳孔が大きくなっている時間が長い場合は、学習者がある対象を注視している可能性が高いといえる。
瞬きの回数を検出する方法としては、特に限定されないが、例えば、赤外光を学習者の目に対して照射し、開眼時と、閉眼時との赤外光量反射量の差を検出する方法等が挙げられる。
瞳孔の状態を検出する方法としては、特に限定されないが、例えば、ハフ変換を利用して、目の画像から円形の瞳孔を検出する方法等が挙げられる。瞳孔のサイズに関して、閾値を設定し、瞳孔のサイズが閾値以上である場合は「開」、瞳孔のサイズが閾値未満である場合は「閉」として評価してもよい。
また、集中度の評価として、視認対象が所定時間以上変化しないことを検出することも可能である。例えば、上述した技術を用いて学習者の視認対象を検出して、学習者がオブジェクトを視認している時間(図3における「視線停留時間」)を計測することができる。
状態検出部112は、学習者の視認対象、瞳孔の状態及び瞬きの回数、眉の動き、瞼の動き、頬の動き、鼻の動き、唇の動き及び顎の動きのうち少なくとも1つを検出すればよいが、これらを組み合わせることが好ましい。このように検出方法を組み合わせることで、状態検出部112は、あるオブジェクトを視認しているときの学習者の集中度を好適に評価することができる。
目の状態以外では、例えば、眉の内側を持ち上げるか、外側を上げるか等の眉の動き、上瞼を上げる、瞼を緊張させる等の瞼の動き、鼻に皺を寄せる等の鼻の動き、上唇を持ち上げる、唇をすぼめる等の唇の動き、頬を持ち上げる等の頬の動き、顎を下げる等の顎の動き等の顔の各部位の状態が挙げられる。学習者の状態として、顔の複数の部位の状態を組み合わせてもよい。
状態検出部112は、学習者の顔の表情から学習者の機嫌を判断することによって学習者の集中度を算出してもよい。学習者の機嫌に係る状態は、例えば、上述したように、顔の特徴量を参照し、学習者の状態として、例えば、学習者の視認対象、瞳孔の状態、瞬きの回数、眉の動き、頬の動き、瞼の動き、唇の動き及び顎の動きのうち少なくとも1つを検出し、検出した学習者の顔の各部位の状態に基づいて判断することができる。
学習者の集中度を顔の表情から判断する方法としては、例えば、眉が上方向に動いた場合には、視認対象をより注視しているため集中していると判断することができる。また、例えば、人の顔を視認しているときに頬が上方向に動いた場合には、相手に対して表情を作っているとして、視認対象に集中していると判断することができる。
また、学習者の表情を検出させる場合、状態検出部112は、学習者の表情に関する情報を機械学習により算出することもできる。表情に関する情報を取得するための学習処理の具体的な構成は本実施形態を限定するものではないが、例えば、以下のような機械学習的手法の何れか又はそれらの組み合わせを用いることができる。
・サポートベクターマシン(SVM: Support Vector Machine)
・クラスタリング(Clustering)
・帰納論理プログラミング(ILP: Inductive Logic Programming)
・遺伝的アルゴリズム(GP: Genetic Programming)
・ベイジアンネットワーク(BN: Baysian Network)
・ニューラルネットワーク(NN: Neural Network)
ニューラルネットワークを用いる場合、データをニューラルネットワークへのインプット用に予め加工して用いるとよい。このような加工には、データの1次元的配列化、又は多次元的配列化に加え、例えば、データアーギュメンテーション(Deta Argumentation)等の手法を用いることができる。
・クラスタリング(Clustering)
・帰納論理プログラミング(ILP: Inductive Logic Programming)
・遺伝的アルゴリズム(GP: Genetic Programming)
・ベイジアンネットワーク(BN: Baysian Network)
・ニューラルネットワーク(NN: Neural Network)
ニューラルネットワークを用いる場合、データをニューラルネットワークへのインプット用に予め加工して用いるとよい。このような加工には、データの1次元的配列化、又は多次元的配列化に加え、例えば、データアーギュメンテーション(Deta Argumentation)等の手法を用いることができる。
また、ニューラルネットワークを用いる場合、畳み込み処理を含む畳み込みニューラルネットワーク(CNN: Convolutional Neural Network)を用いてもよい。より具体的には、ニューラルネットワークに含まれる1又は複数の層(レイヤ)として、畳み込み演算を行う畳み込み層を設け、当該層に入力される入力データに対してフィルタ演算(積和演算)を行う構成としてもよい。またフィルタ演算を行う際には、パディング等の処理を併用したり、適宜設定されたストライド幅を採用したりしてもよい。
また、ニューラルネットワークとして、数十~数千層に至る多層型又は超多層型のニューラルネットワークを用いてもよい。
(視認対象特定部)
視認対象特定部113は、顔情報取得部111が取得した顔情報、又は状態検出部112から取得した検出結果を参照して、学習者が視認する対象を特定する。視認する対象(視認対象)は、人であっても物体であってもよい。
視認対象特定部113は、顔情報取得部111が取得した顔情報、又は状態検出部112から取得した検出結果を参照して、学習者が視認する対象を特定する。視認する対象(視認対象)は、人であっても物体であってもよい。
また、視認対象特定部113は、状態検出部112から取得した検出結果に基づき、作業学習者の集中度を特定する。
このように、情報処理装置100は、視認対象特定部113を備えることで、学習者が視認している対象及び集中度を正確に判定することができる。
視認対象特定部113の具体的な処理について説明する。視認対象特定部113は、状態検出部112から取得した検出結果から、学習者の視線の先の位置座標を判定することで、視認対象を特定する。例えば、視認対象特定部113は、図3に示すように、学習者の視線の先の位置座標が客の足元の座標内にあると特定する。また、視線の情報に加えて、(状態検出部)で記載したように、瞳孔の状態、瞬きの回数、眉の動き、瞼の動き、頬の動き、鼻の動き、唇の動き及び顎の動きの検出結果を参照することで、学習者がどのオブジェクトを集中して視認しているかをさらに好適に特定することができる。
視認対象特定部113は、学習者がどのオブジェクトを集中して視認しているかの特定を、(状態検出部)に記載の機械学習的手法を用いて特定してもよい。
視認対象特定部113は、特定した結果を差異情報導出部118へ送信する。
(音声情報取得部)
音声情報取得部114は、各時点における学習者による発話の情報を含む音声情報を取得する。音声情報取得部114は、例えば、ヘッドマウントディスプレイ200のマイクから学習者の音声情報を取得することができる。学習者の音声情報として、例えば、声の周波数、声の大きさ等を取得する。音声情報の特定には、公知の音声認識技術を用いることができる。
音声情報取得部114は、各時点における学習者による発話の情報を含む音声情報を取得する。音声情報取得部114は、例えば、ヘッドマウントディスプレイ200のマイクから学習者の音声情報を取得することができる。学習者の音声情報として、例えば、声の周波数、声の大きさ等を取得する。音声情報の特定には、公知の音声認識技術を用いることができる。
音声情報取得部114が取得した音声情報は、意思決定情報特定部116に入力される。
(動き情報取得部)
動き情報取得部115は、各時点における作業学習者の体の少なくとも一部の動きを示す動き情報を取得する。動き情報取得部115は、例えば、図1に示すように、ヘッドマウントディスプレイ200動きセンサ230、又は装着型インターフェース300の動きセンサ310又はボタン320から取得する。また、ヘッドマウントディスプレイ200のカメラ210が学習の身体を撮影した撮影画像から取得する。
動き情報取得部115は、各時点における作業学習者の体の少なくとも一部の動きを示す動き情報を取得する。動き情報取得部115は、例えば、図1に示すように、ヘッドマウントディスプレイ200動きセンサ230、又は装着型インターフェース300の動きセンサ310又はボタン320から取得する。また、ヘッドマウントディスプレイ200のカメラ210が学習の身体を撮影した撮影画像から取得する。
動き情報取得部115が取得した動き情報は、意思決定情報特定部116に入力される。
(意思決定情報特定部)
意思決定情報特定部116は、音声情報取得部114が取得した音声情報及び動き情報取得部115が取得した動き情報をもとに、各時点において学習者の意思を示す意思決定情報を特定する。本実施形態において、意思決定情報には、一例として、学習者の発話内容、声のトーン及び行動の内容が含まれる。
意思決定情報特定部116は、音声情報取得部114が取得した音声情報及び動き情報取得部115が取得した動き情報をもとに、各時点において学習者の意思を示す意思決定情報を特定する。本実施形態において、意思決定情報には、一例として、学習者の発話内容、声のトーン及び行動の内容が含まれる。
一例として、意思決定情報特定部116は、学習者が発した発話内容及び声のトーンを特定する。例えば、図3に示すように、意思決定情報特定部116は、発話内容を、「いらっしゃいませ」又は「ご注文は何に致しますか」のように発話内容を示すテキストとして特定し、声のトーンを、一例として高中低のいずれかとして特定する。
また、意思決定情報特定部116は、動き情報取得部115が取得した動き情報を参照して、各時点において学習者が行った動作を特定する。例えば、意思決定情報特定部116は、図3に示すように、動作を「おじぎ」又は「水を置く」等のように特定する。
なお、意思決定情報特定部116は、(状態検出部)に記載の機械学習的手法を用いて意思決定情報を特定してもよい。
意思決定情報特定部116が特定した意思決定情報は、差異情報導出部118に入力される。
(差異情報導出部)
差異情報導出部118は、視認対象特定部113から取得した視認対象、意思決定情報特定部116から取得した意思決定情報、及び集中度を参照して、記憶部140に記憶されている情報との差異を差異情報として導出する。差異情報の導出の一例を図3~5を用いて説明する。
差異情報導出部118は、視認対象特定部113から取得した視認対象、意思決定情報特定部116から取得した意思決定情報、及び集中度を参照して、記憶部140に記憶されている情報との差異を差異情報として導出する。差異情報の導出の一例を図3~5を用いて説明する。
図3は、視認対象特定部113及び意思決定情報特定部116が特定した学習者のデータである。図3は、学習者のデータの一例として、オブジェクトを視認したタイミング、視認対象、発話内容、声のトーン、動作及び集中度を示している。
図4は、記憶部140に予め記憶されているベテラン接客者のデータの一例を示す表である。図4は、ベテラン接客者のデータの一例として、オブジェクトを視認したタイミング、視認対象、発話内容、声のトーン、動作及び集中度を示している。図4における「第1の参照情報」、「第2の参照情報」及び「第3の参照情報」は、それぞれ、ベテラン接客者の視認対象、発話及び動作に対応する。
情報処理装置100は、一例において、学習者又はベテラン接客者がオブジェクトを視認したタイミングから所定時間内に行われる一連の意思決定(発話及び動作等)を一つのまとまり(図3~5における「イベント」)として扱う。図3~5に示すように、一例において、イベントには、タイミング、視認対象、発話、動作、及び集中度が含まれ、それぞれのイベントはIDによって識別可能である。図3~5に示すように、学習者におけるイベントと、ベテラン接客者におけるイベントとは、一例としてイベントIDを用いて対応させることができる。本明細書においては、例えば、図3に示すように、学習者のデータにおけるイベントID1におけるデータは、00;00;03のタイミングにおいて視認した視認対象及びオブジェクトを視認してから一定時間内に行われる意思決定を含む。
また、図3及び4における「タイミング」のデータは、一例として、オブジェクトを視認した時点を示すデータであるが、発話のタイミング又は動作のタイミング、ならびにオブジェクトを視認した時点と意思決定(発話及び動作)が終了した時点との間の中間の時点を等であってもよく、また、これらを複数組み合わせたものをデータとしてもよい(図示せず)。さらに、一例において、差異情報導出部118は、視認対象特定部113と意思決定情報特定部116とからそれぞれ取得したタイミングの情報を参照することによって、視認から意思決定(発話又は動作)までの経過時間を算出し、データとして含めてもよい(図示せず)。
差異情報導出部118は、図3及び4にそれぞれ示した学習者のデータ及びベテラン接客者のデータに基づいて、イベントIDごとに差異情報を導出する。図5は、差異情報導出部118が導出した差異情報のデータの一例を示す表である。図5において、差異情報は、それぞれのイベントIDごとに導出された情報であり、対応するイベントIDにおける、オブジェクトを視認したタイミング、視認対象、発話内容、声のトーン、動作及び集中度の差異を示す。
図5における「第1の差異情報」、「第2の差異情報」及び「第3の差異情報」は、それぞれ、学習者とベテランとにおける視認対象、発話及び動作の差異に対応する。
差異情報は、図3に示す学習者のデータと図4に示すベテラン接客者のデータとの「ずれ」の情報(表中の「+/-」又は「+/-」を用いた(学習者-ベテラン接客者)の値によって示される定量的な情報)、又はベテラン接客者のデータに一致するかどうかの情報(表中の「○/×」によって示される定性的な情報)である。一例において、図5に示したように、学習者のデータとベテラン接客者とのデータが一致しない場合は、差異情報導出部118が導出する差異情報は、ベテラン接客者のデータ(表中の「正解」)を含むものであってもよい。
一例において、学習者のデータを示す図3中のイベントID1によれば、タイミング「00;00;03」において、視認対象特定部113は、学習者の視認対象が「客の足元」であることを特定している。また、図4中のイベントID1に示す、記憶部140に予め記憶されている情報であるベテラン接客者の情報によれば、タイミング「00;00;03」におけるベテラン接客者の視認対象は「客の目」である。差異情報導出部118は、両データに基づいて、学習者の視認対象はベテラン接客者と一致しないと判断し、図5のイベントID1に示すように、視認対象の項目に関する差異情報として「×」を導出する。さらに、差異情報導出部118は、ベテラン接客者の視認対象である「客の目」を正解として導出する。
また、図3のイベントID1に示すように、タイミング「00;00;03」において、意思決定情報特定部116は、学習者が「いらっしゃいませ」と発話し、「おじぎ」の動作を行っていることを特定している。また、図4のイベントID1に示すように、記憶部140に予め記憶されている情報によれば、ベテラン接客者は、タイミング「00;00;03」において「いらっしゃいませ」と発話し、「おじぎ」の動作を行っている。差異情報導出部118は、両データに基づいて、学習者の発話内容及び動作はベテラン接客者と一致すると判断し、図5のイベントID1に示すように、発話内容の項目と動作の項目に関する差異情報として「○」を導出する。
そして、図3のイベントID1に示すように、タイミング「00;00;03」において、例えば、意思決定情報特定部116は、学習者の声のトーンが「中」であることを特定している。また、図4のイベントID1に示すように、記憶部140に予め記憶されている情報によれば、タイミング「00;00;03」におけるベテラン接客者の声のトーンは「高」である。差異情報導出部118は、両データに基づいて、学習者の声のトーンはベテラン接客者とより低いと判断し、図5のイベントID1に示すように、声のトーンの項目に関する差異情報として「-」を導出する。
さらに、タイミング「00;00;03」において、視認対象特定部113は、図3のイベントID1に示すように、学習者の瞬き(回/分)が「5」であることを特定している。また、図4のイベントID1に示すように、記憶部140に予め記憶されている情報によれば、タイミング「00;00;03」におけるベテラン接客者の瞬きは「10」である。差異情報導出部118は、両データに基づいて、学習者の瞬きはベテラン接客者より5少ないと判断し、図5のイベントID1に示すように、瞬きの項目に関する差異情報として「-5」を導出する。
タイミング「00;00;05」において、視認対象特定部113は、図3のイベントID2に示すように、学習者の瞳孔の状態が「閉」であることを特定している。また、図4のイベントID2に示すように、記憶部140に予め記憶されている情報によれば、タイミング「00;00;05」におけるベテラン接客者の瞬きは「開」である。差異情報導出部118は、両データに基づいて、学習者の瞳孔の状態はベテラン接客者と一致しないと判断し、図5のイベントID2に示すように、瞳孔の状態の項目に関する差異情報として「×」を導出する。
タイミング「00;00;05」において、視認対象特定部113は、図3のイベントID2に示すように、学習者の視線停留時間(秒)が「0.0」であることを特定している。また、図4のイベントID2に示すように、記憶部140に予め記憶されている情報によれば、タイミング「00;00;05」におけるベテラン接客者の視線停留時間は「0.8」である。差異情報導出部118は、両データに基づいて、学習者の視線停留時間はベテラン接客者より0.8少ないと判断し、図5のイベントID2に示すように、視線停留時間の項目に関する差異情報として「-0.8」を導出する。
また、タイミング「00;00;05」において、視認対象特定部113は、図3のイベントID2に示すように、学習者の表情について、眉の動き及び頬の動きが検出されていないことを、「-」として特定している。一方、図4のイベントID2に示すように、記憶部140に予め記憶されている情報によれば、タイミング「00;00;05」におけるベテラン接客者の表情は、眉の動きが「-」、頬の動きが「上方向」である。この場合、差異情報導出部118は、両データに基づいて、学習者の眉の動きはベテラン接客者と一致していると判断し、図5のイベントID2に示すように、眉の動きの項目に関する差異情報として「○」を導出する。また、差異情報導出部118は、両データに基づいて、学習者の頬の動きはベテラン接客者と一致しないと判断し、図5のイベントID2に示すように、頬の動きの項目に関する差異情報として「×」を導出する。
また、視認対象特定部113及び意思決定情報特定部116によれば、学習者は、図3のイベントID3に示すように、タイミング「00;00;40」において、「客のテーブル」を視認し、「ご注文は何に致しますか」と発話し、「水を置く」動作を行っている。一方、図4のイベントID3に示すように、記憶部140に予め記憶されている情報によれば、「客のテーブル」を視認し、「ご注文は何に致しますか」と発話し、「水を置く」動作を行うタイミングは「00;00;33」である。差異情報導出部118は、両データに基づいて、学習者の一連のデータのまとまりは、ベテラン接客者より00;00;07遅いと判断し、図5のイベントID3に示すように、タイミングの項目に関する差異情報として「+00;00;07」を導出する。
なお、図4のイベントID4に示すように、記憶部140に予め記憶されている情報によれば、ベテラン接客者は、タイミング「00;00;47」において「自分の手元」を視認し、「ご注文を確認いたします」と発話し、「注文内容を復唱」という動作を行っている。その一方で、図3に示すように、視認対象特定部113及び意思決定情報特定部116はいずれもタイミング「00;00;47」において学習者の視認対象及び意思決定情報を特定しておらず、また、タイミングによらず、「自分の手元」の視認、「ご注文を確認いたします」という発話及び「注文内容を復唱」という動作のいずれも特定されていない。このような場合、差異情報導出部118は、両データに基づいて、学習者のデータ中にベテラン接客者のデータに対応するデータが存在しないと判断し、図5の600に示すように、差異情報として「データ無」、「×」及び正解となる情報を導出する。
図5の表から、学習者は、客の目を見ておらず、注文を取るタイミングが遅い傾向にあることが判定される。また、図5の表から、学習者は、客に対して注文の確認をしていないことが判定される。
差異情報導出部118は、(状態検出部)に記載の機械学習的手法を用いて差異情報を導出してもよい。
差異情報導出部118で導出された差異情報は、提示情報生成部119に入力される。
(学習者情報取得部)
学習者情報取得部117は、例えば、情報管理サーバ400が管理する学習者の情報を学習者情報として取得する。一例として、学習者の情報は、学習者の属性を示す属性情報と、他の学習者と対象学習者とを識別するための学習者識別情報を含む。学習者の属性情報とは、例えば、学習者の年齢、性別、職歴及び本提示システム800を用いたこれまでの学習期間等である。また、学習者識別情報とは、例えば、学習者のID又は学習者のメールアドレス等である。
学習者情報取得部117は、例えば、情報管理サーバ400が管理する学習者の情報を学習者情報として取得する。一例として、学習者の情報は、学習者の属性を示す属性情報と、他の学習者と対象学習者とを識別するための学習者識別情報を含む。学習者の属性情報とは、例えば、学習者の年齢、性別、職歴及び本提示システム800を用いたこれまでの学習期間等である。また、学習者識別情報とは、例えば、学習者のID又は学習者のメールアドレス等である。
このように、学習者の情報が、属性情報と学習者識別情報とを含むことで、後述する提示情報生成部119は、個々の学習者の属性に応じて、各学習者にとって効果的な提示情報を提示することができる。詳細は(提示情報生成部)の項目で述べる。
学習者情報取得部117は、情報管理サーバ400から取得した学習者情報を提示情報生成部119に入力する。
(提示情報生成部)
提示情報生成部119は、差異情報導出部118が導出した差異情報(視認対象特定部113が顔情報から特定する視認対象及び集中度、意思決定情報特定部116が音声情報から特定する発話及び動き情報から特定する動作に基づいて導出される)に基づいて提示情報を生成する。一例において、提示情報生成部119が生成する提示情報は画像である。
提示情報生成部119は、差異情報導出部118が導出した差異情報(視認対象特定部113が顔情報から特定する視認対象及び集中度、意思決定情報特定部116が音声情報から特定する発話及び動き情報から特定する動作に基づいて導出される)に基づいて提示情報を生成する。一例において、提示情報生成部119が生成する提示情報は画像である。
提示情報生成部119は、学習者が視認する対象が、ベテラン接客者が視認対象と異なる場合に、ベテラン接客者が視認する対象を強調表示した提示情報を生成する。図8は、提示情報生成部119が生成した提示情報の一例を示す図である。図8に示す画像200Cは、学習者が視認すべき対象を強調表示した画像であり、図2に示した画像200Aに記号として矢印ポインタ200C1が加えられている。図8においては、矢印ポインタ200C1は矢印の形をしているが、任意の形状及び色であってよい。
また、視認対象の強調表示の例としては、他にも、視認対象を枠囲みする、視認対象の周辺の背景色を変更する、視認対象を他のイメージよりも大きく表示する、及び視認対象の画像をポップアップウィンドウとして表示する等が挙げられる。
提示情報生成部119が生成する提示情報は常に強調表示を含んでいてもよいし、例えば、差異情報導出部118が導出した差異情報に応じて、適宜、強調の有無及び度合いを変更してもよい。
また、提示情報生成部119は、差異情報導出部118が導出した差異情報に応じた点数を算出し、算出した点数を提示情報に含ませてもよい。
図7は、提示情報生成部119が生成した提示情報の一例を示す図である。図7に示す画像200Bは、テキストとして、指示ウィンドウ200B1及び点数ウィンドウ200B2を含んでいる。
画像200Bにおける指示ウィンドウ200B1は、学習者が行うべき発話内容及び動作のガイド示すテキストを表示するウィンドウである。ガイドの内容は、記憶部140に予め記憶されているベテラン接客者のデータに基づくものである。テキストは、図7に示したように、学習者が行うべき発話内容及び動作の全てを指示するものであってもよいし、例えば、「客がメニューから顔を上げました、どうしますか?」等のように学習者にヒントを与えるものであってもよい。
画像200Bにおける点数ウィンドウ200B2は、学習者の習熟度を示す点数を表示するウィンドウである。点数の算出方法としては、例えば、(i)一致又は不一致で判断した差異情報と、ずれの程度を判断した差異情報とで加点又は減点の方法を分けて、不一致の項目については所定の点数を減点し、ずれている項目についてはずれの程度に応じて減点する点数を変化させる方法、及び(ii)ずれの程度を判断した差異情報だけでなく、一致又は不一致で判断した差異情報についても、予め定めた範囲を逸脱していなければ(例えば、ベテラン接客者の視認対象が「客の目」であるのに対して学習者の視認対象が「客の鼻」であった、ベテラン接客者の発話内容が「ご注文は何に致しますか」であるのに対して、学習者の発話内容が「ご注文をお伺いいたします」であった等)、程度に応じて減点する点数を変化させる方法等が挙げられるが、特に限られない。
一例において、提示情報生成部119が生成する提示情報は音声を含む(図示せず)。音声としては、声であっても効果音であってもよい。一例において、声は、指示ウィンドウ200B1に表示されるテキストを読み上げるものである。また、効果音の例としては、差異情報の内容に応じて正解又は不正解を示す音(「ピンポン」又は「ブー」等)という音、及び視認対象の強調表示に伴って学習者に注意を促す音等が挙げられる。
提示情報生成部119は、提示情報を生成するにあたって、学習者情報取得部117が取得した学習者情報を参照する。学習者情報を参照することによって、提示情報生成部119は、個々の学習者の属性に応じて、各学習者が効果的に学習できるような提示情報を提示することができる。
例えば、本実施形態における学習者が接客業を全く経験したことがない場合には、提示情報生成部119は、視認対象をより強調表示した提示情報を生成したり、より具体的な内容のガイドを含む提示情報を生成したりする。また、例えば、学習者のこれまでの学習期間が所定期間より長い場合には、提示情報生成部119は、より厳しい条件で算出した学習者の習熟度を示す点数を含む提示情報を生成することができる。さらに、提示情報生成部119は、一例において、学習者が好きなアニメのキャラクター等の音声を含む提示情報を生成することができる。
提示情報生成部119は、生成した提示情報をヘッドマウントディスプレイ200へ送信する。また、提示情報生成部119は、提示情報を表示部500へ送信する。
<表示部>
図1に示すように、提示システム800は、表示部500を備えている。表示部500は、提示情報生成部119が生成した提示情報を、主に学習者を指導する指導者等向けに表示する。表示部500が表示する画像は、図3に示した学習者のデータを示す表、及び図5に示した差異情報を示す表を含んでいてよく、さらに、図4に示したベテラン接客者のデータを示す表を含んでいてもよい。また、表示部500が表示する画像は、ヘッドマウントディスプレイ200のディスプレイ270が表示する画像の一部を含んでいてもよい。
図1に示すように、提示システム800は、表示部500を備えている。表示部500は、提示情報生成部119が生成した提示情報を、主に学習者を指導する指導者等向けに表示する。表示部500が表示する画像は、図3に示した学習者のデータを示す表、及び図5に示した差異情報を示す表を含んでいてよく、さらに、図4に示したベテラン接客者のデータを示す表を含んでいてもよい。また、表示部500が表示する画像は、ヘッドマウントディスプレイ200のディスプレイ270が表示する画像の一部を含んでいてもよい。
2.提示システムの処理例
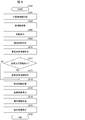
図6は、提示システム800の処理を示すフローチャートである。図6に基づいて提示システム800の処理について説明する。
図6は、提示システム800の処理を示すフローチャートである。図6に基づいて提示システム800の処理について説明する。
まず提示システムの使用を開始(ステップS100)し、処理を開始する。ステップS(以下、「ステップ」は省略する)102に進む。
S102では、情報処理装置100の制御部110における学習者情報取得部117が、学習者情報を取得する(学習者情報取得ステップ)。処理の詳細は、(学習者情報取得部)に記載の通りである。学習者情報取得部117は、学習者情報を提示情報生成部119に送信し、S104に進む。
S104では、顔情報取得部111が、学習者のヘッドマウントディスプレイ200におけるカメラ210から取得し、顔画像から顔の各部位を抽出する(顔情報取得ステップ)。処理の詳細は、(顔情報取得部)に記載の通りである。顔情報取得部111は、抽出した結果を状態検出部112に送信し、S106に進む。
S106では、状態検出部112が、学習者の視認対象、瞬き、瞳孔の状態、及び顔の各部位の状態を検出する(状態検出ステップ)。処理の詳細は(状態検出部)に記載の通りである。検出結果を視認対象特定部113に送信し、S108に進む。
S108では、視認対象特定部113が、学習者が視認する視認対象を特定する(視認対象特定ステップ)。処理の詳細は、(視認対象特定部)に記載の通りである。このとき、視認対象特定部113は、視認対象の特定と同時に、視認しているときの集中度を特定してもよい。視認対象特定部113は、特定した結果を、差異情報導出部118に送信し、S110に進む。
S110では、音声情報取得部114又は動き情報取得部115の少なくとも一方が、学習者の意思決定情報を、ヘッドマウントディスプレイ200等が備えるマイク220及び動きセンサ310等からそれぞれ取得する(意思決定情報取得ステップ)。処理の詳細は、(音声情報取得部)及び(動き情報取得部)に記載の通りである。S112に進む。
S112では、音声情報取得部114又は動き情報取得部115の少なくとも一方が、音声情報又は動き情報等(以下、「意思決定情報」ということがある)が取得されたかどうかを参照することによって、意思決定情報の有無を判定する。意思決定情報があった場合は、音声情報取得部114及び動き情報取得部115は、取得した意思決定情報を意思決定情報特定部116に送信し、S113に進む。また、意思決定情報がなかった場合はS114に進む。
S113では、意思決定情報特定部116が、学習者の発話内容、声のトーン及び動作等の意思決定情報を特定する(意思決定情報特定ステップ)。処理の詳細は(意思決定情報特定部)に記載の通りである。意思決定情報特定部116は、特定した結果を、差異情報導出部118に送信し、S114に進む。
S114では、差異情報導出部118が、記憶部140に予め記憶されているベテラン接客者の視認対象及び意思決定情報等の参照情報を取得する(参照情報取得ステップ)。S116に進む。
S116では、差異情報導出部118が、視認対象特定部113が特定した視認対象と、意思決定情報特定部116が特定した意思決定情報と、記憶部140から取得した参照情報とを参照し、差異情報を導出する(差異情報導出ステップ)。処理の詳細は、(差異情報導出部)に記載の通りである。差異情報導出部118は、導出した差異情報を、提示情報生成部119に送信し、S118に進む。
S118では、提示情報生成部119が、差異情報導出部118が導出した差異情報と、学習者情報取得部117から取得した学習者情報とを参照し、提示情報を生成する(提示情報生成ステップ)。処理の詳細は、(提示情報生成部)に記載の通りである。情報処理装置100の制御部110は、通信部130に、提示情報生成部119が生成した提示情報をヘッドマウントディスプレイ200及び表示部500に送信させ、S120に進む。
S120では、ヘッドマウントディスプレイ200の制御部250が、ディスプレイ270等に、提示情報生成部119が生成した提示情報を表示させ(提示情報表示ステップ)、S122に進み、処理を終了する。このとき、ヘッドマウントディスプレイ200の制御部250は、スピーカー240等に提示情報生成部119が生成した提示情報を音声として出力してもよい(図示せず)。
3.ソフトウェアによる実現例
情報処理装置100の制御ブロックは、集積回路(ICチップ)等に形成された論理回路(ハードウェア)によって実現してもよいし、ソフトウェアによって実現してもよい。
情報処理装置100の制御ブロックは、集積回路(ICチップ)等に形成された論理回路(ハードウェア)によって実現してもよいし、ソフトウェアによって実現してもよい。
後者の場合、情報処理装置100は、各機能を実現するソフトウェアであるプログラムの命令を実行するコンピュータを備えている。このコンピュータは、例えば少なくとも1つのプロセッサ(制御装置)を備えていると共に、上記プログラムを記憶したコンピュータ読み取り可能な少なくとも1つの記録媒体を備えている。そして、上記コンピュータにおいて、上記プロセッサが上記プログラムを上記記録媒体から読み取って実行することにより、本発明の目的が達成される。上記プロセッサとしては、例えばCPU(Central Processing Unit)を用いることができる。上記記録媒体としては、「一時的でない有形の媒体」、例えば、ROM(Read Only Memory)等の他、テープ、ディスク、カード、半導体メモリ、プログラマブルな論理回路等を用いることができる。また、上記プログラムを展開するRAM(Random Access Memory)等をさらに備えていてもよい。また、上記プログラムは、該プログラムを伝送可能な任意の伝送媒体(通信ネットワーク又は放送波等)を介して上記コンピュータに供給されてもよい。なお、本発明の一態様は、上記プログラムが電子的な伝送によって具現化された、搬送波に埋め込まれたデータ信号の形態でも実現され得る。
本発明の各態様に係る情報処理装置は、コンピュータによって実現してもよく、この場合には、コンピュータを上記情報処理装置が備える各部(ソフトウェア要素)として動作させることにより上記情報処理装置をコンピュータにて実現させる情報処理装置の制御プログラム、及びそれを記録したコンピュータ読み取り可能な記録媒体も、本発明の範疇に入る。
本発明は上述した各実施形態に限定されるものではなく、請求項に示した範囲で種々の変更が可能であり、異なる実施形態にそれぞれ開示された技術的手段を適宜組み合わせて得られる実施形態についても本発明の技術的範囲に含まれる。さらに、各実施形態にそれぞれ開示された技術的手段を組み合わせることにより、新しい技術的特徴を形成することができる。
〔まとめ〕
本発明の一態様に係る情報処理装置は、接客作業を学習する作業学習者の顔の少なくとも一部の情報を含む顔情報を取得する顔情報取得部と、前記作業学習者による発話の情報を含む音声情報を取得する音声情報取得部と、前記顔情報取得部が取得した顔情報が示す顔の少なくとも一部の状態と第1の参照情報との差異を示す第1の差異情報、及び、前記音声情報取得部が取得した音声情報と第2の参照情報との差異を示す第2の差異情報を導出する差異情報導出部と、前記第1の差異情報及び前記第2の差異情報の少なくとも何れかに応じた提示情報を生成する提示情報生成部とを備えていることを特徴とする情報処理装置である。
本発明の一態様に係る情報処理装置は、接客作業を学習する作業学習者の顔の少なくとも一部の情報を含む顔情報を取得する顔情報取得部と、前記作業学習者による発話の情報を含む音声情報を取得する音声情報取得部と、前記顔情報取得部が取得した顔情報が示す顔の少なくとも一部の状態と第1の参照情報との差異を示す第1の差異情報、及び、前記音声情報取得部が取得した音声情報と第2の参照情報との差異を示す第2の差異情報を導出する差異情報導出部と、前記第1の差異情報及び前記第2の差異情報の少なくとも何れかに応じた提示情報を生成する提示情報生成部とを備えていることを特徴とする情報処理装置である。
本発明の一態様に係る情報処理装置は、前記顔情報を参照して、前記作業学習者が視認する対象を特定する視認対象特定部を更に備え、前記差異情報導出部は、前記視認対象特定部が特定した視認対象を参照して前記第1の差異情報を導出することが好ましい。
本発明の一態様に係る情報処理装置において、視認対象特定部は、前記作業学習者が視認する対象への前記作業学習者の集中度を更に特定し、前記差異情報導出部は、前記視認対象特定部が特定した集中度を参照して前記第1の差異情報を導出することが好ましい。
本発明の一態様に係る情報処理装置において、前記提示情報生成部は、前記作業学習者が視認する対象が、前記第1の参照情報が示す対象とは異なる場合に、当該第1の参照情報が示す対象を強調表示した提示情報を生成することが好ましい。
本発明の一態様に係る情報処理装置において、前記提示情報生成部は、前記第2の差異情報が示す音声の差異に応じた提示情報を生成することを特徴とすることが好ましい。
本発明の一態様に係る情報処理装置において、前記提示情報生成部は、前記第1の差異情報及び前記第2の差異情報に応じた点数を算出し、算出した点数を前記提示情報に含ませることが好ましい。
本発明の一態様に係る情報処理装置において、前記作業学習者の体の少なくとも一部の動きを示す動き情報を取得する動き情報取得部を更に備え、前記差異情報導出部は、前記動き情報と第3の参照情報との差異を示す第3の差異情報を導出し、前記提示情報生成部が生成する提示情報には、前記第3の差異情報に応じた情報が含まれることが好ましい。
本発明の一態様に係る提示システムは、上記の情報処理装置と、ヘッドマウントディスプレイとを備えた提示システムであって、前記ヘッドマウントディスプレイは、前記作業学習者の顔の少なくとも一部を撮像する撮像部と、前記作業学習者の発話音声を集音する集音部と、前記提示情報を提示する提示部とを備えている提示システムである。
本発明の一態様に係るプログラムは、上記の情報処理装置としてコンピュータを機能させるためのプログラムである。
100 情報処理装置
110 制御部
111 顔情報取得部
112 状態検出部
113 視認対象特定部
114 音声情報取得部
115 動き情報取得部
116 意思決定情報特定部
117 学習者情報取得部
118 差異情報導出部
119 提示情報生成部
130 通信部
140 記憶部
200 ヘッドマウントディスプレイ
210 カメラ
220 マイク
230 動きセンサ
240 スピーカー
250 制御部
260 通信部
270 ディスプレイ
300 装着型インターフェース
310 動きセンサ
320 ボタン
400 情報管理サーバ
500 表示部
110 制御部
111 顔情報取得部
112 状態検出部
113 視認対象特定部
114 音声情報取得部
115 動き情報取得部
116 意思決定情報特定部
117 学習者情報取得部
118 差異情報導出部
119 提示情報生成部
130 通信部
140 記憶部
200 ヘッドマウントディスプレイ
210 カメラ
220 マイク
230 動きセンサ
240 スピーカー
250 制御部
260 通信部
270 ディスプレイ
300 装着型インターフェース
310 動きセンサ
320 ボタン
400 情報管理サーバ
500 表示部
Claims (9)
- 接客作業を学習する作業学習者の顔の少なくとも一部の情報を含む顔情報を取得する顔情報取得部と、
前記作業学習者による発話の情報を含む音声情報を取得する音声情報取得部と、
前記顔情報取得部が取得した顔情報が示す顔の少なくとも一部の状態と第1の参照情報との差異を示す第1の差異情報、及び、前記音声情報取得部が取得した音声情報と第2の参照情報との差異を示す第2の差異情報を導出する差異情報導出部と、
前記第1の差異情報及び前記第2の差異情報の少なくとも何れかに応じた提示情報を生成する提示情報生成部と
を備えていることを特徴とする情報処理装置。 - 前記顔情報を参照して、前記作業学習者が視認する対象を特定する視認対象特定部を更に備え、
前記差異情報導出部は、前記視認対象特定部が特定した視認対象を参照して前記第1の差異情報を導出する
ことを特徴とする請求項1に記載の情報処理装置。 - 視認対象特定部は、前記作業学習者が視認する対象への前記作業学習者の集中度を更に特定し、
前記差異情報導出部は、前記視認対象特定部が特定した集中度を参照して前記第1の差異情報を導出する
ことを特徴とする請求項2に記載の情報処理装置。 - 前記提示情報生成部は、前記作業学習者が視認する対象が、前記第1の参照情報が示す対象とは異なる場合に、当該第1の参照情報が示す対象を強調表示した提示情報を生成する
ことを特徴とする請求項2又は3に記載の情報処理装置。 - 前記提示情報生成部は、前記第2の差異情報が示す音声の差異に応じた提示情報を生成することを特徴とする請求項1から4の何れか1項に記載の情報処理装置。
- 前記提示情報生成部は、前記第1の差異情報及び前記第2の差異情報に応じた点数を算出し、算出した点数を前記提示情報に含ませる
ことを特徴とする請求項1から5の何れか1項に記載の情報処理装置。 - 前記作業学習者の体の少なくとも一部の動きを示す動き情報を取得する動き情報取得部を更に備え、
前記差異情報導出部は、前記動き情報と第3の参照情報との差異を示す第3の差異情報を導出し、
前記提示情報生成部が生成する提示情報には、前記第3の差異情報に応じた情報が含まれる
ことを特徴とする請求項1から6の何れか1項に記載の情報処理装置。 - 請求項1から7のいずれか1項に記載の情報処理装置と、ヘッドマウントディスプレイとを備えた提示システムであって、
前記ヘッドマウントディスプレイは、
前記作業学習者の顔の少なくとも一部を撮像する撮像部と、
前記作業学習者の発話音声を集音する集音部と、
前記提示情報を提示する提示部と
を備えていることを特徴とする提示システム。 - 請求項1に記載の情報処理装置としてコンピュータを機能させるためのプログラム。
Applications Claiming Priority (2)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| JP2019-006198 | 2019-01-17 | ||
| JP2019006198 | 2019-01-17 |
Publications (1)
| Publication Number | Publication Date |
|---|---|
| WO2020148919A1 true WO2020148919A1 (ja) | 2020-07-23 |
Family
ID=71614498
Family Applications (1)
| Application Number | Title | Priority Date | Filing Date |
|---|---|---|---|
| PCT/JP2019/009241 Ceased WO2020148919A1 (ja) | 2019-01-17 | 2019-03-08 | 情報処理装置、提示システム、及び情報処理プログラム |
Country Status (2)
| Country | Link |
|---|---|
| JP (1) | JP7111042B2 (ja) |
| WO (1) | WO2020148919A1 (ja) |
Cited By (1)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| JP2022047565A (ja) * | 2020-09-14 | 2022-03-25 | 株式会社ビーライズ | 職業訓練装置 |
Citations (7)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| JP2007078716A (ja) * | 2005-09-09 | 2007-03-29 | Chugoku Electric Power Co Inc:The | 業務研修システム |
| JP2007108620A (ja) * | 2005-10-13 | 2007-04-26 | Ichiro Hagiwara | 表情訓練器 |
| US7293025B1 (en) * | 2004-03-31 | 2007-11-06 | David Harouche | Hosted learning management system and method for training employees and tracking results of same |
| JP2013200440A (ja) * | 2012-03-26 | 2013-10-03 | Mitsubishi Electric Corp | 映像表示装置 |
| WO2016114261A2 (ja) * | 2015-01-13 | 2016-07-21 | 株式会社ジェネックスソリューションズ | 映像音声クリップを利用した自律的学習システム |
| JP2018180503A (ja) * | 2017-04-10 | 2018-11-15 | 国立大学法人九州大学 | パブリックスピーキング支援装置、及びプログラム |
| JP2018180090A (ja) * | 2017-04-05 | 2018-11-15 | コニカミノルタ株式会社 | 作業教育システム |
Family Cites Families (5)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| JP2001117046A (ja) | 1999-10-22 | 2001-04-27 | Shimadzu Corp | 視線検出機能付ヘッドマウントディスプレイシステム |
| JP5939493B1 (ja) | 2015-05-25 | 2016-06-22 | パナソニックIpマネジメント株式会社 | 接客評価装置およびこれを備えた接客評価システムならびに接客評価方法 |
| CN108604393B (zh) | 2016-03-04 | 2022-12-30 | 日铁系统集成株式会社 | 信息处理系统、信息处理装置、信息处理方法以及计算机可读取的存储介质 |
| JP2017208052A (ja) | 2016-05-23 | 2017-11-24 | 三菱電機株式会社 | ウェアラブル端末を用いた電気契約業務支援装置 |
| JP2018124604A (ja) | 2017-01-30 | 2018-08-09 | グローリー株式会社 | 接客支援システム、接客支援装置及び接客支援方法 |
-
2019
- 2019-03-08 WO PCT/JP2019/009241 patent/WO2020148919A1/ja not_active Ceased
- 2019-04-01 JP JP2019069945A patent/JP7111042B2/ja active Active
Patent Citations (7)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| US7293025B1 (en) * | 2004-03-31 | 2007-11-06 | David Harouche | Hosted learning management system and method for training employees and tracking results of same |
| JP2007078716A (ja) * | 2005-09-09 | 2007-03-29 | Chugoku Electric Power Co Inc:The | 業務研修システム |
| JP2007108620A (ja) * | 2005-10-13 | 2007-04-26 | Ichiro Hagiwara | 表情訓練器 |
| JP2013200440A (ja) * | 2012-03-26 | 2013-10-03 | Mitsubishi Electric Corp | 映像表示装置 |
| WO2016114261A2 (ja) * | 2015-01-13 | 2016-07-21 | 株式会社ジェネックスソリューションズ | 映像音声クリップを利用した自律的学習システム |
| JP2018180090A (ja) * | 2017-04-05 | 2018-11-15 | コニカミノルタ株式会社 | 作業教育システム |
| JP2018180503A (ja) * | 2017-04-10 | 2018-11-15 | 国立大学法人九州大学 | パブリックスピーキング支援装置、及びプログラム |
Cited By (2)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| JP2022047565A (ja) * | 2020-09-14 | 2022-03-25 | 株式会社ビーライズ | 職業訓練装置 |
| JP7237316B2 (ja) | 2020-09-14 | 2023-03-13 | 株式会社ビーライズ | 職業訓練装置 |
Also Published As
| Publication number | Publication date |
|---|---|
| JP2020115202A (ja) | 2020-07-30 |
| JP7111042B2 (ja) | 2022-08-02 |
Similar Documents
| Publication | Publication Date | Title |
|---|---|---|
| CN112034977B (zh) | Mr智能眼镜内容交互、信息输入、应用推荐技术的方法 | |
| US20200075007A1 (en) | Voice interaction system, voice interaction method, program, learning model generation apparatus, and learning model generation method | |
| JP6815486B2 (ja) | 精神障害の療法のためのモバイルおよびウェアラブルビデオ捕捉およびフィードバックプラットフォーム | |
| JP2025028902A (ja) | 医師による遠隔評価のためのデジタル眼検査方法 | |
| JP5317415B2 (ja) | 画像出力装置、画像出力方法、および画像出力プログラム | |
| JP7589438B2 (ja) | 情報処理装置、情報処理システム、情報処理方法、および情報処理プログラム | |
| JP7036046B2 (ja) | 情報処理装置、情報処理方法、及び情報処理プログラム | |
| KR20200105446A (ko) | 감정 인식 장치 및 감정 인식 방법 | |
| JP4869978B2 (ja) | 画像記録装置、画像記録方法、および画像記録プログラム | |
| US10275021B2 (en) | Display apparatus of front-of-the-eye mounted type | |
| CN114270446A (zh) | 虚拟现实治疗系统 | |
| JP2019505011A (ja) | 統合化された物体認識および顔表情認識を伴うvpa | |
| JP2004310034A (ja) | 対話エージェントシステム | |
| CN101453938B (zh) | 图像记录装置 | |
| JP2010094493A (ja) | 視認情景に対する視認者情感判定装置 | |
| CN101453943B (zh) | 图像记录装置和图像记录方法 | |
| US11682389B2 (en) | Voice conversation system, control system for voice conversation system, and control program, and control method | |
| JP7099377B2 (ja) | 情報処理装置及び情報処理方法 | |
| JPWO2020174537A1 (ja) | 情報処理システムおよび情報処理方法 | |
| CN113633870A (zh) | 情绪状态调节系统及方法 | |
| JP7111042B2 (ja) | 情報処理装置、提示システム、及び情報処理プログラム | |
| WO2020175969A1 (ko) | 감정 인식 장치 및 감정 인식 방법 | |
| CN111611939A (zh) | 眼疲劳状态检测方法及装置 | |
| JP2004280673A (ja) | 情報提供装置 | |
| WO2017085963A1 (ja) | 情報処理装置、及び映像表示装置 |
Legal Events
| Date | Code | Title | Description |
|---|---|---|---|
| 121 | Ep: the epo has been informed by wipo that ep was designated in this application |
Ref document number: 19910458 Country of ref document: EP Kind code of ref document: A1 |
|
| NENP | Non-entry into the national phase |
Ref country code: DE |
|
| 122 | Ep: pct application non-entry in european phase |
Ref document number: 19910458 Country of ref document: EP Kind code of ref document: A1 |