WO2021229641A1 - 環境推定方法、環境推定装置、およびプログラム - Google Patents
環境推定方法、環境推定装置、およびプログラム Download PDFInfo
- Publication number
- WO2021229641A1 WO2021229641A1 PCT/JP2020/018823 JP2020018823W WO2021229641A1 WO 2021229641 A1 WO2021229641 A1 WO 2021229641A1 JP 2020018823 W JP2020018823 W JP 2020018823W WO 2021229641 A1 WO2021229641 A1 WO 2021229641A1
- Authority
- WO
- WIPO (PCT)
- Prior art keywords
- acoustic signal
- keyword
- estimation
- environment
- environmental
- Prior art date
- Legal status (The legal status is an assumption and is not a legal conclusion. Google has not performed a legal analysis and makes no representation as to the accuracy of the status listed.)
- Ceased
Links
Images



Classifications
-
- G—PHYSICS
- G10—MUSICAL INSTRUMENTS; ACOUSTICS
- G10L—SPEECH ANALYSIS TECHNIQUES OR SPEECH SYNTHESIS; SPEECH RECOGNITION; SPEECH OR VOICE PROCESSING TECHNIQUES; SPEECH OR AUDIO CODING OR DECODING
- G10L25/00—Speech or voice analysis techniques not restricted to a single one of groups G10L15/00 - G10L21/00
- G10L25/48—Speech or voice analysis techniques not restricted to a single one of groups G10L15/00 - G10L21/00 specially adapted for particular use
- G10L25/51—Speech or voice analysis techniques not restricted to a single one of groups G10L15/00 - G10L21/00 specially adapted for particular use for comparison or discrimination
-
- G—PHYSICS
- G10—MUSICAL INSTRUMENTS; ACOUSTICS
- G10L—SPEECH ANALYSIS TECHNIQUES OR SPEECH SYNTHESIS; SPEECH RECOGNITION; SPEECH OR VOICE PROCESSING TECHNIQUES; SPEECH OR AUDIO CODING OR DECODING
- G10L15/00—Speech recognition
- G10L15/08—Speech classification or search
-
- G—PHYSICS
- G10—MUSICAL INSTRUMENTS; ACOUSTICS
- G10L—SPEECH ANALYSIS TECHNIQUES OR SPEECH SYNTHESIS; SPEECH RECOGNITION; SPEECH OR VOICE PROCESSING TECHNIQUES; SPEECH OR AUDIO CODING OR DECODING
- G10L15/00—Speech recognition
- G10L15/08—Speech classification or search
- G10L2015/088—Word spotting
Definitions
- the present invention relates to a technique for generating a natural language sentence explaining an acoustic signal.
- captioning The technology to generate explanatory text from media such as acoustic signals is called “captioning”.
- captioning the technology to generate explanatory text from media such as acoustic signals.
- sound captioning the one that generates the explanation of the environmental sound instead of the voice.
- Non-Patent Document 1-4 adopts a method called sequence-to-sequence (Sec2Sec) using deep learning (see, for example, Non-Patent Document 5).
- D is the dimension of the acoustic feature quantity
- v and the words w 1 , ..., w n-1 estimated from the first to the n-1th are input to the decoder D having the parameter ⁇ d, and the generation probability of the nth word w n is entered.
- the softmax function is applied to the final output of decoder D.
- x) of the entire sentence is estimated.
- w 1 is fixed to the index corresponding to the token that represents the beginning of the sentence.
- encoder E and decoder D are implemented by a recurrent neural network such as long short-term memory (LSTM) or a neural network using an attention mechanism (Attention) called Transformer.
- w n is p (w n
- Non-Patent Document 6 a data set collected from YouTube (registered trademark) or a free sound material collection (for example, Non-Patent Document 6) is often used. Most of these data are tagged with the media. For example, a locomotive passing sound or a whistle is tagged with a tag such as "railway", “trains", "horn” (for example, Non-Patent Document 7). Further, the data set used in Non-Patent Document 4 is a sound collected from YouTube (registered trademark) to which an ontology label is manually attached.
- Non-Patent Document 4 and sound captioning competitions are used as keywords, and by inputting them into the encoder E and decoder D at the same time, the diversity of explanatory texts can be suppressed and the accuracy of text generation can be suppressed. Is improving. That is, in the prior art, the difficulty of sound captioning is avoided by changing the problem setting.
- An object of the present invention is to estimate the environment in which acoustic signals are collected with high accuracy without inputting auxiliary information in view of the above technical problems.
- the environment estimation method of one aspect of the present invention is intended by associating an input step for inputting a target acoustic signal to be estimated with an acoustic signal and an explanatory text explaining the acoustic signal. Includes an estimation step, which estimates the environment in which the acoustic signal is collected.
- the present invention it is possible to estimate the environment in which acoustic signals are collected with high accuracy without inputting auxiliary information.
- FIG. 1 is a diagram illustrating the functional configuration of the estimator learning device.
- FIG. 2 is a diagram illustrating a processing procedure of the estimator learning method.
- FIG. 3 is a diagram illustrating the functional configuration of the environment estimation device.
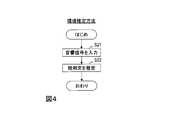
- FIG. 4 is a diagram illustrating the processing procedure of the environment estimation method.
- FIG. 5 is a diagram for explaining the experimental results.
- FIG. 6 is a diagram illustrating a functional configuration of a computer.
- the present invention is a technique for performing sound captioning without using auxiliary information such as keywords.
- auxiliary information such as keywords.
- a keyword is extracted from the explanatory text of the learning data, and the keyword is added to the learning data.
- a keyword is estimated from the observed sound, and a statistical model (hereinafter, also referred to as an "estimator") such as a deep neural network (DNN) is learned so that the keyword matches the keyword extracted above. ..
- a statistical model such as a deep neural network (DNN) is learned so that the keyword matches the keyword extracted above. ..
- the estimated keyword and the acoustic feature amount in which the keyword is embedded are simultaneously input to the decoder to generate an explanatory text.
- the estimator learning device 1 is configured by loading a special program into a publicly known or dedicated computer having, for example, a central processing unit (CPU: Central Processing Unit), a main storage device (RAM: Random Access Memory), and the like. It is a special device.
- the estimator learning device 1 executes each process under the control of the central processing unit, for example.
- the data input to the estimator learning device 1 and the data obtained in each process are stored in, for example, the main storage device, and the data stored in the main storage device is read out to the central processing unit as needed. Used for other processing.
- At least a part of each processing unit of the estimator learning device 1 may be configured by hardware such as an integrated circuit.
Landscapes
- Engineering & Computer Science (AREA)
- Computational Linguistics (AREA)
- Health & Medical Sciences (AREA)
- Audiology, Speech & Language Pathology (AREA)
- Human Computer Interaction (AREA)
- Physics & Mathematics (AREA)
- Acoustics & Sound (AREA)
- Multimedia (AREA)
- Signal Processing (AREA)
- Information Retrieval, Db Structures And Fs Structures Therefor (AREA)
Abstract
補助情報を入力することなく、音響信号が集音された環境を高精度に推定する。入力部(21)は、推定対象である対象音響信号を入力する。推定部(22)は、音響信号と音響信号を説明する説明文とを関連付けることで対象音響信号が集音された環境を推定する。環境は、関連付けにより得られる対象音響信号を説明する説明文である。関連付けは、音響信号に付与された説明文と、音響信号から関連付けにより得られた説明文との差を最小化するように学習される。
Description
この発明は、音響信号を説明する自然言語文を生成する技術に関する。
音響信号などのメディアから説明文を生成する技術は、「キャプショニング」と呼ばれる。特に、キャプショニングのうち、音声ではなく環境音の説明文を生成するものは、「音キャプショニング」と呼ばれる。
音キャプショニングは、時間領域のL点の観測信号x∈RLを説明するN単語の単語列w∈NNを生成する問題である(例えば、非特許文献1-4参照)。非特許文献1-4では、深層学習を利用したsequence-to-sequence(Sec2Sec)と呼ばれる方式を取っている(例えば、非特許文献5参照)。
まず、観測信号xを何らかの音響特徴量系列{φt∈RD}t=1
Tへ変換する。ここで、Dは音響特徴量の次元であり、t=1, …, Tは時間を表すインデックスである。その音響特徴量系列{φt∈RD}t=1
Tを、パラメータθeを持つエンコーダEを利用して、別の特徴量空間のベクトルないし行列v=Eθe(φ1, …, φT)へと埋め込む。そして、vと、1番目からn-1番目までに推定された単語w1, …, wn-1とを、パラメータθdを持つデコーダDへ入力し、n番目の単語wnの生成確率p(wn|v, w1, …, wn-1)を推定する。

ただし、デコーダDの最終出力にはsoftmax関数が適用されている。これをn=2からn=Nまで繰り返すことで、文章全体の生成確率p(w1, …, wN|x)を推定する。
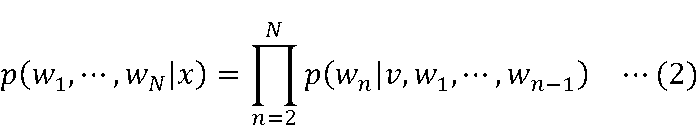
ただし、w1は文章の開始を表すトークンに対応するインデックスに固定されている。実際には、エンコーダEやデコーダDは、長短期記憶(LSTM: Long short-term memory)などの再帰型ニューラルネットワークや、Transformerと呼ばれる注意機構(Attention)を利用したニューラルネットワークにより実装される。また、wnはp(wn|v, w1, …, wn-1)が最大となるインデックスとするか、p(wn|v, w1, …, wn-1)からサンプリングすることで生成する。
音キャプショニングの難しさは、音に対応する生成文が無数に存在し得ることにある。まず、機械翻訳の例を挙げて説明する。例えば"A powerful car engine running with wind blowing."という英文を和訳することを考える。この英文には"powerful", "car", "wind", "blowing"という単語が含まれているため、それらに対応する日本語の単語「力強い/パワフル」「車」「風」「吹く」を使いながら翻訳するのが妥当であろう。ゆえに、人間がこの英文を和訳するのであれば、翻訳文は「風に吹かれながら走る、車のパワフルなエンジン」や「車のエンジンが、力強く風に吹かれながら走っている」などとなるのが妥当であろう。つまり、文章の鍵となる単語(キーワード)を外しながら翻訳することは妥当ではない。
一方で、エンジン音と正体不明の環境音とが混在する音が含まれる音を説明するときには、その音だけでは、その環境音が例えば風の音なのか水の音なのかわからないこともあるし、そのエンジンが何のエンジンなのかも(専門のエンジニアでない限り)わからないこともあろう。そのため、その音から生成し得る説明文は多様であり、例えば、"A powerful car engine running with wind blowing."の他にも、"A speedboat is traveling across water."、"A small motor runs loudly."、"An engine buzzing consistently."など、文章の翻訳以上に多様な説明文が許容されてしまう。
そこで、従来の音キャプショニングでは、音響信号とキーワードの両方を入力に使ってよい、という問題設定で解かれることが多い。音キャプショニングのデータセットは、YouTube(登録商標)やフリーの音素材集(例えば、非特許文献6)から収集されたものが用いられることが多い。そういったデータには、そのメディアに関するタグが付与されていることがほとんどである。例えば、機関車の通過音や汽笛には、"railway", "trains", "horn"などのタグが付与される(例えば、非特許文献7)。また、非特許文献4で用いられるデータセットは、YouTube(登録商標)から収集された音に人手でオントロジーラベルが付与されたものである。非特許文献4や音キャプショニングのコンペティションでは、こういったタグをキーワードとして利用し、それをエンコーダEやデコーダDに同時に入力することで、説明文の多様性を抑制したり、文章生成の精度を向上させたりしている。つまり、従来技術では、音キャプショニングの難しさを、問題設定を変えることで回避している。
K. Drossos, et al., "Automated audio captioning with recurrent neural networks," Proc. of WASPAA, 2017.
S. Ikawa, et al., "Neural audio captioning based on conditional sequence-to-sequence model," Proc. of DCASE, 2019.
M. Wu, et al., "Audio Caption: Listen and Tell," Proc. of ICASSP, 2019.
C. D. Kim, et al., "AudioCaps: Generating Captions for Audios in The Wild," Proc. of NAACL-HLT, 2019.
I. Sutskever, O. Vinyals, and Q. V. Le, "Sequence to Sequence Learning with NeuralNetworks," Proc. of NIPS, 2014.
K. Drossos, et al., "Clotho: An Audio Captioning Dataset," Proc. of ICASSP, 2020.
Freesound、"Train passing by in the Wirikuta Desert (Mexico, SLP)"、[online]、[令和2年4月27日検索]、インターネット<URL: https://freesound.org/people/felix.blume/sounds/166086/>
しかしながら、キーワード入力を許容する問題設定では、音キャプショニング技術の利用可能範囲を著しく制限してしまう。例えば、機械が発する異常な音を検出し、それをユーザに報告するシステムを考える。この場合、単に「異常」というラベルを出力するよりも、「普段は聞かない、金属がこすれるような高い音がしている」といった説明文を出力した方が、ユーザには理解しやすいし、故障箇所の発見などにも役立つだろう。しかしながら、説明文生成にキーワードが必要な場合、人間が「金属」「こすれる」などのキーワードを入力する必要がある。そこまで音の特徴がわかっているならば、もはや説明文を生成する必要はない。音キャプショニングの利用範囲を広げるためには、キーワードなどの補助情報を入力することなく、高精度な説明文生成が可能な技術が必要とされる。
この発明の目的は、上記のような技術的課題に鑑みて、補助情報を入力することなく、音響信号が集音された環境を高精度に推定することである。
上記の課題を解決するために、この発明の一態様の環境推定方法は、推定対象である対象音響信号を入力する入力ステップと、音響信号と音響信号を説明する説明文とを関連付けることで対象音響信号が集音された環境を推定する推定ステップと、を含む。
この発明によれば、補助情報を入力することなく、音響信号が集音された環境を高精度に推定することができる。
[発明の概要]
本発明は、キーワードなどの補助情報を用いずに、音キャプショニングを行う技術である。つまり、学習データとして「音」と「説明文」のペアが与えられ、テストデータとして「音」のみが与えられる、最もシンプルかつ実用的な問題設定を考える。
本発明は、キーワードなどの補助情報を用いずに、音キャプショニングを行う技術である。つまり、学習データとして「音」と「説明文」のペアが与えられ、テストデータとして「音」のみが与えられる、最もシンプルかつ実用的な問題設定を考える。
従来技術からも明らかなように、音キャプショニングにキーワードを入力することは、高精度に文章生成をすることに有用である。そこで、本発明では、まず、学習データの説明文からキーワードを抽出し、それを学習データに追加する。次に、観測音からキーワードを推定し、それが上記で抽出したキーワードと一致するようにディープニューラルネットワーク(DNN: Deep Neural Network)などの統計モデル(以下、「推定器」とも呼ぶ)を学習する。そして、推定したキーワードとキーワードを埋め込んだ音響特徴量とをデコーダに同時に入力し、説明文を生成する。
<キーワード学習データの作成>
キーワード学習データの作成手順を説明する。実行手順は以下である。
1.正解の説明文を単語分割(tokenize)する。
2.分割された単語それぞれの品詞を推定する。
3.事前に指定した品詞の単語のみについて語幹を求め、それをキーワードとする。ここで利用する品詞は何でもよいが、例えば、名詞、動詞、副詞、形容詞などを利用すればよい。
キーワード学習データの作成手順を説明する。実行手順は以下である。
1.正解の説明文を単語分割(tokenize)する。
2.分割された単語それぞれの品詞を推定する。
3.事前に指定した品詞の単語のみについて語幹を求め、それをキーワードとする。ここで利用する品詞は何でもよいが、例えば、名詞、動詞、副詞、形容詞などを利用すればよい。
上記手順で得られるキーワードが多すぎる場合、すべての学習データについて上記手順を繰り返し、抽出された単語それぞれの出現回数をカウントし、頻出する単語のみをキーワードとして選択してもよい。
例として"A muddled noise of broken channel of the TV."という文を考える。この文中で名詞、動詞、副詞、形容詞のいずれかに該当する単語は、"muddled", "noise", "broken", "channel", "TV"である。これらの語幹はそれぞれ"muddle", "noise", "break", "channel", "TV"である。したがって、"A muddled noise of broken channel of the TV."のキーワードは"muddle", "noise", "break", "channel", "TV"となる。
<キーワード推定>
キーワードの種類をKとし、観測音xに付与されているキーワードを表すベクトル(以下、「キーワードベクトル」とも呼ぶ)をh∈NKとする。ここで、hはk番目のキーワードが含まれていればk次元目が1、含まれていなければ0となるバイナリベクトルである。
キーワードの種類をKとし、観測音xに付与されているキーワードを表すベクトル(以下、「キーワードベクトル」とも呼ぶ)をh∈NKとする。ここで、hはk番目のキーワードが含まれていればk次元目が1、含まれていなければ0となるバイナリベクトルである。
ここでの目的は、観測音xから抽出した音響特徴量系列{φt∈RD}t=1
Tから、キーワードベクトルhを高精度に推定することである。最も単純には、キーワードを推定するパラメータθaを持つ推定器Aを考え、h=Aθa(φ1, …, φT)とする方法が考えられる。しかし、Tの大きさは入力音に依存して可変であり、それを固定長のベクトルへと変換することは容易ではない。また、"background"や"engine"といったキーワードに対応する音は長い時間にわたって鳴っている一方で、"door"や"knock"などのキーワードに対応する音は短い時間しか鳴っていないと想定される。つまり、音の信号処理/統計処理としては、時刻t毎にキーワードを推定する方が理にかなっている。しかし、時刻t毎にキーワードのラベルが与えられているのであれば、その推定器の学習は容易であるが(「強ラベル学習」と呼ばれる)、本発明の問題設定では、一つのキーワードのラベルは時系列全体に対してしか与えられていない。そこで本発明では、弱ラベル付き音響イベント検出問題を参考に推定方法を設計する。
まず、推定器Aを利用して、時刻tにおいてk番目のキーワードに関する音が存在する確率p(zt,k|x)を以下のように推定する。
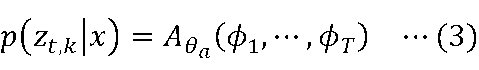
ここで、A: RD×T→RK×Tであり、出力層の活性化関数はsigmoid関数となる。
次に、音響特徴量系列内にk番目のキーワードが存在する確率p(zk|x)を、p(zt,k|x)を時間方向に集約することで推定する。集約方法は時間方向の平均など様々なものが考えられ、どのようなものでもよいが、例えば、以下の最大値を取る方法などを推奨する。
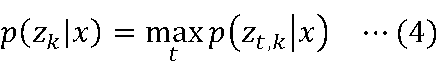
そして、パラメータθaを以下の重み付きバイナリクロスエントロピーを最小化するように最適化する。
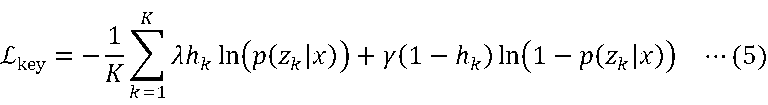
ここで、重み係数λとγは出現頻度の逆数として定義され、以下となる。
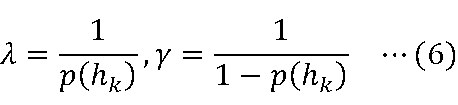
また、p(hk)は学習データにk番目のキーワードが出現する比率として以下のように求める。
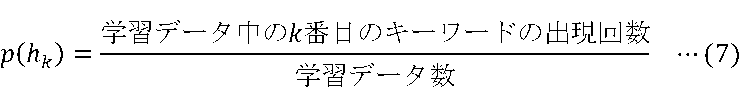
なお、式(5)は一個のサンプルから求めるように記載されているが、実際には、数個のサンプル(ミニバッチ)の平均値を最小化するように学習する。
<推定したキーワードを併用した説明文生成>
キーワードを説明文生成の入力とするために、p(zk|x)からM個のキーワードを選択する。この実現方法はいくつか考えられるが、何を利用してもよい。例えば、p(zk|x)をソートし、確率の高いものからM個を選択する、などが考えられる。このようにして選択したM個のキーワードを、何らかの単語埋め込み方法を利用して特徴量空間に埋め込み、M個のキーワード特徴量ベクトル{ym∈RD}m=1 Mを得る。そして、キーワード特徴量ベクトル{ym∈RD}m=1 MをエンコーダEやデコーダDの入力とすることで説明文を生成する。この実装法には、簡便なものには例えば以下を利用できる。
キーワードを説明文生成の入力とするために、p(zk|x)からM個のキーワードを選択する。この実現方法はいくつか考えられるが、何を利用してもよい。例えば、p(zk|x)をソートし、確率の高いものからM個を選択する、などが考えられる。このようにして選択したM個のキーワードを、何らかの単語埋め込み方法を利用して特徴量空間に埋め込み、M個のキーワード特徴量ベクトル{ym∈RD}m=1 Mを得る。そして、キーワード特徴量ベクトル{ym∈RD}m=1 MをエンコーダEやデコーダDの入力とすることで説明文を生成する。この実装法には、簡便なものには例えば以下を利用できる。
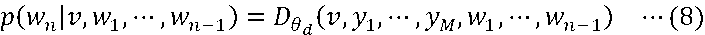
そして、各パラメータθe, θd, θaを、何らかの目的関数を最小化するように学習する。これには、例えば、生成した説明文と人手で与えた正解の説明文とのクロスエントロピーと、式(5)のキーワード推定誤差Lkeyとの和などが利用できる。

ただし、CE(a, b)はaとbから計算されるクロスエントロピーである。
本発明のポイントは、以下の三点である。
ポイント1.キーワードは、正解の説明文からヒューリスティックルールにより抽出される。正解の説明文を単語分割および品詞推定した上で、「名詞、動詞、形容詞、副詞」など所定の品詞のみを利用する。そして、各単語を語幹に変形して、全学習データでカウントし、頻出する単語をキーワードとして利用する。
ポイント2.キーワードの推定は、弱ラベル付き音響イベント検出問題として解く。キーワードに関連する音情報は、入力された音データの全体に含まれているかもしれないし、一部にしか含まれていないかもしれない。一部にしか含まれていない音(例えばドア音など)を高精度に検知するためには、何秒目から何秒目までその音が鳴っていたか、という強ラベル(音の種類+発生時刻)が必要であるが、ポイント1の方法では時刻を知ることはできない。そこで、キーワードに関連する音の発生確率は時刻毎に計算するが、学習は時間を集約する形で行う、弱ラベル付き音響イベント検出の問題設定を踏襲する。そして、学習方法を工夫することで、キーワードを高精度に推定できるようにする。
ポイント3.推定したキーワードは、事前に学習した特徴空間に埋め込み、デコーダへ入力される。この埋め込み方法は複数種類あるが、実施形態ではそのうちの一つを示す。
[実施形態]
以下、この発明の実施の形態について詳細に説明する。なお、図面中において同じ機能を有する構成部には同じ番号を付し、重複説明を省略する。
以下、この発明の実施の形態について詳細に説明する。なお、図面中において同じ機能を有する構成部には同じ番号を付し、重複説明を省略する。
この発明の実施形態は、音響信号と正解の説明文とのペアからなる学習データセットを用いて、音響信号から説明文を生成する推定器のパラメータを学習する推定器学習装置および方法と、推定器学習装置および方法により学習された推定器を用いて音響信号からその音響信号が集音された環境を推定する環境推定装置および方法とからなる。
<推定器学習装置>
図1に示すように、実施形態の推定器学習装置1は、例えば、学習データ記憶部10、キーワード生成部11、初期化部12、ミニバッチ選択部13、特徴量抽出部14、キーワード推定部15、キーワード埋込部16、説明文生成部17、パラメータ更新部18、収束判定部19、およびパラメータ記憶部20を備える。この推定器学習装置1が、図2に示す各ステップを実行することにより、実施形態の推定器学習方法が実現される。
図1に示すように、実施形態の推定器学習装置1は、例えば、学習データ記憶部10、キーワード生成部11、初期化部12、ミニバッチ選択部13、特徴量抽出部14、キーワード推定部15、キーワード埋込部16、説明文生成部17、パラメータ更新部18、収束判定部19、およびパラメータ記憶部20を備える。この推定器学習装置1が、図2に示す各ステップを実行することにより、実施形態の推定器学習方法が実現される。
推定器学習装置1は、例えば、中央演算処理装置(CPU: Central Processing Unit)、主記憶装置(RAM: Random Access Memory)などを有する公知又は専用のコンピュータに特別なプログラムが読み込まれて構成された特別な装置である。推定器学習装置1は、例えば、中央演算処理装置の制御のもとで各処理を実行する。推定器学習装置1に入力されたデータや各処理で得られたデータは、例えば、主記憶装置に格納され、主記憶装置に格納されたデータは必要に応じて中央演算処理装置へ読み出されて他の処理に利用される。推定器学習装置1の各処理部は、少なくとも一部が集積回路等のハードウェアによって構成されていてもよい。推定器学習装置1が備える各記憶部は、例えば、RAM(Random Access Memory)などの主記憶装置、ハードディスクや光ディスクもしくはフラッシュメモリ(Flash Memory)のような半導体メモリ素子により構成される補助記憶装置、またはリレーショナルデータベースやキーバリューストアなどのミドルウェアにより構成することができる。
以下、図2を参照して、実施形態の推定器学習装置1が実行する推定器学習方法について説明する。
学習データ記憶部10には、複数の学習データからなる学習データセットが記憶されている。各学習データは、予め収集した音響信号と、各音響信号に対して人手で付与した正解の説明文とからなる。
ステップS10において、推定器学習装置1は、学習データ記憶部10に記憶されている学習データセットを読み出す。読み出された学習データセットは、キーワード生成部11へ入力される。
ステップS11において、キーワード生成部11は、入力された学習データセットから各説明文に対応するキーワードを生成する。キーワードの生成方法は、上記の<キーワード学習データの作成>で説明した手順に従う。キーワード生成部11は、生成したキーワードを学習データの音響信号および説明文に付与して学習データ記憶部10に記憶する。
ステップS12において、初期化部12は、推定器のパラメータθe, θd, θaを乱数などで初期化する。
ステップS13において、ミニバッチ選択部13は、学習データ記憶部10に記憶されている学習データセットからランダムに100サンプル程度のミニバッチを選択する。ミニバッチ選択部13は、選択したミニバッチを特徴量抽出部14へ出力する。
ステップS14において、特徴量抽出部14は、ミニバッチに含まれる各音響信号から音響特徴量を抽出する。特徴量抽出部14は、抽出した音響特徴量をキーワード推定部15へ出力する。
ステップS15において、キーワード推定部15は、入力された音響特徴量からキーワードを推定する。キーワードの推定方法は、上記の<キーワード推定>で説明した手順に従う。キーワード推定部15は、生成したキーワードをキーワード埋込部16へ出力する。
ステップS16において、キーワード埋込部16は、入力されたキーワードを特徴量空間に埋め込み、キーワード特徴量ベクトルを生成する。キーワード埋込部16は、生成したキーワード特徴量ベクトルを説明文生成部17へ出力する。
ステップS17において、説明文生成部17は、入力されたキーワード特徴量ベクトルを用いて説明文を生成する。説明文の生成方法は、上記の<推定したキーワードを併用した説明文生成>で説明した手順に従う。説明文生成部17は、生成した説明文をパラメータ更新部18へ出力する。
ステップS18において、パラメータ更新部18は、式(9)のコスト関数Lのミニバッチでの平均を減少させるように、推定器のパラメータθe, θd, θaを更新する。
ステップS19において、収束判定部19は、あらかじめ設定した終了条件を満たしているか否かを判定する。収束判定部19は、終了条件を満たしていればステップS20へ処理を進め、満たしていなければステップS13へ処理を戻す。終了条件は、例えば、パラメータ更新を所定の回数実行したこと、などと設定すればよい。
ステップS20において、推定器学習装置1は、学習済みのパラメータθe, θd, θaをパラメータ記憶部20へ記憶する。
<環境推定装置>
図3に示すように、実施形態の環境推定装置2は、推定対象の音響信号を入力とし、その音響信号を説明する説明文を出力する。環境推定装置2は、例えば、パラメータ記憶部20、入力部21、および推定部22を備える。この環境推定装置2が、図4に示す各ステップを実行することにより、実施形態の環境推定方法が実現される。
図3に示すように、実施形態の環境推定装置2は、推定対象の音響信号を入力とし、その音響信号を説明する説明文を出力する。環境推定装置2は、例えば、パラメータ記憶部20、入力部21、および推定部22を備える。この環境推定装置2が、図4に示す各ステップを実行することにより、実施形態の環境推定方法が実現される。
環境推定装置2は、例えば、中央演算処理装置(CPU: Central Processing Unit)、主記憶装置(RAM: Random Access Memory)などを有する公知又は専用のコンピュータに特別なプログラムが読み込まれて構成された特別な装置である。環境推定装置2は、例えば、中央演算処理装置の制御のもとで各処理を実行する。環境推定装置2に入力されたデータや各処理で得られたデータは、例えば、主記憶装置に格納され、主記憶装置に格納されたデータは必要に応じて中央演算処理装置へ読み出されて他の処理に利用される。環境推定装置2の各処理部は、少なくとも一部が集積回路等のハードウェアによって構成されていてもよい。環境推定装置2が備える各記憶部は、例えば、RAM(Random Access Memory)などの主記憶装置、ハードディスクや光ディスクもしくはフラッシュメモリ(Flash Memory)のような半導体メモリ素子により構成される補助記憶装置、またはリレーショナルデータベースやキーバリューストアなどのミドルウェアにより構成することができる。
以下、図4を参照して、実施形態の環境推定装置2が実行する環境推定方法について説明する。
パラメータ記憶部20には、推定器学習装置1により学習された推定器のパラメータθe, θd, θaが記憶されている。
ステップS21において、入力部21へ、推定対象である対象音響信号が入力される。ここでは、対象音響信号は音声ではなく、環境音であるものとする。入力部21は、入力された対象音響信号を推定部22へ出力する。
ステップS22において、推定部22は、入力された対象音響信号を、パラメータ記憶部20に記憶された学習済みのパラメータθe, θd, θaを用いる推定器に入力し、対象音響信号を説明する説明文を推定する。ここでは、対象音響信号は環境音であるため、推定される説明文は対象音響信号が集音された環境を説明する自然言語文となる。なお、環境とは、対象音響信号が集音された場所の周囲で発生していた音響イベントおよび/または非音響イベントを含むものを意味する。推定部22は、推定した説明文を環境推定装置2の出力とする。
[実験結果]
図5に、本発明の有効性を確認するためにClotho dataset(非特許文献6)を利用して実験を行った結果を示す。評価指標は、DCASE2020 Challenge task 6と同じもの(BLEU1, BLEU2, BLEU3, BLEU4(図中ではB-1, B-2, B-3, B-4と記載), CIDEr, METEOR, ROUGEL(図中ではROUGE-Lと記載), SPICE, SPIDEr)を利用した。比較手法は、DCASE2020 Challenge task 6のベースラインシステム(図中のBaseline)と、LSTMとTransformerを利用したSec2Secモデルとした(図中のLSTM, Transformer)。本発明は、Transformerのエンコーダの後段にキーワード推定を利用し、式(8)のようにデコーダへ同時に入力するものである。“# of param”は各手法で用いたパラメータ数である。各手法の行に記載された数値は各評価指標によるスコアであり、値が大きいほど精度が高いことを表す。
図5に、本発明の有効性を確認するためにClotho dataset(非特許文献6)を利用して実験を行った結果を示す。評価指標は、DCASE2020 Challenge task 6と同じもの(BLEU1, BLEU2, BLEU3, BLEU4(図中ではB-1, B-2, B-3, B-4と記載), CIDEr, METEOR, ROUGEL(図中ではROUGE-Lと記載), SPICE, SPIDEr)を利用した。比較手法は、DCASE2020 Challenge task 6のベースラインシステム(図中のBaseline)と、LSTMとTransformerを利用したSec2Secモデルとした(図中のLSTM, Transformer)。本発明は、Transformerのエンコーダの後段にキーワード推定を利用し、式(8)のようにデコーダへ同時に入力するものである。“# of param”は各手法で用いたパラメータ数である。各手法の行に記載された数値は各評価指標によるスコアであり、値が大きいほど精度が高いことを表す。
図5からもわかるように、本発明はベースラインシステムよりも少ないパラメータ数で高精度に説明文推定ができている。また、キーワード推定を用いないLSTMやTransformerと比べて、同程度のパラメータ数で高精度に説明文推定ができていることがわかる。
以上、この発明の実施の形態について説明したが、具体的な構成は、これらの実施の形態に限られるものではなく、この発明の趣旨を逸脱しない範囲で適宜設計の変更等があっても、この発明に含まれることはいうまでもない。実施の形態において説明した各種の処理は、記載の順に従って時系列に実行されるのみならず、処理を実行する装置の処理能力あるいは必要に応じて並列的にあるいは個別に実行されてもよい。
[プログラム、記録媒体]
上記実施形態で説明した各装置における各種の処理機能をコンピュータによって実現する場合、各装置が有すべき機能の処理内容はプログラムによって記述される。そして、このプログラムを図6に示すコンピュータの記憶部1020に読み込ませ、演算処理部1010、入力部1030、出力部1040などに動作させることにより、上記各装置における各種の処理機能がコンピュータ上で実現される。
上記実施形態で説明した各装置における各種の処理機能をコンピュータによって実現する場合、各装置が有すべき機能の処理内容はプログラムによって記述される。そして、このプログラムを図6に示すコンピュータの記憶部1020に読み込ませ、演算処理部1010、入力部1030、出力部1040などに動作させることにより、上記各装置における各種の処理機能がコンピュータ上で実現される。
この処理内容を記述したプログラムは、コンピュータで読み取り可能な記録媒体に記録しておくことができる。コンピュータで読み取り可能な記録媒体は、例えば、非一時的な記録媒体であり、磁気記録装置、光ディスク等である。
また、このプログラムの流通は、例えば、そのプログラムを記録したDVD、CD-ROM等の可搬型記録媒体を販売、譲渡、貸与等することによって行う。さらに、このプログラムをサーバコンピュータの記憶装置に格納しておき、ネットワークを介して、サーバコンピュータから他のコンピュータにそのプログラムを転送することにより、このプログラムを流通させる構成としてもよい。
このようなプログラムを実行するコンピュータは、例えば、まず、可搬型記録媒体に記録されたプログラムもしくはサーバコンピュータから転送されたプログラムを、一旦、自己の非一時的な記憶装置である補助記録部1050に格納する。そして、処理の実行時、このコンピュータは、自己の非一時的な記憶装置である補助記録部1050に格納されたプログラムを一時的な記憶装置である記憶部1020に読み込み、読み込んだプログラムに従った処理を実行する。また、このプログラムの別の実行形態として、コンピュータが可搬型記録媒体から直接プログラムを読み込み、そのプログラムに従った処理を実行することとしてもよく、さらに、このコンピュータにサーバコンピュータからプログラムが転送されるたびに、逐次、受け取ったプログラムに従った処理を実行することとしてもよい。また、サーバコンピュータから、このコンピュータへのプログラムの転送は行わず、その実行指示と結果取得のみによって処理機能を実現する、いわゆるASP(Application Service Provider)型のサービスによって、上述の処理を実行する構成としてもよい。なお、本形態におけるプログラムには、電子計算機による処理の用に供する情報であってプログラムに準ずるもの(コンピュータに対する直接の指令ではないがコンピュータの処理を規定する性質を有するデータ等)を含むものとする。
また、この形態では、コンピュータ上で所定のプログラムを実行させることにより、本装置を構成することとしたが、これらの処理内容の少なくとも一部をハードウェア的に実現することとしてもよい。
Claims (7)
- 推定対象である対象音響信号を入力する入力ステップと、
音響信号と前記音響信号を説明する説明文とを関連付けることで前記対象音響信号が集音された環境を推定する推定ステップと、
を含む環境推定方法。 - 請求項1に記載の環境推定方法であって、
前記環境は、前記対象音響信号が集音された場所の周囲で発生していた音響イベントおよび/または非音響イベントを含む、
環境推定方法。 - 請求項1または2に記載の環境推定方法であって、
前記環境は、前記関連付けにより得られる前記対象音響信号を説明する説明文であり、
前記関連付けは、前記音響信号に付与された説明文と、前記音響信号から前記関連付けにより得られた説明文との差を最小化するように学習される、
環境推定方法。 - 請求項3に記載の環境推定方法であって、
前記関連付けは、前記説明文から抽出された前記音響信号を説明するためのキーワードを前記音響信号のラベルとして用いて行われる、
環境推定方法。 - 請求項4に記載の環境推定方法であって、
前記関連付けは、前記関連付けを用いて得られた、前記音響信号を説明するためのキーワードの候補である候補キーワードが、前記音響信号に含まれる確率を用いて行われる、
環境推定方法。 - 推定対象である対象音響信号を入力する入力部と、
音響信号と前記音響信号を説明する説明文とを関連付けることで前記対象音響信号が集音された環境を推定する推定部と、
を含む環境推定装置。 - 請求項6に記載の環境推定装置としてコンピュータを機能させるためのプログラム。
Priority Applications (3)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| US17/923,523 US20230245675A1 (en) | 2020-05-11 | 2020-05-11 | Environment estimation apparatus, environment estimation method, and program |
| JP2022522101A JP7537493B2 (ja) | 2020-05-11 | 2020-05-11 | 環境推定方法、環境推定装置、およびプログラム |
| PCT/JP2020/018823 WO2021229641A1 (ja) | 2020-05-11 | 2020-05-11 | 環境推定方法、環境推定装置、およびプログラム |
Applications Claiming Priority (1)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| PCT/JP2020/018823 WO2021229641A1 (ja) | 2020-05-11 | 2020-05-11 | 環境推定方法、環境推定装置、およびプログラム |
Publications (1)
| Publication Number | Publication Date |
|---|---|
| WO2021229641A1 true WO2021229641A1 (ja) | 2021-11-18 |
Family
ID=78526220
Family Applications (1)
| Application Number | Title | Priority Date | Filing Date |
|---|---|---|---|
| PCT/JP2020/018823 Ceased WO2021229641A1 (ja) | 2020-05-11 | 2020-05-11 | 環境推定方法、環境推定装置、およびプログラム |
Country Status (3)
| Country | Link |
|---|---|
| US (1) | US20230245675A1 (ja) |
| JP (1) | JP7537493B2 (ja) |
| WO (1) | WO2021229641A1 (ja) |
Cited By (3)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| WO2024154282A1 (ja) * | 2023-01-19 | 2024-07-25 | 日本電信電話株式会社 | 学習装置、推定装置、学習方法、推定方法及びプログラム |
| WO2024154281A1 (ja) * | 2023-01-19 | 2024-07-25 | 日本電信電話株式会社 | 学習装置、推定装置、学習方法、推定方法及びプログラム |
| WO2026038350A1 (ja) * | 2024-08-16 | 2026-02-19 | Ntt株式会社 | 音響イベント定位方法、音響イベント定位装置、プログラム |
Citations (2)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| JP2011250100A (ja) * | 2010-05-26 | 2011-12-08 | Sony Corp | 画像処理装置および方法、並びにプログラム |
| US20180061439A1 (en) * | 2016-08-31 | 2018-03-01 | Gregory Frederick Diamos | Automatic audio captioning |
Family Cites Families (1)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| US11048472B2 (en) * | 2019-01-27 | 2021-06-29 | Listen AS | Dynamically adjustable sound parameters |
-
2020
- 2020-05-11 US US17/923,523 patent/US20230245675A1/en not_active Abandoned
- 2020-05-11 WO PCT/JP2020/018823 patent/WO2021229641A1/ja not_active Ceased
- 2020-05-11 JP JP2022522101A patent/JP7537493B2/ja active Active
Patent Citations (2)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| JP2011250100A (ja) * | 2010-05-26 | 2011-12-08 | Sony Corp | 画像処理装置および方法、並びにプログラム |
| US20180061439A1 (en) * | 2016-08-31 | 2018-03-01 | Gregory Frederick Diamos | Automatic audio captioning |
Non-Patent Citations (3)
| Title |
|---|
| DONGJOO CHRIS KIM, BYEONGCHANG KIM, HYUNMIN KIM, KIM LEE GUNHEE: "AudioCaps: Generating Captions for Audios in The Wild", PROCEEDINGS OF THE 2019 CONFERENCE OF THE NORTH AMERICAN CHAPTER OF THE ASSOCIATION FOR COMPUTATIONAL LINGUISTICS: HUMAN LANGUAGE TECHNOLOGY, ASSOCIATION FOR COMPUTATIONAL LINGUISTICS, vol. 1, 1 June 2019 (2019-06-01), pages 119 - 132, XP055873339 * |
| IKAWA SHOTA, KASHINO KUNIO: "Neural Audio Captioning Based on Conditional Sequence-to-Sequence Model", PROCEEDINGS OF THE DETECTION AND CLASSIFICATION OF ACOUSTIC SCENES AND EVENTS 2019 WORKSHOP (DCASE2019), 1 January 2019 (2019-01-01) - 26 October 2019 (2019-10-26), New York, USA , pages 99 - 103, XP055873336, ISBN: 978-0-578-59596-2, DOI: 10.33682/7bay-bj41 * |
| IWATSUKI, MICHIO ET AL.: "Listen and Tell: Audio Scene Caption Generation using Deep Learning", PROCEEDINGS OF THE 81ST NATIONAL CONVENTION OF IPSJ, vol. 81, 28 February 2019 (2019-02-28), JP, pages 2-407 - 2-408, XP009532325 * |
Cited By (3)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| WO2024154282A1 (ja) * | 2023-01-19 | 2024-07-25 | 日本電信電話株式会社 | 学習装置、推定装置、学習方法、推定方法及びプログラム |
| WO2024154281A1 (ja) * | 2023-01-19 | 2024-07-25 | 日本電信電話株式会社 | 学習装置、推定装置、学習方法、推定方法及びプログラム |
| WO2026038350A1 (ja) * | 2024-08-16 | 2026-02-19 | Ntt株式会社 | 音響イベント定位方法、音響イベント定位装置、プログラム |
Also Published As
| Publication number | Publication date |
|---|---|
| JP7537493B2 (ja) | 2024-08-21 |
| US20230245675A1 (en) | 2023-08-03 |
| JPWO2021229641A1 (ja) | 2021-11-18 |
Similar Documents
| Publication | Publication Date | Title |
|---|---|---|
| Khandelwal et al. | Generalization through memorization: Nearest neighbor language models | |
| Chen et al. | Deep cross-modal audio-visual generation | |
| US20050240413A1 (en) | Information processing apparatus and method and program for controlling the same | |
| CN116737938A (zh) | 基于微调大模型在线数据网络细粒度情感检测方法及装置 | |
| Feldman et al. | Commonsense knowledge mining from pretrained models | |
| Fu et al. | Natural answer generation with heterogeneous memory | |
| CN116629345A (zh) | 针对大规模预训练语言模型的提示学习方法和交互系统 | |
| JP7537493B2 (ja) | 環境推定方法、環境推定装置、およびプログラム | |
| Xie et al. | Language-based audio retrieval task in DCASE 2022 challenge | |
| Zhu et al. | Audio tagging by cross filtering noisy labels | |
| WO2020110815A1 (ja) | キーワード抽出装置、キーワード抽出方法、およびプログラム | |
| Du et al. | Joint music and language attention models for zero-shot music tagging | |
| US12451136B2 (en) | Audio caption generation method, audio caption generation apparatus, and program | |
| CN120104718A (zh) | 一种文本检索增强生成方法、装置、介质和设备 | |
| Zhan et al. | elBERto: Self-supervised commonsense learning for question answering | |
| JP7743985B2 (ja) | 音響信号検索装置、音響信号検索方法、データ検索装置、データ検索方法、プログラム | |
| Olvera et al. | A sound description: Exploring prompt templates and class descriptions to enhance zero-shot audio classification | |
| Pasad et al. | On the contributions of visual and textual supervision in low-resource semantic speech retrieval | |
| JP6772394B1 (ja) | 情報学習装置、情報処理装置、情報学習方法、情報処理方法及びプログラム | |
| Švec et al. | Asking questions framework for oral history archives | |
| Wang et al. | Refbert: Compressing bert by referencing to pre-computed representations | |
| Singh et al. | Enhancing entertainment translation for indian languages using adaptive context, style and LLMs | |
| JP6067616B2 (ja) | 発話生成手法学習装置、発話生成手法選択装置、発話生成手法学習方法、発話生成手法選択方法、プログラム | |
| Brignatz et al. | Language adaptation for speaker recognition systems using contrastive learning | |
| Wang et al. | On-the-fly information retrieval augmentation for language models |
Legal Events
| Date | Code | Title | Description |
|---|---|---|---|
| 121 | Ep: the epo has been informed by wipo that ep was designated in this application |
Ref document number: 20935340 Country of ref document: EP Kind code of ref document: A1 |
|
| ENP | Entry into the national phase |
Ref document number: 2022522101 Country of ref document: JP Kind code of ref document: A |
|
| NENP | Non-entry into the national phase |
Ref country code: DE |
|
| 122 | Ep: pct application non-entry in european phase |
Ref document number: 20935340 Country of ref document: EP Kind code of ref document: A1 |