以下に添付図面を参照しながら実施形態について説明する。なお、本明細書及び図面において実質的に同一の機能を有する要素については、同一の符号を付することにより重複説明を省略する場合がある。
<1.第1実施形態>
第1実施形態について説明する。
まず、図1を参照しながら、第1実施形態に係る情報処理装置10について説明する。図1は、第1実施形態に係る情報処理装置の例を示した図である。
図1に示すように、情報処理装置10は、記憶部11、抽出部12、及び判定部13を有する。なお、記憶部11の機能は、例えば、HDD(Hard Disk Drive)などの磁気記憶デバイス、SSD(Solid State Drive)やRAM(Random Access Memory)ディスクなどの半導体記憶デバイス、光記憶デバイス、又は光磁気記憶デバイスなどを用いて実現可能である。抽出部12及び判定部13の機能は、例えば、CPU(Central Processing Unit)などを用いて実現可能である。
記憶部11は、第1の形状、当該第1の形状の一部と類似し、かつ、第1の形状とは異なる第2の形状、及び、第1の形状の中で第2の形状に類似する部分と他の部分との位置関係を対応付けて記憶する。また、記憶部11は、第1及び第2の形状を含む所定の形状群Crを記憶する。上記の形状は文字や図形などの形状を含む。文字には、例えば、平仮名、アルファベット、アラビア数字、漢字、ギリシャ文字などが含まれる。図形には、例えば、道路標識、案内標識、警戒標識、地図記号、商標などが含まれる。もちろん、ここで例示した以外の文字や図形に対しても第1実施形態の技術を適用可能である。
図1には、所定の形状群Crがアルファベットの場合を例示している。また、第1の形状の一例として「E」「W」「Y」を示している。例えば、「E」の一部には「F」と類似する部分P11(及び他の部分P12)が含まれる。そのため、第1の形状「E」に対応する第2の形状の1つは「F」となる。記憶部11は、第1の形状「E」及び第2の形状「F」に対応付けて、類似する部分P11から他の部分P12へと向かう方向を示す位置情報(下向き矢印)を記憶する。同様に、記憶部11は、第1の形状「E」、第2の形状「L」に対応付けて、類似する部分P22から他の部分P21へと向かう方向を示す位置情報(上向き矢印)を記憶する。第1の形状「W」及び「Y」についても同様である(符号P31、P32、P41、P42の部分を参照)。
抽出部12は、入力画像Ptから第2の形状を抽出する。第2の形状が抽出された範囲A1は、例えば、画像の二値化やラベリングなどの画像処理を実行し、同じラベルが付与された画素群を抽出する方法などを利用して検出することが可能である。範囲A1に対応する画像(第2の部分画像)は、例えば、ラベリングによりラベルが付与された画素群を有する画像である。図1には、範囲A1に「F」に類似する第2の部分画像が含まれている。この場合、抽出部12は、第2の部分画像に類似する形状として、所定の形状群Cr(この例ではアルファベット)から「F」を抽出する。
判定部13は、抽出部12により第2の形状が抽出された範囲A1を、位置関係に基づいて類似する部分から他の部分へと向かう方向に拡張し、拡張した範囲A2に対応する第1の部分画像と第1の形状との類否を判定する。図1の例では、範囲A1に対応する第2の部分画像として「F」が抽出されている。「F」は、記憶部11が記憶している第2の形状に含まれる。そのため、判定部13は、記憶部11が記憶している第2の形状「F」に対応する位置関係(下向き矢印)を確認し、その位置関係が示す方向に範囲A1を拡張する。そして、判定部13は、範囲A1を下向きに拡張した範囲A2に対応する第1の部分画像が、第2の形状「F」に対応する第1の形状「E」に類似するか否かを判定する。
上記のように、記憶部11が記憶している位置関係に基づいて範囲を拡張する方向が決まる。つまり、組み合わせるセグメントを探索する際に、あらゆる方向に探索を試みるのではなく、位置関係が示す方向に対象を絞り込んで探索を行うことができる。図1の例では、範囲A1の上下左右に範囲を拡張するのではなく、位置関係が示す下方向に範囲を拡張するだけで、適当なセグメントの組み合わせに相当する第1の部分画像が得られている。また、範囲を拡張した際に検出されると予測される第1の形状が記憶部11により記憶されているため、所定の形状群Crに含まれる全ての形状について類否を判定せずに済む分、処理負荷の更なる低減が実現される。
なお、図1の例では、1つの文字(「E」)が途中で分断され、その一部に含まれる第2の形状が検出された場合を例に挙げたが、複数のセグメントを含む1つの文字の文字認識を行う場合や、複数の文字を含む文字列の認識を行う場合についても同様である。
第1実施形態に係る技術は、ドキュメントスキャナなどの専用の読み取り装置で読み取られた文字列の認識にも適用可能であるし、撮像画像に含まれる1つ又は複数の文字を認識する場合にも適用可能である。後者の場合、撮影環境に起因するノイズや画像処理の過程で生じるノイズなどの影響で文字の一部が欠損し、図1に示すように本来1つのセグメントで表現される文字が複数のセグメントに分断されてしまうことがある。さらに、分断される位置によっては他の文字との間で高い類似度が得られ、他の文字として誤認識されてしまう可能性がある。しかし、第1実施形態に係る技術を適用すれば、第2の形状が検出された場合に、位置関係が示す方向に拡張して第1の形状との類否判断が行われるため、そのような誤検出が生じにくくなり、文字認識の検出精度が向上する。
以上説明したように、第1実施形態によれば、組み合わせるセグメントの方向を絞り込んで類否判定を実行するため、文字認識の処理負荷を低減することができる。さらに、ある形状の一部に対応するセグメントが他の形状に類似する場合でも、両形状の位置関係を考慮して組み合わせるセグメントを探索する範囲を拡張して類似度を再判定することで、誤認識が生じるリスクを低減することができる。
<2.第2実施形態(文字認識方法)>
次に、第2実施形態について説明する。
[2−1.文字認識方法の一例]
図2〜図4を参照しながら、第2実施形態に係る文字認識方法について説明する。ここで説明する内容は、撮像装置で撮像された画像を取得し、その画像(以下、取得画像)に含まれる1つ又は複数の文字を認識する際に実行される処理の一部に関する。図2は、第2実施形態に係る文字認識方法の例を示した第1の図である。図3は、第2実施形態に係る文字認識方法の例を示した第2の図である。図4は、第2実施形態に係る文字認識方法の例を示した第3の図である。
まず、図2を参照する。図2に示すように、文字認識処理Rの前段に実行される処理として、画像の取得(S11)、画像の二値化(S12)、ラベリング(S13)、及び矩形領域の切り出し(S14)などの処理が実行される。つまり、文字認識処理Rの準備として、上述したセグメントに相当する切り出し画像を生成する処理が実行される。切り出し画像が生成された後、切り出し画像の選択(S15)、類似度の計算(S16)、及び認識結果の出力(S17)などの処理が実行される。
(S12、S13の処理について)
以下、S12及びS13の処理について、さらに説明する。
(S12)取得画像の二値化処理は、例えば、取得画像に含まれる各画素の画素値と所定の閾値とを比較し、画素値が所定の閾値を上回る画素に1を、それ以外の画素に0を対応付ける処理である。図2の例では、1に対応付けられた画素が黒で表現され、0に対応付けられた画素が白で表現されている。なお、二値化処理が施された取得画像を二値化画像と呼ぶ場合がある。所定の閾値は、画素値がとり得る範囲の中間に位置する値(例えば、127など)に設定される。
(S13)ラベリング処理は、二値化画像の中で黒の部分(白の部分でもよいが、ここでは黒の部分を例に説明する。)が連続した画素に同じ番号(以下、ラベル)を割り振る処理である。ラベリング処理には、例えば、縦方向又は横方向に黒の部分が連続している画素に同じラベルを割り振る4連結と呼ばれる方式や、縦方向、横方向、又は斜め方向に連続している画素に同じラベルを割り振る8連結と呼ばれる方式がある。ここでは8連結の方式を例に説明を進める。
ラベリング処理の開始時に全ての画素のラベルが0に設定される。次に、二値化画像の左上からラスタスキャンを実行して黒の画素を探索する処理が実行される。黒の画素が発見されると、その画素(以下、対象画素)の左上、上、右上、左に位置する画素のラベルが参照され、全てのラベルが0の場合には最後に割り振ったラベルの番号に1を加えた番号が対象画素のラベルに設定される。参照した画素に0以外のラベルが割り振られた画素が存在する場合には、その画素に割り振られたラベルの最小番号が対象画素のラベルに設定される。
このとき、対象画素のラベルを割り振る前に最後に割り振ったラベルの番号NAと、対象画素に割り振ったラベルの番号NBとが対応付けて保持される。二値化画像に含まれる全ての画素に対してラベルが割り振られた後、保持された番号(NA及びNB)に基づいてラベルの番号が調整される。つまり、番号NAが割り振られた画素のラベルが番号NBに変更される。上記のような処理を実行することで、縦方向、横方向、又は斜め方向に連続している画素に同じラベルを割り振ることができる。なお、上記の方法は一例であり、二値化画像に含まれる黒の部分の輪郭を追跡し、閉じた領域を抽出して同じラベルを割り振る方法などもある。
(S15、S16の処理について)
以下、S15及びS16の処理について、さらに説明する。
(S15)切り出し画像の選択処理は、例えば、同じラベルが割り振られた画素群を1つのブロックとして扱い、1つ又は複数のブロックを含む矩形領域を選択する処理である。一例として、同じ高さの矩形領域を用意し、幅及び位置を横方向に変更しながら1つ又は複数のブロックを含む矩形領域を選択する方法を考える。図2の例では、二値化画像からラベル1、2、3を割り振られた3つの画素群が得られている。この場合、ラベル2、3に対応するブロックを含む切り出し画像#1、及びラベル1に対応するブロックを含む切り出し画像#2が得られる。
なお、矩形領域の選択方法は図2の例に限定されない。例えば、同じラベルが割り振られた画素群を囲む最小の矩形領域を選択して切り出し画像とする方法も考えられる。この場合、図2の例ではラベル1、2、3にそれぞれ対応する矩形領域が選択され、それぞれ対応する3つの切り出し画像が得られる。以下の説明においては、矩形領域の切り出し方法を特定の方法に限定することはせず、所定の方法で文字の一部又は全部に対応する矩形領域が選択され、それに対応する切り出し画像が得られたものとして説明を進める。
(S16)類似度の計算処理は、予め用意された文字の画像(以下、辞書画像)と、切り出し画像との間の類似度を計算する処理である。このとき、1つの切り出し画像と辞書画像との類似度を計算するだけでなく、複数の切り出し画像を組み合わせた画像と辞書画像との類似度が計算される。図2の例では、切り出し画像#1と辞書画像との類似度、切り出し画像#2と辞書画像との類似度、切り出し画像#1及び#2の組み合わせと辞書画像との類似度が計算される。そして、類似度が最大となる切り出し画像と辞書画像とが認識結果となる。
図2の例では、説明の都合上、横方向に並んだ2つの切り出し画像だけを考えたため、切り出し画像の組み合わせ及び類似度の計算は比較的単純である。しかし、複数の文字を含む文字列を考える場合、複雑な構造を有する文字を扱う場合、或いは、取得画像に含まれるノイズなどの影響で文字の一部が分断されている場合などでは、切り出し画像の組み合わせ数が大きくなる。そこで、第2実施形態においては、組み合わせる切り出し画像の位置関係を予め保持しておき、その位置関係に基づいて切り出し画像の組み合わせを決めることで文字認識処理Rの処理負荷を低減する文字認識方法を提案する。
(第2実施形態に係る文字認識方法について)
図3に示すように、複数の文字を含む文字列を二値化画像から切り出した場合、多くの切り出し画像(図3の例では切り出し画像#1〜#7)が得られる。この場合、切り出し画像#1と辞書画像との間の類似度R11、切り出し画像#2と辞書画像との間の類似度R22、…、切り出し画像#7と辞書画像との間の類似度R77を計算する処理が発生する。さらに、切り出し画像#1及び#2の組み合わせと辞書画像との間の類似度R12、切り出し画像#2及び#3の組み合わせと辞書画像との間の類似度R23、…、切り出し画像#6及び#7の組み合わせと辞書画像との間の類似度R67を計算する処理が発生する。
図3の例では、1つの切り出し画像又は2つの左右に隣接する切り出し画像の組み合わせだけを考慮したが、3つ以上の切り出し画像の組み合わせや、上下に隣接する切り出し画像の組み合わせを考慮すると計算する類似度の数は多くなる。そこで、第2実施形態に係る文字認識方法では、図4に示すような拡張情報テーブルを利用する方法を提案する。図4に示すように、拡張情報テーブルは、基準文字、拡張文字、及び位置関係を対応付けた情報である。基準文字及び拡張文字は、いずれも辞書画像に対応する文字群に含まれる文字である。但し、基準文字は、拡張文字の一部と類似する形状を有する文字である。
拡張情報テーブルには、拡張文字の中で基準文字に類似する部分P1と、他の部分P2との位置関係を示す情報が含まれる。図4の例では、拡張文字「に」及び基準文字「こ」の組み合わせに対し、類似する部分P1から他の部分P2へ向かう方向を示す情報が位置関係を示す情報として拡張情報テーブルに含まれている。例えば、矩形領域A1に対応する切り出し画像が「こ」と類似する場合に、基準文字「こ」に対応する位置関係(左方向)に従って矩形領域をA2まで拡張することで、拡張文字「に」が認識される可能性の高い切り出し画像を得ることができる。なお、矩形領域A1を矩形領域A2まで拡張することは、矩形領域A1の切り出し画像と、矩形領域A2の切り出し画像とを組み合わせることに相当する。
文字「こ」に類似する切り出し画像の右側に他の切り出し画像を組み合わせて他の文字と類似する切り出し画像が得られることはないため、上記の方法を適用すれば、右側の切り出し画像と組み合わせて類似度を計算するという無駄な処理が省かれる。そのため、基準文字と拡張文字との位置関係を利用して切り出し画像の組み合わせを選択することにより、図2に示した文字認識処理Rの処理負荷を低減することが可能になる。なお、ここでは、説明の都合上、平仮名を例に挙げ、位置関係として「方向」を考慮した文字認識方法を示したが、様々な文字や図形の形状に適用可能である。また、位置関係の表現方法も「方向」に限定されない。
以上、第2実施形態に係る文字認識方法について説明した。以下では、この文字認識方法を実現可能な情報処理装置100の例、及び情報処理装置100が実行する処理の流れなどについて、さらに説明する。
[2−2.情報処理装置のハードウェア]
図5を参照しながら、後述する情報処理装置100のハードウェアについて説明する。図5は、第2実施形態に係る情報処理装置のハードウェアの例を示した図である。
情報処理装置100が有する各要素の機能は、例えば、図5に示すハードウェア資源を用いて実現することが可能である。つまり、当該各要素の機能は、コンピュータプログラムを用いて図5に示すハードウェアを制御することにより実現される。なお、このハードウェアの形態は任意であり、例えば、パーソナルコンピュータ、携帯電話機、PHS(Personal Handy-phone System)、PDA(Personal Digital Assistant)などの携帯情報端末、ゲーム機、又は種々の通信装置がこれに含まれる。
図5に示すように、このハードウェアは、主に、CPU902と、ROM(Read Only Memory)904と、RAM906と、ホストバス908と、ブリッジ910と、を有する。さらに、このハードウェアは、外部バス912と、インターフェース914と、入力部916と、出力部918と、記憶部920と、ドライブ922と、接続ポート924と、通信部926と、を有する。
CPU902は、例えば、演算処理装置又は制御装置として機能し、ROM904、RAM906、記憶部920、又はリムーバブル記録媒体928に記録された各種プログラムに基づいて各構成要素の動作全般又はその一部を制御する。ROM904は、CPU902に読み込まれるプログラムや演算に用いるデータなどを格納する記憶装置の一例である。RAM906には、例えば、CPU902に読み込まれるプログラムや、そのプログラムを実行する際に適宜変化する各種パラメータなどが一時的又は永続的に格納される。
これらの要素は、例えば、高速なデータ伝送が可能なホストバス908を介して相互に接続される。一方、ホストバス908は、例えば、ブリッジ910を介して比較的データ伝送速度が低速な外部バス912に接続される。また、入力部916としては、例えば、マウス、キーボード、タッチパネル、タッチパッド、ボタン、スイッチ、及びレバーなどが用いられる。さらに、入力部916としては、赤外線やその他の電波を利用して制御信号を送信することが可能なリモートコントローラが用いられることもある。
出力部918としては、例えば、CRT(Cathode Ray Tube)、LCD(Liquid Crystal Display)、PDP(Plasma Display Panel)、又はELD(Electro-Luminescence Display)などのディスプレイ装置が用いられる。また、出力部918として、スピーカやヘッドホンなどのオーディオ出力装置、プリンタ、携帯電話機、又はファクシミリなどが用いられることもある。つまり、出力部918は、情報を視覚的又は聴覚的に出力することが可能な装置である。
記憶部920は、各種のデータを格納するための装置である。記憶部920としては、例えば、HDDなどの磁気記憶デバイスが用いられる。また、記憶部920として、SSDやRAMディスクなどの半導体記憶デバイス、光記憶デバイス、又は光磁気記憶デバイスなどが用いられてもよい。
ドライブ922は、着脱可能な記録媒体であるリムーバブル記録媒体928に記録された情報を読み出し、又はリムーバブル記録媒体928に情報を書き込む装置である。リムーバブル記録媒体928としては、例えば、磁気ディスク、光ディスク、光磁気ディスク、又は半導体メモリなどが用いられる。また、リムーバブル記録媒体928として、非接触型IC(Integrated Circuit)チップを搭載したICカードや電子機器などが用いられてもよい。
接続ポート924は、例えば、USB(Universal Serial Bus)ポート、IEEE1394ポート、SCSI(Small Computer System Interface)、RS−232Cポート、又は光オーディオ端子など、外部接続機器930を接続するためのポートである。外部接続機器930としては、例えば、プリンタ、携帯音楽プレーヤ、デジタルカメラ、デジタルビデオカメラ、又はICレコーダなどが用いられる。
通信部926は、ネットワーク932に接続するための通信デバイスである。通信部926としては、例えば、有線又は無線LAN(Local Area Network)用の通信回路、WUSB(Wireless USB)用の通信回路、光通信用の通信回路やルータ、ADSL(Asymmetric Digital Subscriber Line)用の通信回路やルータ、携帯電話ネットワーク用の通信回路などが用いられる。通信部926に接続されるネットワーク932は、有線又は無線により接続されたネットワークであり、例えば、インターネット、LAN、放送網、衛星通信回線などを含む。
以上、情報処理装置100のハードウェアについて説明した。
[2−3.情報処理装置の機能]
次に、図6〜図8を参照しながら、情報処理装置100の機能について説明する。図6は、第2実施形態に係る情報処理装置の機能を示したブロック図である。図7は、第2実施形態に係る辞書画像テーブルの例を示した図である。図8は、第2実施形態に係る拡張情報テーブルの例を示した図である。
図6に示すように、情報処理装置100は、画像取得部101、切り出し部102、記憶部103、及び認識部104を有する。なお、画像取得部101、切り出し部102、認識部104が有する機能は、CPU902が実行するプログラムのモジュールとして実現できる。また、画像取得部101、切り出し部102、認識部104が有する機能の一部又は全部をソフトウェアではなく電子回路として実現することも可能である。また、記憶部103は、RAM906、記憶部920、又はリムーバブル記録媒体928に確保された記憶領域である。
(画像取得部101、切り出し部102)
画像取得部101は、文字認識処理の対象となる画像を取得する。例えば、画像取得部101は、情報処理装置100に接続された撮像装置などの外部接続機器930から画像を取得する。画像取得部101により取得された画像は、切り出し部102に入力される。画像が入力された切り出し部102は、図2に示したような方法で、入力された画像に対して二値化処理、ラベリング処理、及び切り出し処理を施し、一又は複数の切り出し画像を生成する。切り出し部102により生成された切り出し画像は、認識部104に入力される。
(記憶部103)
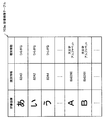
記憶部103は、辞書画像テーブル103a、及び拡張情報テーブル103bを有する。辞書画像テーブル103aは、図7に示すように、予め用意された文字の画像である辞書画像と、その文字を識別する識別情報と、その文字の種別を示す種別情報とを対応付けるテーブルである。拡張情報テーブル103bは、図8に示すように、基準文字と、拡張文字と、位置関係を示す情報(例えば、方向や座標情報など)とを対応付けるテーブルである。ここで、辞書画像テーブル103a及び拡張情報テーブル103bについて、さらに説明する。
図7に示すように、辞書画像テーブル103aは辞書画像を有する。辞書画像は、例えば、平仮名、アルファベット、アラビア数字、漢字、ギリシャ文字などを表した画像である。図7の例では、辞書画像に対応付けて識別情報及び種別情報が辞書画像テーブル103aに記録されている。識別情報は、例えば、文字コードや、予めユーザが文字毎に設定した識別番号などである。種別情報は、辞書画像が表す文字の種別を識別するための情報である。例えば、認識対象とする文字の種別が予め分かっている場合には、その種別に対応する辞書画像を利用して文字認識処理を実行することで、より高い精度で文字を認識することが可能になる。なお、種別情報は実施の態様に応じて適宜省略してもよい。
図8に示すように、拡張情報テーブル103bは基準文字及び拡張文字を対応付ける。基準文字及び拡張文字は、いずれも辞書画像テーブル103aに含まれる辞書画像が表す文字である。基準文字は、拡張文字の一部と形状が類似する文字である。例えば、文字「き」の下側一部と文字「さ」とは形状が類似している。そのため、拡張情報テーブル103bには、基準文字「さ」と拡張文字「き」とが対応付けて記録されている。
拡張情報テーブル103bには、拡張文字の中で基準文字と類似する部分と、他の部分との位置関係を示す情報がさらに記録される。図8の例では、類似する部分に対応する矩形領域を基準範囲、他の部分に対応する矩形領域を拡張範囲と呼び、基準範囲及び拡張範囲の相対的な位置関係を座標で表現した情報が拡張情報テーブル103bに記録されている。なお、基準範囲又は拡張範囲を表す矩形領域の左下頂点をa、右下頂点をb、右上頂点をc、左上頂点をdと表現している。また、基準範囲の座標点aを原点としている。
図8の例において、拡張文字「き」の基準範囲は、a(0,0)、b(5,0)、c(5,8)、d(0,8)で表現されている。拡張範囲は、a(−1,8)、b(5,8)、c(5,11)、d(−1,11)で表現されている。このように、基準範囲及び拡張範囲を座標で表現することで、基準範囲から拡張範囲へ向かう方向だけでなく、基準範囲及び拡張範囲について大きさの比率などを得ることができる。例えば、基準文字「さ」に類似する部分の矩形領域が検出された場合、その矩形領域(基準範囲)を基準に、高さが(3/8)倍、幅が(6/5)倍であり、その基準範囲の右上頂点に、右下頂点が一致する拡張範囲を設定することができる。
なお、図8に示した位置関係の表現方法は一例であり、座標以外の方法で基準範囲及び拡張範囲を表現してもよい。また、図4に示したように、位置関係を示す情報として基準範囲から拡張範囲へと向かう方向の情報だけを拡張情報テーブル103bに記録するようにしてもよい。方向の情報は、画像の向きを基準として上下左右で表現した情報でもよいし、ベクトルを用いて表現した情報でもよい。以下の説明においては、図8に例示した拡張情報テーブル103bが記憶部103に記録されているものとして説明を進める。
(認識部104)
再び図6を参照する。認識部104は、選択部111、類似度計算部112、判定部113、及び範囲拡張部114を含む。
選択部111は、辞書画像との類似度を計算する切り出し画像を選択する。類似度計算部112は、辞書画像テーブル103aを参照し、選択部111が選択した切り出し画像と辞書画像との類似度を計算する。判定部113は、類似度計算部112により計算された類似度が文字判定用の閾値を上回る切り出し画像及びそれに対応する辞書画像を抽出する。この文字判定用の閾値は、辞書画像に対応する文字である可能性が高い切り出し画像を抽出するための閾値である。ある切り出し画像について類似度が文字判定用の閾値を上回る辞書画像が複数存在する場合には、類似度が最大となる辞書画像が抽出される。
範囲拡張部114は、拡張情報テーブル103bを参照し、判定部113が抽出した辞書画像が基準文字に該当するか否かを判定する。判定部113が抽出した辞書画像が基準文字に該当しない場合、範囲拡張部114は、判定部113が抽出した辞書画像の文字を文字認識結果として出力する。一方、判定部113が抽出した辞書画像が基準文字に該当する場合、範囲拡張部114は、その基準文字に対応する位置関係の情報(拡張範囲の座標など)を拡張情報テーブル103bから抽出し、その情報を選択部111に入力する。
位置関係の情報が入力された選択部111は、その位置関係の情報に基づいて切り出し画像を再び選択し、選択した切り出し画像を類似度計算部112に入力する。選択部111から再び切り出し画像が入力された類似度計算部112は、入力された切り出し画像と、拡張文字に対応する辞書画像との類似度を計算する。判定部113は、基準文字に係る類似度と、拡張文字に係る類似度とを比較する。基準文字に係る類似度が拡張文字に係る類似度よりも大きい場合、判定部113は、基準文字を文字認識結果として出力する。一方、基準文字に係る類似度が拡張文字に係る類似度よりも小さい場合、判定部113は、拡張文字を文字認識結果として出力する。
例えば、文字「の」を表す切り出し画像が認識部104に入力された場合、選択部111は、その切り出し画像を類似度計算部112に入力する。類似度計算部112は、辞書画像テーブル103aに含まれる各辞書画像と切り出し画像との類似度を計算する。判定部113は、最大の類似度に対応する辞書画像(この場合は「の」の辞書画像)を抽出する。範囲拡張部114は、拡張情報テーブル103bを参照して文字「の」が基準文字となるか否かを判定する。文字「の」は基準文字とならないため、範囲拡張部114は、文字認識結果として文字「の」を出力する。
例えば、文字「さ」を表す切り出し画像が認識部104に入力された場合、選択部111は、その切り出し画像を類似度計算部112に入力する。類似度計算部112は、辞書画像テーブル103aに含まれる各辞書画像と切り出し画像との類似度を計算する。判定部113は、最大の類似度に対応する辞書画像(この場合は「さ」の辞書画像)を抽出する。範囲拡張部114は、拡張情報テーブル103bを参照して文字「さ」が基準文字となるか否かを判定する。文字「さ」は基準文字となるため、範囲拡張部114は、基準文字「さ」に対応する拡張文字「き」及び位置関係の情報を拡張情報テーブル103bから抽出し、その情報を選択部111に入力する。
選択部111は、位置関係の情報に基づいて文字「さ」の上側に位置する切り出し画像をさらに選択し、選択した切り出し画像と文字「さ」を表す切り出し画像とを組み合わせた切り出し画像を類似度計算部112に入力する。類似度計算部112は、辞書画像テーブル103aを参照し、拡張文字(この場合は「き」の辞書画像)の辞書画像と切り出し画像との類似度を計算する。判定部113は、基準文字「さ」に対する類似度と、拡張文字「き」に対する類似度とを比較する。基準文字「さ」に対する類似度の方が大きい場合、判定部113は、基準文字「さ」を文字認識結果として出力する。拡張文字「き」に対する類似度の方が大きい場合、判定部113は、基準文字「き」を文字認識結果として出力する。
なお、上記の類似度は、例えば、次のような方法で計算することができる。
1つの切り出し画像又は複数の切り出し画像の組み合わせを入力画像と呼ぶことにする。入力画像は、選択部111により選択される。類似度計算部112は、入力画像の特徴ベクトルを生成する。例えば、類似度計算部112は、入力画像の矩形領域についてラスタスキャンを実行し、各画素の値(黒は1、白は0)を並べたベクトルを特徴ベクトルとする。類似度計算部112は、類似度計算の対象とする辞書画像についても同様に特徴ベクトルを生成する。なお、辞書画像の特徴ベクトルは予め生成されていてもよい。
入力画像及び辞書画像の特徴ベクトルを生成した類似度計算部112は、これら2つの特徴ベクトルの距離を計算する。入力画像の特徴ベクトルをx、辞書画像の特徴ベクトルをyとすると、両画像の類似度Sは、例えば、下記の式(1)により計算される。但し、|x|は下記の式(2)で表現される。また、上付きのTは転置を表す。なお、2つの特徴ベクトルのハミング距離などを類似度としてもよい。ハミング距離は、2つの特徴ベクトルで値が異なる成分の数である。こうした方法により、入力画像と辞書画像との類似度を計算することができる。
以上、情報処理装置100の機能について説明した。
[2−4.処理の流れ]
次に、図9〜図11を参照しながら、情報処理装置100が実行する処理の流れについて説明する。図9は、第2実施形態に係る画像処理方法の例を示した図である。図10は、第2実施形態に係る文字認識処理方法の例を示した第1の図である。図11は、第2実施形態に係る文字認識処理方法の例を示した第2の図である。
(画像処理の流れ)
図9を参照しながら、文字認識処理の対象となる画像の取得から文字認識結果の出力までの処理について、その流れを説明する。
(S101)情報処理装置100は、画像取得部101の機能により、文字認識処理の対象となる画像を取得する。例えば、画像取得部101は、情報処理装置100に接続された外部の撮像装置、画像が記録された記録媒体、画像が格納されたネットワーク上の記憶装置などから画像を取得する。なお、情報処理装置100に撮像機能が搭載されている場合には、その撮像機能により撮像された画像を画像取得部101が取得してもよい。
(S102)情報処理装置100は、切り出し部102の機能により、S101で取得した画像を二値化して二値化画像を生成する。例えば、切り出し部102は、S101で取得した画像に含まれる各画素の画素値と所定の閾値とを比較し、画素値が所定の閾値を上回る画素に第1の値(1)を、それ以外の画素に第2の値(0)を対応付ける。所定の閾値は、画素値がとり得る範囲の中間に位置する値(例えば、127など)に設定される。
(S103)情報処理装置100は、切り出し部102の機能により、S102で生成した二値化画像を対象にラベリング処理を実行する。例えば、切り出し部102は、二値化画像の中で黒の部分が連続した画素に同じ番号(ラベル)を割り振る。切り出し部102が実行するラベリング処理の方式は任意であり、4連結や8連結などの方式が適用可能である。また、切り出し部102が実行するラベリング処理の方法は、ラスタスキャンを実行して探索した黒の画素と周辺の画素との関係からラベルを設定する方法でもよいし、黒の画素を含む閉じた領域を抽出して同じラベルを設定する方法などでもよい。
(S104)情報処理装置100は、切り出し部102の機能により、S103で設定されたラベルに基づいて文字の一部又は全部を含む矩形領域を切り出し、切り出し画像を生成する。例えば、切り出し部102は、同じラベルが設定された画素群のブロックを含む矩形領域を切り出す。このとき、切り出し部102は、複数のブロックを含む矩形領域を切り出してもよいし、個々のブロックを囲む最小の矩形領域を切り出してもよい。
(S105)情報処理装置100は、認識部104の機能により、S104で生成された切り出し画像を用いて文字認識処理を実行する。このとき、認識部104は、記憶部103が記憶する辞書画像テーブル103aを利用する。辞書画像テーブル103aには、認識対象となる文字の画像(辞書画像)が識別情報などと対応付けて記録されている。認識部104は、辞書画像テーブル103aから辞書画像を選択し、選択した辞書画像と類似する1つの切り出し画像又は複数の切り出し画像の組み合わせを抽出する。
例えば、認識部104は、1つの切り出し画像又は複数の切り出し画像の組み合わせを選択し、選択した画像と辞書画像テーブル103aに記録された各辞書画像との類似度を計算する。そして、認識部104は、選択した画像について、類似度が文字判定用の閾値を上回る辞書画像を抽出する。なお、選択した画像について類似度が文字判定用の閾値を上回る辞書画像が複数抽出された場合には類似度が最大となる辞書画像が抽出される。認識部104は、1つの切り出し画像又は複数の切り出し画像の組み合わせを順次選択して同様の処理を繰り返す。なお、S105の処理については後段において詳述する。
(S106)情報処理装置100は、S105で抽出された辞書画像に対応する文字を認識結果として出力する。S106の処理を終えると、情報処理装置100は、文字認識に係る一連の処理を終了する。
(認識処理の流れ)
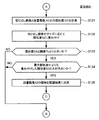
図10及び図11を参照しながら、図9のS105に対応する認識処理について、その流れを説明する。なお、図10及び図11に示す処理は、情報処理装置100が有する機能のうち、主に認識部104の機能により実現される。
(S111)認識部104は、切り出し画像を選択する。切り出し画像の選択方法としては、例えば、最初に切り出し画像を1つずつ順次選択し、次いで2つの切り出し画像の組み合わせを順次選択する方法が考えられる。3つ以上の切り出し画像の組み合わせを考慮する場合も同様である。但し、既に文字の一部又は全部として最終的に認識された切り出し画像については選択されないようにする。以下では、S111で選択された1つの切り出し画像又は複数の切り出し画像の組み合わせを単に切り出し画像と表記する。
(S112)認識部104は、S111で選択した切り出し画像と辞書画像との類似度を計算する。このとき、認識部104は、辞書画像テーブル103aに記録された辞書画像を順次読み出し、各辞書画像と切り出し画像との類似度を計算する。類似度の計算方法は、上記の式(1)に基づく計算方法であってもよいし、ハミング距離などに基づく計算方法であってもよい。
(S113)認識部104は、S112で計算した類似度の中で最大の類似度(以下、最大類似度S1)に対応する辞書画像(以下、辞書画像X1)を選択する。
(S114)認識部104は、最大類似度S1が文字判定用の閾値Thよりも大きいか否かを判定する。つまり、認識部104は、S111で選択した切り出し画像が文字である可能性が高いか否かを判定する。最大類似度S1が文字判定用の閾値Thよりも大きい場合、処理はS115に進む。一方、最大類似度S1が文字判定用の閾値Thよりも小さい場合、処理はS111に戻る。なお、文字判定用の閾値Thは予め設定されている。
(S115)認識部104は、拡張情報テーブル103bを参照し、辞書画像X1が基準文字に該当するか否かを判定する。なお、拡張情報テーブル103bに各基準文字の識別情報が記録されている場合、その識別情報と辞書画像テーブル103aに記録された識別情報とを参照することで、認識部104は、辞書画像X1が基準文字に該当するか否かを容易に判定できる。辞書画像X1が基準文字である場合、処理はS116に進む。一方、辞書画像X1が基準文字でない場合、処理はS117に進む。
(S116)認識部104は、拡張情報テーブル103bを参照し、辞書画像X1に対応する基準文字が記載された欄の位置関係を示す情報を取得する。そして、認識部104は、取得した位置関係を示す情報に基づいて切り出し範囲を拡張し、切り出し画像を再び選択する。例えば、S111で選択した切り出し画像の上方に拡張範囲が設定されている場合、認識部104は、その切り出し画像の上方に、設定された拡張範囲の分だけ拡張した切り出し範囲に含まれる切り出し画像を探索する。そして、認識部104は、拡張した切り出し範囲に含まれる切り出し画像を新たに選択する。S116の処理が終わると、処理は、図11のS119に進む。
(S117)認識部104は、辞書画像X1に対応する文字を認識結果として確定させる。つまり、S111で選択された切り出し画像が、辞書画像X1に対応する文字である可能性が十分に高く、他の文字の一部である可能性が少ない場合、認識部104は、その切り出し画像が辞書画像X1に対応する文字であると認識する。
(S118)認識部104は、全ての切り出し画像について処理を終えたか否かを判定する。全ての切り出し画像について処理を終えた場合、図9のS105に対応する認識処理は終了する。つまり、全ての切り出し画像が辞書画像のいずれかに対応する文字の一部又は全部と認識されたか、或いは、いずれでもないと認識された場合に、図9のS105に対応する認識処理は終了する。一方、全ての切り出し画像について処理を終えていない場合、処理はS111に戻り、他の切り出し画像が選択されてS112以降の処理が実行される。
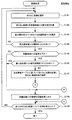
(S119)認識部104は、S116で選択した切り出し画像と辞書画像との類似度を計算する。このとき、認識部104は、辞書画像テーブル103aに記録された辞書画像のうち拡張文字に対応する辞書画像(以下、辞書画像X2)を読み出し、辞書画像X2と切り出し画像との類似度(以下、類似度S2)を計算する。類似度の計算方法は、上記の式(1)に基づく計算方法であってもよいし、ハミング距離などに基づく計算方法であってもよい。
(S120)認識部104は、類似度S2が文字判定用の閾値Thよりも大きいか否かを判定する。つまり、認識部104は、S116で選択した切り出し画像が文字である可能性が高いか否かを判定する。類似度S2が文字判定用の閾値Thよりも大きい場合、処理はS121に進む。一方、類似度S2が文字判定用の閾値Thよりも小さい場合、処理は図10のS117に戻る。
(S121)認識部104は、最大類似度S1よりも類似度S2の方が大きいか否かを判定する。つまり、認識部104は、切り出し範囲を拡張する前の切り出し画像(S111で選択した切り出し画像)と、拡張後の切り出し画像(S116で選択した切り出し画像)とで、どちらが辞書画像に対応する文字である可能性が高いかを判定する。最大類似度S1よりも類似度S2の方が大きい場合、処理はS122に進む。一方、最大類似度S1よりも類似度S2の方が小さい場合、処理は図10のS117に進む。
(S122)認識部104は、辞書画像X2に対応する文字を認識結果として確定させる。S122の処理が終わると、処理は、図10のS118に進む。
以上、情報処理装置100が実行する処理の流れについて説明した。
(変形例#1:重み付け類似度に基づく認識処理の流れ)
ここで、図12及び図13を参照しながら、第2実施形態の一変形例(変形例#1)に係る文字認識処理方法について説明する。図12は、第2実施形態の一変形例(変形例#1)に係る文字認識処理方法の例を示した第1の図である。図13は、第2実施形態の一変形例(変形例#1)に係る文字認識処理方法の例を示した第2の図である。
変形例#1は、切り出し画像と辞書画像との類似度を計算する際に、切り出し画像を囲む矩形領域のサイズに応じた重みを類似度に付与する方法を提案するものである。一例として、図12に示すように、2つの文字「F」「E」の類似度について考える。文字「F」は、文字「E」の上側部分と類似する。そのため、文字「F」は基準文字となり、文字「E」は拡張文字となる。この場合、基準範囲と拡張範囲との関係は、基準範囲の下側に拡張範囲が位置することになる。
仮に、本来は文字「E」であるが、撮像時のノイズなどの影響で「E」の一部が切断され、文字「F」に類似する部分と他の部分とに分断された切り出し画像が得られた場合を想定する。この場合、文字「F」に類似する部分の切り出し画像(以下、切り出し画像#1)が、文字「F」の辞書画像と類否判定される。図12の例では、切り出し画像#1と文字「F」との類似度が0.9である。第2実施形態に係る文字認識方法においては、ここで切り出し画像#1が基準文字であるか否かが判定される。
図12の例では、文字「F」が基準文字となるため、拡張情報テーブル103bに記録された情報(下方向を示す情報)に基づいて切り出し範囲が拡張され、切り出し画像が再び選択される。本来は文字「E」であるから、切り出し画像#1の下側に、上記他の部分に相当する切り出し画像(以下、切り出し画像#2)が得られる。そして、切り出し画像#1及び#2を組み合わせた画像と、文字「E」の辞書画像との類似度が計算される。図12の例では、類似度が0.7である。
画像の乱れが大きい場合、図12に例示したように、正解の文字よりも、その一部を誤って認識した文字の方が高い類似度となる可能性がある。例えば、汚れた文字盤から文字を読み取る場合、移動しながら撮影した画像から文字を読み取る場合、或いは、コントラストの低い画像から文字を読み取る場合などでは、画像の乱れが大きくなり、正解の文字よりも、その一部を誤って認識した文字の方が高い類似度となることがある。そこで、変形例#1に係る情報処理装置100が有する認識部104は、切り出し領域のサイズに応じた重みを計算し、その重みを付与した類似度に基づいて認識処理を実行する。
例えば、基準範囲の頂点座標がa1(0,0)、b1(1,0)、c1(1,2)、d1(0,2)であり、(基準範囲+拡張範囲)の頂点座標がa2(0,0)、b2(1,0)、c2(1,2.4)、d2(0,2.4)であると仮定する。なお、これらの頂点座標は、例えば、図8に示したような拡張情報テーブル103bに記録された位置関係の情報から得られる。この場合、基準範囲の面積は2であり、(基準範囲+拡張範囲)の面積は2.4となる。そこで、認識部104は、基準範囲と(基準範囲+拡張範囲)との面積比を計算する。この例では面積比が1.2となる。
さらに、認識部104は、予め設定しておいた重み計算用閾値(図12の例では0.5)を利用し、類似度に重みとして加算する加点を計算する。このとき、認識部104は、文字「E」の類似度と重み計算用閾値との差分を計算する。また、認識部104は、その差分に面積比をかけた値を加点とする。そして、認識部104は、文字「E」の類似度に加点を加えた値を重み付き類似度とする。
認識部104は、文字「E」の重み付き類似度と文字「F」の類似度とを比較する。この例の重み付き類似度の比較では、文字「F」の値(類似度0.9)よりも、文字「E」の値(重み付き類似度0.94)の方が大きいため、認識部104は、文字「E」を認識結果として出力する。このように、変形例#1の方法を適用すると、切り出し画像の面積比に応じて重み付けした類似度に基づいて認識結果が判定されるため、正解の文字の一部が他の文字と高い類似度を有するような場合でも、誤認識を効果的に低減することが可能になる。
上記の変形例#1に係る認識方法を適用する場合、図11に示した処理の流れは、図13に示すように変形される。つまり、図11の内容を図13の内容に差し替える形になる。以下、図13を参照しながら、変形例#1に係る認識処理の流れについて説明する。なお、図13に示したS131の処理は、図10に示したS116の処理を終えた後に実行される。
(S131)認識部104は、S116で選択した切り出し画像と辞書画像との類似度を計算する。このとき、認識部104は、辞書画像テーブル103aに記録された辞書画像のうち拡張文字に対応する辞書画像X2を読み出し、辞書画像X2と切り出し画像との類似度を計算する。類似度の計算方法は、上記の式(1)に基づく計算方法であってもよいし、ハミング距離などに基づく計算方法であってもよい。
(S132)認識部104は、切り出し画像のサイズに応じて類似度S2に重みを付ける。まず、認識部104は、図12に示した方法と同様に、S111で選択した切り出し画像に対するS116で選択した切り出し画像の面積比を計算し、その面積比を重みとする。そして、認識部104は、重みを類似度S2にかける。
(S133)認識部104は、類似度S2が文字判定用の閾値Thよりも大きいか否かを判定する。つまり、認識部104は、S116で選択した切り出し画像が文字である可能性が高いか否かを判定する。類似度S2が文字判定用の閾値Thよりも大きい場合、処理はS134に進む。一方、類似度S2が文字判定用の閾値Thよりも小さい場合、処理は図10のS117に戻る。
(S134)認識部104は、最大類似度S1よりも重み付けした類似度S2の方が大きいか否かを判定する。つまり、認識部104は、重みを考慮した上で、切り出し範囲を拡張する前の切り出し画像(S111で選択した切り出し画像)と、拡張後の切り出し画像(S116で選択した切り出し画像)とで、どちらが辞書画像に対応する文字である可能性が高いかを判定する。最大類似度S1よりも重み付けした類似度S2の方が大きい場合、処理はS135に進む。一方、最大類似度S1よりも重み付けした類似度S2の方が小さい場合、処理は図10のS117に進む。
(S135)認識部104は、辞書画像X2に対応する文字を認識結果として確定させる。S135の処理が終わると、処理は、図10のS118に進む。
以上、変形例#1に係る文字認識処理方法について説明した。
(変形例#2:類似度に応じた拡張処理の省略)
ここで、図14を参照しながら、第2実施形態の他の一変形例(変形例#2)に係る文字認識処理方法について説明する。図14は、第2実施形態の一変形例(変形例#2)に係る文字認識処理方法の例を示した図である。
変形例#2は、切り出し画像が基準文字に対応する場合であっても、その切り出し画像と基準文字に対応する辞書画像との類似度が十分に高い場合に、切り出し範囲の拡張を実行せずに認識結果を確定させる方法を提案するものである。画像の一部が乱れて文字の一部が分断されるような場合、分断された画像の一部が正解ではない他の文字と類似していたとしても、その文字を即座に認識結果として確定可能な程度に類似している場合は少ないと考えられる。逆に、基準文字に対応する辞書画像と切り出し画像との類似度が十分に高く、その基準文字を認識結果として即座に確定してもよい場合があると考える。
そこで、変形例#2では、基準文字であっても類似度が高い場合には即座に認識結果を確定できるようにする確定用閾値ThFを導入し、類似度が確定用閾値ThFを上回る場合には切り出し範囲の拡張に係る処理を省略する。変形例#2の方法を適用する場合、図10に示した処理の流れは、図14に示すように変形される。つまり、図10の内容を図14の内容に差し替える形になる。以下、図14を参照しながら、変形例#2に係る認識処理の流れについて説明する。
(S141)認識部104は、切り出し画像を選択する。切り出し画像の選択方法としては、例えば、最初に切り出し画像を1つずつ順次選択し、次いで2つの切り出し画像の組み合わせを順次選択する方法が考えられる。3つ以上の切り出し画像の組み合わせを考慮する場合も同様である。但し、既に文字の一部又は全部として最終的に認識された切り出し画像については選択されないようにする。以下では、S141で選択された1つの切り出し画像又は複数の切り出し画像の組み合わせを単に切り出し画像と表記する。
(S142)認識部104は、S141で選択した切り出し画像と辞書画像との類似度を計算する。このとき、認識部104は、辞書画像テーブル103aに記録された辞書画像を順次読み出し、各辞書画像と切り出し画像との類似度を計算する。類似度の計算方法は、上記の式(1)に基づく計算方法であってもよいし、ハミング距離などに基づく計算方法であってもよい。
(S143)認識部104は、S142で計算した類似度の中で最大の類似度(最大類似度S1)に対応する辞書画像(辞書画像X1)を選択する。
(S144)認識部104は、最大類似度S1が文字判定用の閾値Thよりも大きいか否かを判定する。つまり、認識部104は、S141で選択した切り出し画像が文字である可能性が高いか否かを判定する。最大類似度S1が文字判定用の閾値Thよりも大きい場合、処理はS145に進む。一方、最大類似度S1が文字判定用の閾値Thよりも小さい場合、処理はS141に戻る。なお、文字判定用の閾値Thは予め設定されている。
(S145)認識部104は、拡張情報テーブル103bを参照し、辞書画像X1が基準文字に該当するか否かを判定する。なお、拡張情報テーブル103bに各基準文字の識別情報が記録されている場合、その識別情報と辞書画像テーブル103aに記録された識別情報とを参照することで、認識部104は、辞書画像X1が基準文字に該当するか否かを容易に判定できる。辞書画像X1が基準文字である場合、処理はS146に進む。一方、辞書画像X1が基準文字でない場合、処理はS148に進む。
(S146)認識部104は、最大類似度S1が確定用閾値ThFよりも大きいか否かを判定する。つまり、認識部104は、S141で選択した切り出し画像の認識結果を基準文字で確定してもよいか否かを判定する。最大類似度S1が確定用閾値ThFよりも大きい場合、処理はS148に進む。一方、最大類似度S1が確定用閾値ThFよりも小さい場合、処理はS147に進む。なお、確定用閾値ThFは、文字判定用の閾値Thよりも大きい値であり、予め設定されている。
(S147)認識部104は、拡張情報テーブル103bを参照し、辞書画像X1に対応する基準文字が記載された欄の位置関係を示す情報を取得する。そして、認識部104は、取得した位置関係を示す情報に基づいて切り出し範囲を拡張し、切り出し画像を再び選択する。例えば、S141で選択した切り出し画像の上方に拡張範囲が設定されている場合、認識部104は、その切り出し画像の上方に、設定された拡張範囲の分だけ拡張した切り出し範囲に含まれる切り出し画像を探索する。そして、認識部104は、拡張した切り出し範囲に含まれる切り出し画像を新たに選択する。S147の処理が終わると、処理は、図11のS119に進む。
(S148)認識部104は、辞書画像X1に対応する文字を認識結果として確定させる。つまり、S141で選択された切り出し画像が、辞書画像X1に対応する文字である可能性が十分に高く、他の文字の一部である可能性が少ない場合、認識部104は、その切り出し画像が辞書画像X1に対応する文字であると認識する。なお、図11のノードBに処理が進んだ場合も、S148の処理が実行される。
(S149)認識部104は、全ての切り出し画像について処理を終えたか否かを判定する。全ての切り出し画像について処理を終えた場合、図9のS105に対応する認識処理は終了する。つまり、全ての切り出し画像が辞書画像のいずれかに対応する文字の一部又は全部と認識されたか、或いは、いずれでもないと認識された場合に、図9のS105に対応する認識処理は終了する。一方、全ての切り出し画像について処理を終えていない場合、処理はS141に戻り、他の切り出し画像が選択されてS142以降の処理が実行される。なお、図11のノードCに処理が進んだ場合も、S149の処理が実行される。
以上、変形例#2に係る文字認識処理方法について説明した。
以上説明したように、第2実施形態によれば、組み合わせる切り出し画像の候補を絞り込んで類否判定を実行するため、文字認識の処理負荷を低減することができる。さらに、ある文字の一部に対応する切り出し画像が他の文字に類似する場合でも、両切り出し画像の位置関係を考慮して組み合わせる切り出し画像を探索する範囲を拡張して類似度を再判定することで、誤認識が生じるリスクを低減することができる。
<3.第3実施形態(拡張情報テーブルの自動生成)>
次に、第3実施形態について説明する。第3実施形態は、拡張情報テーブル103bを自動生成する機能を情報処理装置100に追加する方法に関する。拡張情報テーブル103bの自動生成は、例えば、辞書画像テーブル103aに内容の追加や変更などがあった場合に実行される。但し、作業負担を低減させるために第3実施形態の技術を利用して拡張情報テーブル103bを自動生成する利用形態も考えられる。ここでは、一例として、辞書画像テーブル103aが更新された際に拡張情報テーブル103bを自動更新する状況を想定して説明を進めることにする。
[3−1.情報処理装置の機能]
図15及び図16を参照しながら、第3実施形態に係る情報処理装置100の機能について説明する。図15は、第3実施形態に係る情報処理装置の機能を示したブロック図である。図16は、第3実施形態に係る拡張情報テーブルの生成方法の例を示した第1の図である。なお、上述した第2実施形態に係る情報処理装置100と実質的に同じ機能を有する要素については同じ符号を付することで重複説明を省略する場合がある。
図15に示すように、情報処理装置100は、画像取得部101、切り出し部102、記憶部103、認識部104、辞書画像更新部105、及び拡張情報生成部106を有する。なお、画像取得部101、切り出し部102、記憶部103、及び認識部104の機能は、第2実施形態に係る情報処理装置100が有する各部の機能と実質的に同じである。従って、辞書画像更新部105及び拡張情報生成部106の機能について説明する。
画像取得部101、切り出し部102、認識部104、辞書画像更新部105、及び拡張情報生成部106が有する機能は、CPU902が実行するプログラムのモジュールとして実現できる。また、画像取得部101、切り出し部102、認識部104、辞書画像更新部105、及び拡張情報生成部106が有する機能の一部又は全部をソフトウェアではなく電子回路として実現することも可能である。また、記憶部103は、RAM906、記憶部920、又はリムーバブル記録媒体928に確保された記憶領域である。
(辞書画像更新部105)
辞書画像更新部105は、記憶部103が記憶する辞書画像テーブル103aの内容を更新する。例えば、辞書画像更新部105は、新たな種別の文字情報(辞書画像、識別情報、種別情報など)や、異なるフォントの辞書画像を更新情報として取得した場合、取得した更新情報を辞書画像テーブル103aに記録する。辞書画像更新部105は、例えば、ユーザが入力した更新情報をもとに辞書画像テーブル103aを更新する。また、辞書画像更新部105は、あるタイミングでネットワーク上に配置された文字情報を管理する管理サーバなどにアクセスして更新情報を自動的に取得してもよい。
更新情報を取得した辞書画像更新部105は、辞書画像、識別情報、種別情報などを対応付けて辞書画像テーブル103aに記録する。辞書画像テーブル103aの更新が完了した場合、辞書画像更新部105は、辞書画像テーブル103aの更新が完了した旨を拡張情報生成部106に通知する。このとき、辞書画像更新部105は、更新内容に関する情報(例えば、種別情報など)を拡張情報生成部106に入力する。このように、更新内容に関する情報を拡張情報生成部106に入力することで、拡張情報テーブル103bの内容を更新する際に参照する辞書画像テーブル103aの範囲が容易に把握できるようになり、拡張情報生成部106の処理負担が軽減される。
(拡張情報生成部106)
拡張情報生成部106は、辞書画像テーブル103aの更新に応じて拡張情報テーブル103bを更新する。辞書画像テーブル103aに辞書画像が追加された場合、拡張情報生成部106は、追加された辞書画像に対応する基準文字及び拡張文字の検出や、基準範囲と拡張範囲との位置関係を示す情報の生成などの処理を実行する。一方、辞書画像テーブル103aから辞書画像が削除された場合、拡張情報生成部106は、辞書画像の削除に伴って不要となった基準文字などの情報を拡張情報テーブル103bから削除する。
以下、図16を参照しながら、辞書画像が追加された場合に拡張情報生成部106が実行する基準文字、拡張文字、位置関係の情報などの生成処理について、さらに説明する。
図16の例は、辞書画像テーブル103aに数字の辞書画像が新たに追加された場合を示している。この場合、拡張情報生成部106は、ある辞書画像が、他の辞書画像の一部と類似しているか否かを判定する。まず、拡張情報生成部106は、基準文字の候補(以下、基準候補文字)として1つの文字を選択する。図16の例では、文字「0」が選択されている。次に、拡張情報生成部106は、基準候補文字とは異なる他の文字を拡張文字の候補(以下、拡張候補文字)として選択する。そして、拡張情報生成部106は、基準候補文字及び拡張候補文字を適宜サイズ調整して、拡張候補文字の一部に基準候補文字と類似する部分が存在するか否かを判定する。
例えば、拡張情報生成部106は、基準候補文字のサイズを調整しつつ、拡張候補文字の中で基準候補文字の位置を動かしながら、拡張候補文字の一部と基準候補文字との類似度を計算する。そして、拡張情報生成部106は、類似度が一定以上となる基準候補文字の位置を探索する。類似度が一定以上となる基準候補文字の位置がない場合、拡張情報生成部106は、拡張候補文字を変更し、同様にして類似度を計算する。図16の例では、基準候補文字「0」に対し、拡張候補文字「6」「8」「9」が検出されている。このように、基準候補文字と類似の部分を一部に含む拡張候補文字が検出された場合、拡張情報生成部106は、その基準候補文字を基準文字に確定し、拡張候補文字を拡張文字に確定させる。
次に、拡張情報生成部106は、拡張文字の中で基準文字に類似する部分と他の部分とをそれぞれ囲む矩形領域を設定し、前者を基準範囲、後者を拡張範囲に設定する。そして、拡張情報生成部106は、基準範囲から拡張範囲へと向かう方向を示す位置関係の情報や、基準範囲の頂点座標を決め、その頂点座標を基準に拡張範囲の頂点座標を決めて位置関係の情報に追加する。図16の例では、簡単のために、基準範囲から拡張範囲へと向かう方向だけを位置関係の情報としている。なお、基準文字「0」に対して拡張文字「8」は、上半分と下半分とに類似部分を有する。この場合、上半分を基準範囲、下半分を基準範囲とする情報と、下半分を基準範囲、上半分を基準範囲とする情報とが得られる。
拡張情報生成部106は、上記のような方法で生成された基準文字、拡張文字、及び位置関係の情報を対応付けて拡張情報テーブル103bに記録する。なお、基準範囲及び拡張範囲の頂点座標を得た場合、拡張情報生成部106は、その頂点座標を示す情報も併せて拡張情報テーブル103bに記録する。図16の例では、基準文字「0」に対して拡張文字及び位置関係の情報を生成する方法を示したが、全ての文字を基準候補文字として同様の処理が実行される。そして、拡張情報生成部106は、この処理により得た情報を拡張情報テーブル103bに記録する。図16に示した方法を応用することで、他の文字種別の辞書画像が追加された場合でも同様に拡張情報テーブル103bを自動生成できる。
以上、第3実施形態に係る情報処理装置100の機能について説明した。
[3−2.処理の流れ]
次に、図17を参照しながら、第3実施形態に係る情報処理装置100が実行する処理の流れについて説明する。但し、上述した第2実施形態に係る情報処理装置100が実行する処理とは異なる部分を中心に説明を進める。図17は、第3実施形態に係る拡張情報テーブルの生成方法の例を示した第2の図である。なお、図17に示した処理は、主に辞書画像更新部105及び拡張情報生成部106の機能により実行される。
(S201)辞書画像更新部105は、更新情報を取得する。例えば、辞書画像更新部105は、新たな文字種別やフォントの文字情報を取得する。文字情報は、例えば、辞書画像、識別情報、種別情報などを含む。辞書画像更新部105は、ユーザから入力される更新情報を取得してもよいし、あるタイミングで文字情報を管理する管理サーバなどにアクセスして自動的に更新情報を取得してもよい。更新情報を取得した辞書画像更新部105は、更新情報をもとに辞書画像テーブル103aを更新する。
(S202)拡張情報生成部106は、辞書画像テーブル103aに追加された文字の中から基準文字の候補(基準候補文字)を選択する。
(S203)拡張情報生成部106は、辞書画像テーブル103aに追加された文字のうち、基準候補文字を除く文字の中から拡張文字の候補(拡張候補文字)を選択する。
(S204)拡張情報生成部106は、拡張候補文字の中から基準候補文字に類似する部分を検出する。このとき、拡張情報生成部106は、基準候補文字のサイズを適宜調整しつつ、拡張候補文字の中で位置を移動させながら、拡張候補文字の一部と基準候補文字との類似度を計算する。
(S205)拡張情報生成部106は、拡張候補文字の中で基準候補文字との類似度が一定以上となる部分が検出されたか否かを判定する。拡張候補文字の中で基準候補文字との類似度が一定以上となる部分が検出された場合、処理はS206に進む。一方、拡張候補文字の中で基準候補文字との類似度が一定以上となる部分が検出されなかった場合、処理はS207に進む。
(S206)拡張情報生成部106は、拡張候補文字を拡張文字に設定し、基準候補文字を基準文字に設定し、拡張文字の中で基準文字に類似する部分を基準範囲に設定し、他の部分を拡張範囲に設定する。さらに、拡張情報生成部106は、基準範囲と拡張範囲との位置関係を示す情報を生成する。例えば、拡張情報生成部106は、基準範囲から拡張範囲へと向かう方向を示す情報を位置関係の情報として生成する。また、拡張情報生成部106は、基準範囲の頂点座標を基準に拡張範囲の頂点座標を生成し、その頂点座標の情報を位置関係の情報に追加する。
(S207)拡張情報生成部106は、全ての拡張候補文字についてS203以降の処理を終了したか否かを判定する。全ての拡張候補文字についてS203以降の処理を終了した場合、処理はS208に進む。一方、全ての拡張候補文字についてS203以降の処理を終了していない場合、処理はS203に戻り、他の拡張候補文字を選択してS203以降の処理が実行される。
(S208)拡張情報生成部106は、全ての基準候補文字についてS202以降の処理を終了したか否かを判定する。全ての基準候補文字についてS202以降の処理を終了した場合、処理はS209に進む。一方、全ての基準候補文字についてS202以降の処理を終了していない場合、処理はS202に戻り、他の基準候補文字を選択してS202以降の処理が実行される。
(S209)拡張情報生成部106は、基準文字、拡張文字、及び位置関係の情報を対応付けて拡張情報テーブル103bに記録する。S209の処理を終えると、拡張情報テーブル103bの自動生成に係る一連の処理は終了する。
以上、第3実施形態に係る情報処理装置100が実行する処理の流れについて説明した。
以上説明したように、第3実施形態によれば、拡張情報テーブル103bが自動生成されるため、その生成にかかる作業負担が軽減される。また、辞書画像テーブル103aが更新される度に拡張情報テーブル103bを自動生成することができるため、新しい文字種別やフォントの追加に適応した拡張情報テーブル103bを用いて文字認識を行うことが可能になる。その結果、より多くの文字種別に適応できる文字認識システムの構築が容易になる。
<4.第4実施形態(読み取り対象に応じた範囲の拡張)>
次に、第4実施形態について説明する。第4実施形態は、基準文字と拡張文字との関係だけでなく、あるパターンと他のパターンとの位置関係を利用してパターンを認識するパターン認識技術への応用を提案するものである。この提案方法を適用すれば、例えば、パターンを読み取る読み取り対象の画像が、あるフォーマットで文字や図形が記述された被写体の画像である場合に、そのフォーマットが規定するパターン間の位置関係を考慮して、より効率的に認識処理が実現される。以下、具体例を参照しながら説明を進める。
(ナンバープレートの例)
文字や図形の配置に関するフォーマットが規定されている画像としては、例えば、図18に示すような自動車などのナンバープレートがある。図18は、第4実施形態に係る拡張情報テーブルの例を示した第1の図である。ナンバープレートの場合、上段中央に分類番号が記述され、下段左側に平仮名が記載され、下段中央に車両番号が記述される。そのため、図18に示すように、拡張情報テーブル103bに、基準文字、拡張パターン、基準範囲、及び拡張範囲を対応付けておき、基準文字の検出に応じて、基準範囲をもとに拡張範囲を決定し、その拡張範囲のパターンを検出すればよい。なお、図18に示した例のように複数の範囲(範囲#1及び#2)が存在するにも対応可能である。
(道路標識の例)
文字や図形の配置に関するフォーマットが規定されている画像としては、例えば、図19に示すような道路標識などがある。図19は、第4実施形態に係る拡張情報テーブルの例を示した第2の図である。道路標識には、ある基準となるパターンと、それに付随して追加的な情報を与えるパターンとが、あるフォーマットで配置されている場合がある。例えば、パーキングの文字「P」の右側に提供サービスの種類を示す図形が表示されている場合などがある。この場合、文字「P」を基準パターン、提供サービスの種類を示す図形を含むパターンを拡張パターンとし、拡張情報テーブル103bに、基準パターン、拡張パターン、及び位置関係の情報を記録しておけばよい。このような拡張情報テーブル103bを用意すれば、第2実施形態の場合と同様に、精度良く効率的にパターンを認識することが可能になる。
以上説明したように、第4実施形態によれば、文字だけでなく、図形の形状を含むパターンの認識に第2実施形態の技術を応用することが可能になる。もちろん、第3実施形態の技術を組み合わせることも可能である。文字及び図形の形状を組み合わせたパターンの認識に応用できることで、車載カメラで撮影した画像から道路標識を読み取って運転者に警告したり、或いは、自動車の自動運転に利用したりすることも可能である。
以上、添付図面を参照しながら実施形態について説明したが、本発明の技術的範囲はかかる例に限定されない。当業者であれば、特許請求の範囲に記載された範疇内において、様々な変形例や修正例に想到し得ることは明らかであり、こうした変形例や修正例についても当然に本発明の技術的範囲に属することは言うまでもない。