JP2011237795A - 音声処理方法及び装置 - Google Patents
音声処理方法及び装置 Download PDFInfo
- Publication number
- JP2011237795A JP2011237795A JP2011100487A JP2011100487A JP2011237795A JP 2011237795 A JP2011237795 A JP 2011237795A JP 2011100487 A JP2011100487 A JP 2011100487A JP 2011100487 A JP2011100487 A JP 2011100487A JP 2011237795 A JP2011237795 A JP 2011237795A
- Authority
- JP
- Japan
- Prior art keywords
- model
- excitation
- speech
- parameters
- acoustic
- Prior art date
- Legal status (The legal status is an assumption and is not a legal conclusion. Google has not performed a legal analysis and makes no representation as to the accuracy of the status listed.)
- Pending
Links
Images

Classifications
-
- G—PHYSICS
- G10—MUSICAL INSTRUMENTS; ACOUSTICS
- G10L—SPEECH ANALYSIS TECHNIQUES OR SPEECH SYNTHESIS; SPEECH RECOGNITION; SPEECH OR VOICE PROCESSING TECHNIQUES; SPEECH OR AUDIO CODING OR DECODING
- G10L13/00—Speech synthesis; Text to speech systems
- G10L13/08—Text analysis or generation of parameters for speech synthesis out of text, e.g. grapheme to phoneme translation, prosody generation or stress or intonation determination
-
- G—PHYSICS
- G10—MUSICAL INSTRUMENTS; ACOUSTICS
- G10L—SPEECH ANALYSIS TECHNIQUES OR SPEECH SYNTHESIS; SPEECH RECOGNITION; SPEECH OR VOICE PROCESSING TECHNIQUES; SPEECH OR AUDIO CODING OR DECODING
- G10L13/00—Speech synthesis; Text to speech systems
- G10L13/02—Methods for producing synthetic speech; Speech synthesisers
-
- G—PHYSICS
- G10—MUSICAL INSTRUMENTS; ACOUSTICS
- G10L—SPEECH ANALYSIS TECHNIQUES OR SPEECH SYNTHESIS; SPEECH RECOGNITION; SPEECH OR VOICE PROCESSING TECHNIQUES; SPEECH OR AUDIO CODING OR DECODING
- G10L13/00—Speech synthesis; Text to speech systems
- G10L13/02—Methods for producing synthetic speech; Speech synthesisers
- G10L13/04—Details of speech synthesis systems, e.g. synthesiser structure or memory management
Landscapes
- Engineering & Computer Science (AREA)
- Computational Linguistics (AREA)
- Health & Medical Sciences (AREA)
- Audiology, Speech & Language Pathology (AREA)
- Human Computer Interaction (AREA)
- Physics & Mathematics (AREA)
- Acoustics & Sound (AREA)
- Multimedia (AREA)
- Compression, Expansion, Code Conversion, And Decoders (AREA)
- Machine Translation (AREA)
Abstract
【課題】音声波形の尤度を最大化するように、複数の音響モデルパラメータが複数の励振モデルパラメータと一緒に推定される音声合成方法を提供する。
【解決手段】テキスト入力を受けており、前記テキスト入力に対応する音声を確率論的モデルを使用して出力し、前記確率論的モデルは音響モデル及び励振モデルを具備し、前記音響モデルは単語または単語の部分を特徴に関連づける複数の確率分布を記述する複数のモデルパラメータを有し、前記励振モデルは、前記特徴を使用して前記音声を出力するために、声帯及び肺をモデル化するために使用される励振モデルパラメータを具備し、ここで音響パラメータ及び励振パラメータは一緒に推定され、前記音声を出力することを具備する。
【選択図】図3
【解決手段】テキスト入力を受けており、前記テキスト入力に対応する音声を確率論的モデルを使用して出力し、前記確率論的モデルは音響モデル及び励振モデルを具備し、前記音響モデルは単語または単語の部分を特徴に関連づける複数の確率分布を記述する複数のモデルパラメータを有し、前記励振モデルは、前記特徴を使用して前記音声を出力するために、声帯及び肺をモデル化するために使用される励振モデルパラメータを具備し、ここで音響パラメータ及び励振パラメータは一緒に推定され、前記音声を出力することを具備する。
【選択図】図3
Description
ここに記述された本発明の実施形態は一般に、音声合成の分野に関係がある。
音響モデルは音声合成のバックボーンとして使用される。音響モデルは、複数の単語の順序または複数の単語の部分を、複数の特徴ベクトルの配列に関連づけるために使用される。統計のパラメータの音声合成では、励振モデルは音響モデルと組み合わせて使用される。励振モデルは、より自然な音声を出力するために、肺と声帯の作用をモデル化するために使用される。
既知の統計音声合成では、ケプストラム係数のような特徴は、音声波形及びそれらのトラジェクトリから抽出され、隠れマルコフモデル(HMM)のような統計モデルによってモデル化される。統計モデルの複数のパラメータは、トレーニングデータへのその尤度を最大化するか、あるいはトレーニングデータと生成された複数の特徴との間のエラーを最小化するように推定される。合成段階では、センテンスレベルモデルは、入力テキストにしたがって、推定された統計モデルから構成され、次に、複数の特徴は、そのようなセンテンスモデルから生成され、その結果それらの出力確率を最大化するか、または目的関数を最小化する。
本発明は、下記の限定されない実施形態を参照して記述されるだろう。
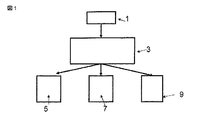
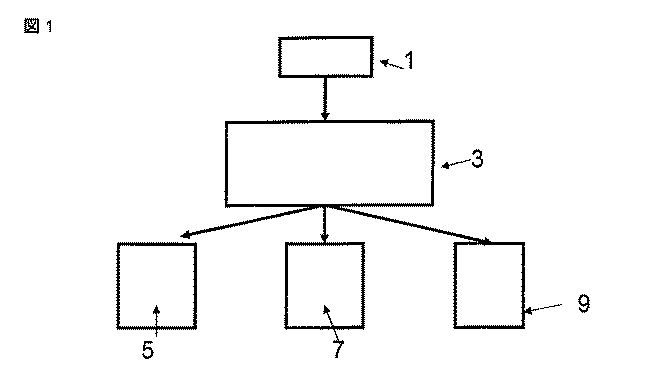
非常に基本的な音声合成システムの概略図である。
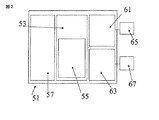
テキスト音声合成のために形成されたプロセッサのアーキテクチャの概略図である。
音声合成システムのブロック図であり、その複数のパラメータは本発明の実施形態に従って推定される。
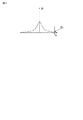
特別の単語あるいはその部分を観測に関連づけるガウス分布のプロットである。
本発明の実施形態に従って音声合成モデルをトレーニングする方法での初期化ステップを示すフローダイアグラムである。
本発明の実施形態に従って音声合成モデルをトレーニングする方法での反復ステップを示すフローダイアグラムである。
本発明の実施形態に従う音声合成の方法を示すフローダイアグラムである。
現在の音声合成システムは、しばしばソースフィルタモデルを使用する。このモデルでは、励振信号は生成されフィルタリングされる。スペクトル特徴シーケンスは、音声から抽出され、別々に音響モデルと励振モデルのパラメータを評価するために利用される。したがって、複数のスペクトル特徴は、励振モデルを考慮に入れることによって、最適化されない。また逆の場合も同じである。
本発明の発明者は、音響及び励振モデルのパラメータを推定する問題への完全に異なるアプローチをとっており、ある実施形態では、音声波形の尤度を最大化するように、複数の音響モデルパラメータが複数の励振モデルパラメータと一緒に推定される方法を提供する。
実施形態によれば、複数のスペクトル包絡線特徴から導かれるゆっくり変化する声道インパルス応答フィルタと、励振源との畳み込みによって音声が表現されることが推定される。提案されたアプローチでは、複数のスペクトル特徴の抽出は、音響及び励振のモデルの組み合わせられたトレーニングに融合する。最大尤度(ML:maximum likelihood)基準に基づく問題となっている複数のモデルの複数のパラメータの推定は、自然及び合成された音声波形との間での距離の暗黙の最小化で、本格的な波形レベル閉ループトレーニングとして見られ得る。
実施形態では、統計的なパラメータ音声合成に関する、音響及び励振のモデルの共同の推定は、最大尤度に基づいている。
生じるシステムは、トラジェクトリHMMで解析された要因として解釈されるうるものになる。共同の音響及び励振のモデルの複数のパラメータの推定に関してなされた複数の近似は、1つの最良のスペクトル係数ベクトルのトレーニング及び導出に沿って固定される状態シーケンスを固定することを具備する。
実施形態では、音響モデルの複数のパラメータは、励振モデルを考慮に入れることにより更新される。また、後者の複数のパラメータは音響モデルから生成されたスペクトルを仮定して計算される。生じるシステムは、トラジェクトリHMMで分析された要因に類似する手法で、スペクトル包絡線パラメータ抽出と、励振信号モデルとを結びつける。提案されたアプローチは、自然及び合成された音声との間での距離を最小化するための波形レベル閉ループトレーニングとして解釈されうる。
実施形態では、音響及び励振のモデルは、統計の枠組みで直接、音声波形から一緒に最適化される。
したがって、複数のパラメータは、次のように一緒に推定される。
ここでλは最適化される励振モデル及び音響モデルのパラメータを表わし、sは自然な音声波形であり、
は音声波形の表記である。
実施形態では、上記のトレーニング方法は、統計パラメトリック原理にしたがって構築された、テキストから音声への(TTS:text-to-speech)合成器に適用することができる。従って、それはまた、音声翻訳及び会話のシステムのような、上記TTSシステムが埋め込まれている任意のタスクに適用されうる。
1つの実施形態では、ソースフィルタモデルが使用され、ここでは、前記テキスト入力が前記音響モデルによって処理され、F0(基本周波数)及びスペクトルの特徴を出力する。方法は、パルス列を形成するために複数の前記F0特徴を処理し、励振信号を生成するために前記励振モデルから導かれる複数の励振パラメータを使用して前記パルス列をフィルタリングし、複数の前記スペクトル特徴から導かれる複数のフィルタパラメータを使用して前記励振信号をフィルタリングすることをさらに具備する。
複数の音響モデルパラメータは、複数の前記確率分布の複数の平均及び複数の分散を具備してもよい。前記音響モデルによって出力される複数の特徴の例は、複数のF0特徴及び複数のスペクトル特徴である。
複数の励振モデルパラメータは、複数のF0特徴及び白色雑音から導かれるパルス信号をフィルタリングする複数のフィルタ係数を具備してもよい。
実施形態では、前記共同推定処理は、再帰的な処理を具備する。この処理では、あるステップで複数の励振パラメータが複数の音響パラメータの最新の推定を使用して更新され、別のステップで複数の音響モデルパラメータが複数の励振パラメータの最新の推定を使用して更新される。好ましくは、前記共同推定処理は最大尤推定法技術を使用する。
さらなる実施形態では、前記確率論的モデルはマッピングモデルをさらに具備し、前記マッピングモデルは複数のマッピングモデルパラメータを具備し、前記マッピングモデルは、人間の声道を表す複数の係数をフィルタリングするために、複数のスペクトル特徴をマップするように構成される。好ましくは、複数のスペクトル特徴と複数のフィルタ係数との関係は、ガウスプロセスとしてモデル化される。
本発明の実施形態は、ハードウェアでも汎用コンピュータでのソフトウェアでも実行されうる。さらに、本発明は、ハードウェアとソフトウェアとの組み合わせで実行されうる。本発明はまた、単一処理装置あるいは複数の処理装置の分散型ネットワークによって実行されうる。
本発明はソフトウェアによって実行されうるので、本発明は、任意の適切なキャリア媒体で汎用コンピュータに提供されるコンピュータコードを包含する。キャリア媒体は、フロッピー(登録商標)ディスク、CD ROM、磁気デバイスあるいはプログラム可能メモリ装置のような任意の記憶媒体、あるいは任意の信号(例えば電気的、光学的、またはマイクロ波信号)のような任意の一時的な媒体(transient medium)を具備することができる。
図1は非常に基本的な音声処理システムの概略図であり、図1のシステムは音声合成のために形成された。テキストはユニット1を介して受け取られる。ユニット1は、インターネットへの接続、プロセッサから出力されたテキストへの接続、音声から音声言語処理モジュール(携帯電話など)への入力、であってもよい。ユニット1は、以前に保存されたテキストデータを含んでいるメモリによって置き換えられる。
その後、テキスト信号は、図2を参照してより詳細に記述される音声プロセッサ3に導かれる。
音声プロセッサ3は、テキスト信号を取り込み、それをテキスト信号に対応する音声に変える。出力の様々な形式が利用可能である。例えば、出力は、スピーカーに出力する直接の音声出力5の形式でもよい。これは、自動車電話、衛星ナビゲーションシステムなどで実行されうる。あるいは、出力は、オーディオファイルとして保存されてもよいし、メモリに向けられてもよい。さらに、出力は、さらなるシステム9に提供される電子音声信号の形式になりうる。
図2は、テキストを音声に変換するシステム51の基礎的なアーキテクチャを示す。テキストを音声に変換するシステム51は、プログラム55を実行するプロセッサ53を具備する。テキストを音声に変換するシステム51はさらに記憶装置57を含む。記憶装置57は、テキストを音声に変換するプログラム55によって使用されるデータを格納する。テキストを音声に変換するシステム51は、入力モジュール61及び出力モジュール63をさらに具備する。入力モジュール61はテキスト入力65に接続される。テキスト入力65はテキストを受け取る。テキスト入力65は例えばキーボードでもよい。
あるいは、テキスト入力65は、外部記憶媒体あるいはネットワークからテキストデータを受け取る手段でもよい。
オーディオ67のための出力が出力モジュール63に接続される。音声出力67は、テキスト入力からテキスト入力63に変換された音声信号を出力するために使用される。音声出力67は、例えば直接の音声出力(例えば、記憶媒体、ネットワーク等に送られる音声データファイルのための出力、またはスピーカー)でもよい。
使用中では、テキストを音声に変換するシステム51は、テキスト入力63を介してテキストを受け取る。プロセッサ53で実行されるプログラム55は、記憶装置57に格納されるデータを使用して、テキストを音声データに変換する。音声は、音声出力67に出力モジュール65を介して出力される。
図3は音声生成のモデルの概略図である。モデルには2つのサブモデルがある。音響モデル101、及び励振モデル103である。
単語あるいはその部分が特徴または特徴ベクトルに変換される場合、音響モデルは、音声合成の技術においてよく知られている。この実施形態では、隠れマルコフモデル(HMM)に基づく音響モデルが使用される。しかしながら、他のモデルを使用することができるかもしれない。
この実施形態で使用される実際のモデルは、標準モデルである。モデルの詳細はこの特許出願の範囲外である。しかしながら、モデルは、単語あるいはその部分に関係している特徴ベクトルによって表わされる観測の可能性に関係のある確率密度関数(pdfs)の提供を要求するだろう。一般に、この確率分布はn次元空間でのガウス分布になるだろう。
一般的なガウス分布の概要の例は図4に示される。ここで、水平軸は1次元での入力ベクトルのパラメータに対応する。また確率分布は、観測に関係のある特別の単語あるいはその部分に関する。例えば、図4では、特徴ベクトルxに対応する観測は、その確率分布が図4に示される単語に対応する確率p1を有する。ガウス分布の形状及び位置はその平均と分散とによって定義される。これらのパラメータは、語いに関するトレーニングの間に決定される。それらは音響モデルに関する「モデルパラメータ」と呼ばれるだろう。
音声へ出力されることになっているテキストは、最初に複数の電話ラベルに変換される。電話ラベルは、その音素に関する文脈情報を備えた音素を含む。文脈情報の例は、先行し後続する複数の音素、音素の単語内での位置、文での単語の位置などである。その後、音素ラベルは音響モデルに入力される。
音響モデルHMMの出力、一旦複数のモデルパラメータが決定されると、複数の単語の順序または複数の単語の部分に対応する観測の順序の尤度を決定するために、モデルを使用することができる。
特にこの実施形態では、音響モデル101の出力である特徴はF0特徴及びスペクトルの特徴である。この実施形態では、複数のスペクトル特徴はケプストラム係数である。しかしながら、他の実施形態では、他の複数のスペクトル特徴が、線形予測係数(LPC)、線スペクトルペア(LSP)及びそれらの周波数が歪んだバージョンのように、使用される。
複数のスペクトル特徴は、hc(n)として表現された声道フィルタ係数を形成するために変換される。
生成された複数のF0特徴はパルス列シーケンスt(n)に変換される。また、F0値によれば、パルス列間の期間は決定される。
例えば、パルス列は時間領域での信号のシーケンスである:例えば
0100010000100
ここで1はパルスである。人間の声帯は、有声発話のための複数の周期信号を生成するために振動する。パルス列シーケンスはこれらの周期信号に近づけるために使用される。
0100010000100
ここで1はパルスである。人間の声帯は、有声発話のための複数の周期信号を生成するために振動する。パルス列シーケンスはこれらの周期信号に近づけるために使用される。
白色雑音励起シーケンスw(n)は白色ノイズ発生器(図示せず)から生成される。
パルス列t(n)及び白色雑音シーケンスw(n)は、励振モデルパラメータHv(z)及びHu(z)によってそれぞれフィルタリングされる。励振モデルパラメータは励振モデル105から生成される。Hv(z)は、有声インパルス応答フィルタ係数を表わし、それが声門の動作を表わすので、時々「声門フィルタ」と呼ばれる。Hu(z)は無声フィルタ応答係数を表わす。Hv(z)及びHu(z)はともに肺と声帯をモデル化する励振パラメータである。
時間領域信号である有声励振信号v(n)は、フィルタリングされたパルス列から生成される。また、さらに時間領域信号である無声励振信号u(n)は、白色雑音w(n)から生成される。これらの信号v(n)及びu(n)は、混合されて(加算され)て、時間領域での複数の混合励振信号e(n)からなる。
最後に、複数の励振信号e(n)は、上で説明したように導かれる複数のスペクトル特徴から導かれるインパルス応答Hc(z)によってフィルタリングされ、音声波形s(n)を得る。
音声合成ソフトウェア製品では、製品は、平均と分散のような音響モデルパラメータと共に、Hv(z)及びHu(z)の係数を含んでいるメモリを具備する。製品はさらに、音響モデルから出力された複数のスペクトル特徴がHc(z)に変換されることを可能にするデータを含むだろう。複数のスペクトル特徴が複数のケプストラム係数である場合、Hc(z)へのスペクトル特徴の変換は決定論的で、確率論的モデルをトレーニングするために使用されるデータの性質に依存しない。
しかしながら、スペクトル特徴が、線形予測係数(LPC)、線スペクトルペア(LSP)及びそれらの周波数が歪んだバージョンのような他の特徴を具備する場合は、スペクトル特徴とHc(z)との間でのマッピングは、決定論的でなく、音響及び励振パラメータが推定される場合に推定される必要がある。しかしながら、スペクトル特徴とHc(z)との間のマッピングが、決定論的であるか、マッピングモデルを使用して推定されるかに関わらず、好ましい実施形態では、ソフトウェア合成製品は、スペクトル特徴をHc(z)に変換するために必要とされる情報をちょうど具備するだろう。
音声合成システムのトレーニングは、複数のモデルの複数のパラメータを評価することを含んでいる。上記のシステムでは、音響、励振及び写像のモデルパラメータは、推定されることになっている。しかしながら、マッピングモデルパラメータを取り除くことができることは注意されるべきである。また、これは後で記述されるだろう。
本発明の実施形態に従うトレーニング方法では、音響モデルパラメータ及び励振モデルパラメータは、同じプロセスで同時に推定される。
違いを理解するために、これらのパラメータを推定するための従来のフレームワークが最初に記述される。
既知の統計パラメータの音声合成では、最初に、音声特徴の「スーパーベクトル」
が音声波形から抽出される。ここで、
フレームtでのC次の音声パラメータベクトルであり、Tは全フレーム数である。音響モデルパラメータの推定は、ML基準を介して通常行われる:
ここで、
は音声波形の表記であり、λcは1セットの音響モデルパラメータを示す。
合成中に、音声特徴ベクトルc’は、合成された
になるある与えられたテキストに関して、その出力確率を最大化するように、合成されるために生成される。
F0及び恐らくは期間と共のこれらの特徴は、図3を参照して説明されるように、ソースフィルタ生成アプローチを使用することによって、音声波形を生成するために利用される。
本発明の実施形態に従うトレーニング方法は、異なるアプローチを使用する。任意の音声合成装置の意図が、できる限り音声波形を模倣することであるので、本発明の実施形態では波形レベルで定義された統計モデルが提案される。提案されたモデルのパラメータは、波形それ自身の尤度を最大化するように推定される。すなわち、
ここで、
は音声波形全体を含んでいるベクトルである。s(n)はサンプルnの波形値である。Nはサンプル数である。また、λは、共同の音響励振モデルのパラメータのセットを示す。
2つの隠れた変数:状態シーケンスq={q0、……、qT−1}(離散的)、スペクトルパラメータ
(連続的)を導入することによって、式(3)は次のように書き直すことができる:
ここでqtはフレームtでの状態である。
式(5)の項、p(s|c,q,λ)、p(c|q,λ)、p(q|l,λ)を、以下のように別々に分析することができる。
・p(s|c,q,λ):この確率は、スペクトル特徴とある与えられた状態シーケンスからの音声波形生成に関する。λに関するこの確率の最大化は、スペクトルモデルパラメタのML推定と密接な関係がある。この確率は想定された音声信号生成モデルに関連する。
・p(c|q,λ):この確率は、HMMあるいは隠れた半マルコフモデル(HSMM)がその音響モデルとして使用される場合、複数の音声パラメータベクトルの複数の状態出力確率の積として与えられる。トラジェクトリHMMが使用される場合、この確率は全体の音声パラメータベクトルの状態シーケンス出力確率として与えられる。
・p(q|l,λ):この確率は表記
に関して状態シーケンスqの確率を与える。HSMMまたはトラジェクトリHSMMが使用される場合、それは状態遷移及び状態持続の両方の確率を含む。
HMM、HSMMあるいはトラジェクトリHMMのような既存する音響モデルを使用してp(c|q,λ)、p(q|l,λ)をモデル化することが可能である。問題はp(s|c,q,λ)をどのようにモデル化するかである。
音声信号が図4のダイアグラムによって生成されると仮定されている、つまり、
ここで*は線形の畳み込みを示し、
・hc(n):声道フィルタインパルス応答である。
・hc(n):声道フィルタインパルス応答である。
・t(n):パルス列である。
・w(n):平均0及び分散1を備えたガウスの白色雑音シーケンスである。
・hv(n):有声フィルタインパルス応答である。
・hu(n):無声フィルタ・インパルス応答である
ここで、声道、有声及び無声フィルタは、z−変換領域で次の形をそれぞれ持つと仮定される:
ここで、声道、有声及び無声フィルタは、z−変換領域で次の形をそれぞれ持つと仮定される:
ここでP、M及びLはそれぞれHc(z)、Hv(z)及びHu(z)のオーダーである。フィルタHc(z)は、最小位相応答を有していると見なされる。なぜならそれが声道フィルタのインパルス応答を表わすからである。さらに、Hu(z)の係数が、R. Maia, T. Toda, H. Zen, Y. Nakaku, and K. Tokuda, "An excitation model for HMM-based speech synthesis based on residual modelling," in Proc. of the 6th ISCA Workshop on Speech Synthesis, 2007で説明されるアプローチによって計算される場合は、Hc(z)もまた、最小位相応答を有している。上記の発生モデルの複数のパラメータは、声道、有声及び無声のフィルタ、Hc(z)、Hv(z)及びHu(z)、及び、t(n)の位置及び振幅、
(Zはパルス数)を具備する。Hv(z)及びHu(z)を推定するいくつかの方法があるが、この報告書は、R. Maia, T. Toda, H. Zen, Y. Nakaku, and K. Tokuda, "An excitation model for HMM-based speech synthesis based on residual modelling," in Proc. of the 6th ISCA Workshop on Speech Synthesis, 2007に述べられていた方法に基づくだろう。
それぞれ行列及びベクトルを意味する大文字及び小文字の頭文字と共に、行列表記法を使用して、式(6)は次のように書くことができる。
ここで、
ベクトルsuは
のサンプルを含んでいる。そして、ベクトルsuは、次の共分散行列と共に、音声信号の有声領域に関するモデルのエラーとして解釈されうる。
ここで、
w(n)がガウスの白色雑音であるので、u(n)=hu(n)*w(n)は正規分布した確率過程になる。ベクトル表記法の使用によって、確率uは以下になる。
ここでN(x;μ,Σ)は、平均ベクトルμ及び共分散行列Σを備えたxのガウス分布である。したがって、
なので、音声ベクトルsの確率は以下になる。
Hcの最後のP行が無視される(それは、サンプル
を生成するHc(z)のゼロインパルス応答を無視することを意味する)場合、Hcは、式(24)が次式(25)に書き直される次元(N+M)x(N+M)を有する正方になる。
ここで、
は音声生成モデルの励起モデル部分のパラメータである。Hc(z)による逆フィルタリングを介して音声信号s(n)から抽出される項
が残りのシーケンスに対応することに注意することは興味深い。
R. Maia, T. Toda, H. Zen, Y. Nakaku, and K. Tokuda, "An excitation model for HMM-based speech synthesis based on residual modelling," in Proc. of the 6th ISCA Workshop on Speech Synthesis, 2007で提案されたように、HvとHuが状態依存パラメータ結束構造を有すると仮定することによって、式(25)は次式に書き直される。
ここで、Hv,q及びGqは、状態シーケンスqに関して、それぞれ有声フィルタ及び逆無声フィルタインパルス応答行列である。
声道インパルス応答Hc(あるいはHc(z)の複数の係数)とスペクトル特徴cとの間に1対1の関係が通常ある。しかしながら、いくつかのスペクトル特徴の表現に関する閉じた形式でのcから、Hcを計算することは難しい。この問題に取り組むために、確率近似がcとHcとの関係をモデル化するために導入される。cとHcとの間のマッピングが、確率p(Hc|c,q,λh)を有するガウスプロセス(ここでλhはスペクトル特徴を声道フィルタインパルス応答にマッピングするモデルのパラメータセットである)によって表現されると考えられるならば、p(s|c,q,λe)は以下になる。
ここで、fq(c)はcをHcに変換するための近似された関数であり、Ωqは問題となっているガウス分布の共分散行列である。この表現は、Hcがcから閉じた形式でその特別な場合として計算されうる場合(すなわち、fq(c)は閉じた形式でマッピング関数になり、Ωqはゼロ行列になる)を含んでいる。結果として生じるモデルは、fq(c)に関する線形関数が利用され、それはqに依存するパラメータ共有構造を有している場合に、共有の因子分析モデルに非常に類似していることに注目することは興味深い。
トラジェクトリHMMが音響モデルp(c|l,λc)として使用される場合に、p(c|q,λc)及びp(q|l,λc)は次のように定義され得る。
ここで、πiは状態iの初期状態確率であり、αijは状態iから状態jへの状態遷移確率であり、
及びPqはqに関するトラジェクトリHMMの平均ベクトル及び共分散行列に対応する。式(29)では、
及びPqは以下のように与えられる。
ここでWは典型的には、力学的な特徴(速度及び加速度の特徴)とcに付加する3T(C+1)xT(C+1)ウィンドウ行列である。例えば、ct、Δ(0)ct、Δ(1)ct及びΔ(2)ctの静的な、速度の、加速度の特徴は次のように計算される。
このとき、Wは以下のとおりである。
ここでIと0は、(C+1)x(C+1)の単位行列及びゼロ行列に対応する。式(32)及び式(33)でのμq及び
は、状態シーケンスqに関して、3T(C+1)x1の平均パラメータベクトル及び3T(C+1)x3T(C+1)の精度パラメータ行列に対応していて、次式で与えられる。
ここで、μiとΣiは、状態iに関して、3(C+1)の平均パラメータベクトル及び3(C+1)x3(C+1)の精度パラメータ行列が対応し、Y=diag{X1、…、XD}は行列{X1、…、XD}がYの対角なサブ行列であることを意味する。平均パラメータベクトル及び精度パラメータ行列は以下で定義される。
ここでΔ(j)μi及び
は、状態iと関連して、(C+1)x1の平均パラメータベクトル及び(C+1)x(C+1)の精度パラメータ行列に対応する。
最終のパラメータモデルは、マッピングモデルを介して音響及び励振のモデルを組み合わせることによって以下のように得られる:
ここで、
ここで、λ={λe,λh,λc}
ケプストラム係数、線形予測係数(LPC)、線スペクトルペア(LSP)及びそれらの周波数が歪んだバージョンのような様々な可能なスペクトル特徴がある。この実施形態では、ケプストラム係数は特殊な場合と見なされる。ケプストラム係数ベクトル
ケプストラム係数、線形予測係数(LPC)、線スペクトルペア(LSP)及びそれらの周波数が歪んだバージョンのような様々な可能なスペクトル特徴がある。この実施形態では、ケプストラム係数は特殊な場合と見なされる。ケプストラム係数ベクトル
からその対応する声道フィルタインパルス応答ベクトル
へのマッピングは以下のような閉じた形式で書かれうる。
ここでEXP [.]は、[.]の要素の指数関数をとることによって導かれる行列を意味し、Dは(P+1)x(C+1)のDFT(離散フーリエ変換)行列であり、
ここで
また、D*は、次の形式を備えた(P+1)x(P+1)のIDFT(逆離散フーリエ変換)行列である。
ケプストラム係数と声道フィルタ応答との間のマッピングとして、閉じた形式でのコンピュータがあり得る。cとHcとの間の確率近似を使用する必要はない。式(10)の生成モデルに現れる声道フィルタインパルス応答関連の項はHCでありhcでない。式(12)及び(13)として与えられたHCとhcとの間の関係は以下で与えられる。
hc、tはt番目のフレームの合成フィルタインパルス応答であり、Tは全フレーム数であり、以下のように書かれうる。
式(53)では、Nは(データベースの)サンプル数であり、
ここでBは、フレーム基底hcベクトルをサンプル基底にマッピングするためのN(P+1)xT(P+1)行列である。
最後のP行を無視することにより、Hcの正方バージョンが考慮されることは注目すべきである。NxN(P+1)行列Jnは以下のように構築される。
ここで、0X,YはX行Y列でのゼロ要素の行列を意味し、IXはXサイズの単位行列である。
モデルのトレーニングは今、図5及び6を参照して説明される。
トレーニングは、共同モデルλのパラメータが次のように推定されることを可能にする:
ここで、励振モデルのパラメータに対応するλe={Hv、G、t}でλ={λe,λh,λc}であり、音響モデルのパラメータを構成するλ={m,σ}、
ここでSは状態数である。mとσはそれぞれ、全ての状態の逆共分散行列の全ての平均及び対角を連結させることによって形成されるベクトルである。ここでvdiag{[.]}は[.]の対角要素によって形成されるベクトルを意味している。スペクトル特徴としてのケプストラム係数を仮定する尤度関数p(s|l,λ)は、以下のようになる。
残念ながら、期待値最大化(EM:expectation-maximization)を介するこのモデルの推定は、解決困難である。したがって、近似の再帰的なアプローチが採用される。
式(62)での全ての可能なqに渡る和が固定された状態シーケンスによって近似される場合には、上記の尤度関数は以下になる。
ここで、
は状態シーケンスである。さらに、全ての可能なcに渡る積分がスペクトルベクトル及びインパルス応答ベクトルによって近似される場合には、式(63)は以下になる。
ここで、
は固定スペクトル応答ベクトルである。
式(64)の対数を取ること、または最大化されるコスト関数によって、音響、励振、及びマッピングモデルパラメータの更新を介して、以下が得られる。
最適化問題は2つの部分へ分割されうる:初期化と反復である。以下は、各部分で行なわれる計算について説明する。初期化は、図5を参照して説明され、反復は図6を参照して説明される。
モデルは、対応するテキストデータを備えた音声データであり、ステップS210で入力されるトレーニングデータを使用してトレーニングされる。
パート1−初期化
1.ステップS203では、音声データは最初の1つのケプストラム係数ベクトルから抽出される。
1.ステップS203では、音声データは最初の1つのケプストラム係数ベクトルから抽出される。
2.ステップS205では、トラジェクトリHMMパラメータλcはcを使用してトレーニングされる。
3.ステップS207では、最良の状態シーケンス
は、H. Zen, K. Tokuda, and T. Kitamura, "Reformulating the HMM as a trajectory model by imposing explicit relationships between static and dynamic feature vector sequence," Computer Speech and Language, vol. 21, pp. 153-173, Jan. 2007のアルゴリズムを使用することによって、トレーニングされたモデルからビタビパスとして決定される。
4.ステップS209では、
及びcを仮定して、マッピングモデルパラメータλhは推定される。
5.ステップS211では、R. Maia, T. Toda, H. Zen, Y. Nakaku, and K. Tokuda, "An excitation model for HMM-based speech synthesis based on residual modelling," in Proc. of the 6th ISCA Workshop on Speech Synthesis, 2007で記述されているアルゴリズムの1回の反復を使用することによって、励振パラメータλeは
及びcを仮定して、評価される。
部分2:反復
1.図6のステップS213では、最良のケプストラム係数ベクトル
1.図6のステップS213では、最良のケプストラム係数ベクトル
は式(65)の対数尤度関数を使用して推定される。
2.ステップS215では、声道フィルタインパルス応答Hcは
及び
を仮定して推定される。
3.ステップS217では、励振モデルパラメータλeは、
及び
を仮定して更新される。
4.ステップS219では、音響モデルパラメータが更新される。
5.ステップS221では、マッピングモデルパラメータが更新される。
再帰的なステップは数回繰り返されてもよい。以下では、それらの内のそれぞれ1つが詳細に説明される。
反復は収束までに終了する。収束は多くの異なった方法で決定されてもよい。一実施形態では、尤度での変化が所定の最小値よりも小さい場合に収束は生じたと見なされるだろう。例えば、尤度Lでの変化が5%未満である。
反復のステップ1 S213では、ケプストラム係数がスペクトル特徴として使用される場合には、式(65)の尤度関数は次のように書かれる。
cに依存する項が選択され、以下によって与えられるコスト関数hcを構成する。
最良のケプストラム係数ベクトル
は、コスト関数hcを最大にするものとして定義されうる。最急勾配傾斜アルゴリズム(steepest gradient ascent algorithm)(例えばJ. Nocedal and S. J. Wright, Numerical Optimization. Springer, 1999を参照)、またはBroyden Fletcher Goldfarb Shanno (BFGS)アルゴリズムのような別の最適化方法を利用することによって、
に関するそれぞれの更新は以下によって計算することができる。
ここでγは収束ファクタ(定数)であり、iは反復インデックスであり、そして、
ここで、Diag([.])はベクトル[.]の要素で形成される対角行列を意味し、
上記では、反復過程は収束まで継続する。好ましい実施形態では、連続する反復間の差が5%未満である場合に、収束が生じている。
再帰的手続きのステップ3 S217では、励振パラメータλe={Hv、G、G}は、R. Maia, T. Toda, H. Zen, Y. Nakaku, and K. Tokuda, "An excitation model for HMM-based speech synthesis based on residual modelling," in Proc. Of the 6th ISCA Workshop on Speech Synthesis, 2007で説明されるアルゴリズムの1つの反復の使用により計算される。
この場合、推定されたケプストラム係数ベクトル
は、残差ベクトル
を逆フィルタリングを介して抽出するために使用される。
ステップ4 S219では、音響モデルパラメータの推定λ={m,σ}は、観測として最良に推定されたケプストラムベクトル
を利用することによって、H. Zen, K. Tokuda, and T. Kitamura, "Reformulating the HMM as a trajectory model by imposing explicit relationships between static and dynamic feature vector sequence," Computer Speech and Language, vol. 21, pp. 153-173, Jan. 2007に記述されたようになされる。
上記のトレーニング方法は、マッピングモデルの1セットのモデルパラメータλhを使用して、fq(c)によって予測されたHcの不確定性について記述する。
しかしながら、他の実施形態では、決定論的な場合が仮定され、fq(c)が完全にHcを予測する。この実施形態では、Hcとfq(c)との間に不確定性はなく、したがって、λhはもはや必要ではない。
そのようなシナリオでは、マッピングモデルパラメータは図5のステップS209でゼロに設定され、図6のステップS221で再度推定されない。
図7は、本発明の実施形態で用いる音声合成方法のフローチャートである。
テキストはステップS251で入力される。音響モデルはこのテキスト上で実行され、スペクトル特徴及びF0特徴を含む特徴はステップS253で抽出される。
インパルス応答フィルタ関数は、ステップS253で抽出されたスペクトル特徴からステップS255で生成される。
入力テキストもまた励振モデルに入力される。また、励振モデルパラメータはステップS257で入力テキストから生成される。
ステップS253で抽出された特徴に戻って、この段階で抽出されたF0特徴はステップS259でのパルス列に変換される。パルス列はステップS257で生成された有声フィルタ関数を使用してフィルタリングされる。
白色雑音は白色ノイズ発生器によって生成される。その後、白色雑音はステップS257で生成された無声フィルタ関数を使用して、ステップS263でフィルタリングされる。
その後、ステップS261で生成された有声励振信号、及びステップS263で生成された無声励振信号は、ステップS265での混合励振信号を生成するために混合される。
その後、混合励振信号は、ステップS255で生成されたインパルス応答を使用して、ステップS267でフィルタリングされる。また、音声信号が出力される。
共同の最適化を介して音響及び励振モデルをトレーニングすることによって、位相情報のような音声パラメータ抽出の間に失われる情報は、自然な音声により近づいて聞こえる合成音声になって、実行時間で回復されるかもしれない。したがって、統計パラメータのテキストを音声に変換するシステムは、自然な音声に非常に似ているように聞こえる合成音声を生産する能力で生産されうる。
ある実施形態は記述されているが、これらの実施形態は例のみによって提示されていて、発明の範囲を制限するようには意図されない。実際、ここに記述された新しい方法及びシステムは様々な他の形式で具体化されてもよい。更に、ここに記述された方法及びシステムの形式での様々な省略、置換及び変更は、添付されたクレームによって定義されるような発明の範囲から外れずになされてもよい。
Claims (19)
- テキスト入力を受け取り、確率論的モデルを使用して前記テキスト入力に対応する音声を出力し、前記確率論的モデルは音響モデルと励振モデルとを具備し、前記音響モデルは単語または単語の部分をある特徴に関連づける複数の確率分布を記述する複数のモデルパラメータを有し、前記励振モデルは声帯及び肺をモデル化して特徴を使用して音声を出力するために使用される励振モデルパラメータを具備し、
前記音響パラメータ及び前記励振パラメータは一緒に推定され、
前記音声を出力することを具備する音声処理方法。 - 前記テキスト入力は、前記音響モデルによって処理され、F0及びスペクトルの特徴を出力し、
パルス列を形成するために前記F0特徴を処理し、
励振信号を生成するために前記励振モデルから導かれる複数の励振パラメータを使用して前記パルス列をフィルタリングし、
前記スペクトル特徴から導かれる複数のフィルタパラメータを使用して前記励振信号をフィルタリングすることをさらに具備する請求項1に記載の音声合成方法。 - 音声合成に関する統計モデルをトレーニングする方法であって、
トレーニングデータを受け取り、前記トレーニングデータは音声と前記音声に対応するテキストとを具備し、
確率論的モデルをトレーニングし、前記確率論的モデルは音響モデルと励振モデルとを具備し、前記音響モデルは単語またはその単語の部分を特徴ベクトルに関連づける複数の確率分布を記述する複数のモデルパラメータを有していて、前記励振モデルは声帯及び肺をモデル化して前記音声を出力する複数の励振モデルパラメータを具備し、
前記音響パラメータ及び前記励振パラメータはトレーニング処理の間に一緒に推定される方法。 - 前記音響モデルパラメータは、前記確率分布の平均と分散とを具備する請求項3に記載の方法。
- 前記音響モデルによって出力される前記特徴はF0特徴とスペクトル特徴を具備する請求項3に記載の方法。
- 前記励振モデルパラメータは、F0特徴から導かれるパルス信号をフィルタリングするフィルタ係数を具備する請求項5に記載の方法。
- 共同に推定する処理は、再帰的な処理を具備し、
1つのステップでは励振パラメータが音響パラメータの最新の推定を使用して更新され、別のステップでは音響モデルパラメータが励振パラメータの前記最新の推定を使用して更新される請求項3に記載の方法。 - 共同に推定する処理は、最大尤度技術を使用する請求項3に記載の方法。
- 前記確率論的モデルは、マッピングモデルをさらに具備し、前記マッピングモデルは複数のマッピングモデルパラメータを具備し、前記マッピングモデルは複数のスペクトル特徴を、人間の声道を表現する複数のフィルタ係数にマッピングする請求項5に記載の方法。
- 前記パラメータは以下のように一緒に推定され、
- λは、人間の声道を表現するために、複数のスペクトルパラメータをフィルタ関数にマッピングするマッピングモデルの複数のパラメータをさらに具備する請求項10に記載の方法。
- 前記スペクトル特徴とフィルタ係数との間の関係は、ガウスプロセスとしてモデル化される請求項11に記載の方法。
- p(s|l,λ)は以下のように表され、
- qに渡る和は固定された状態シーケンスによって近似されて次を与え、
- 前記全ての可能なHc及びcに渡る積分は、スペクトル応答及びインパルス応答のベクトルによって近似され、次を与え、
- p(s|l,λ)の対数尤度関数は以下
- コンピュータを制御して、請求項1から請求項16のいずれか1項の方法を実行させるコンピュータ読み取り可能な指示を運ぶキャリア媒体。
- 単語のシーケンスを具備するテキスト入力を受け取るレシーバーと、
プロセッサと、を具備し、前記プロセッサは前記入力テキストに対応する出力音声の尤度を確率論的モデルを使用して判定し、前記確率論的モデルは音響モデルと励振モデルを具備し、前記音響モデルは単語または単語の部分と特徴とを関連づける複数の確率分布を記述する複数のモデルパラメータを有して、前記励振モデルは、前記声帯及び肺をモデル化して前記特徴を使用して前記音声を出力するために使用される複数の励振モデルパラメータを具備し、
前記音響パラメータ及び励振パラメータは一緒に推定され、前記装置は前記音声のための出力を具備する音声処理装置。 - 入力音声認識部と、翻訳部と、請求項18に記載の音声合成装置と、を具備する音声翻訳システム。
Applications Claiming Priority (2)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| GB1007705.5A GB2480108B (en) | 2010-05-07 | 2010-05-07 | A speech processing method an apparatus |
| GB1007705.5 | 2010-05-07 |
Publications (1)
| Publication Number | Publication Date |
|---|---|
| JP2011237795A true JP2011237795A (ja) | 2011-11-24 |
Family
ID=42315018
Family Applications (1)
| Application Number | Title | Priority Date | Filing Date |
|---|---|---|---|
| JP2011100487A Pending JP2011237795A (ja) | 2010-05-07 | 2011-04-28 | 音声処理方法及び装置 |
Country Status (3)
| Country | Link |
|---|---|
| US (1) | US20110276332A1 (ja) |
| JP (1) | JP2011237795A (ja) |
| GB (1) | GB2480108B (ja) |
Cited By (4)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| JP2014056235A (ja) * | 2012-07-18 | 2014-03-27 | Toshiba Corp | 音声処理システム |
| WO2016080713A1 (ko) * | 2014-11-18 | 2016-05-26 | 박남태 | 음성제어 영상표시 장치 및 영상표시 장치의 음성제어 방법 |
| WO2017046887A1 (ja) * | 2015-09-16 | 2017-03-23 | 株式会社東芝 | 音声合成装置、音声合成方法、音声合成プログラム、音声合成モデル学習装置、音声合成モデル学習方法及び音声合成モデル学習プログラム |
| JP2021010156A (ja) * | 2019-06-28 | 2021-01-28 | ベイジン バイドゥ ネットコム サイエンス アンド テクノロジー カンパニー リミテッド | 情報を生成する方法および装置 |
Families Citing this family (6)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| US9865247B2 (en) * | 2014-07-03 | 2018-01-09 | Google Inc. | Devices and methods for use of phase information in speech synthesis systems |
| US9972310B2 (en) * | 2015-12-31 | 2018-05-15 | Interactive Intelligence Group, Inc. | System and method for neural network based feature extraction for acoustic model development |
| WO2020162392A1 (ja) * | 2019-02-06 | 2020-08-13 | ヤマハ株式会社 | 音信号合成方法およびニューラルネットワークの訓練方法 |
| JP7088403B2 (ja) * | 2019-02-20 | 2022-06-21 | ヤマハ株式会社 | 音信号生成方法、生成モデルの訓練方法、音信号生成システムおよびプログラム |
| CN113823257B (zh) * | 2021-06-18 | 2024-02-09 | 腾讯科技(深圳)有限公司 | 语音合成器的构建方法、语音合成方法及装置 |
| US20250054489A1 (en) * | 2023-08-09 | 2025-02-13 | Ashwin Rao | System and Method for Mapping Phonemes to Acoustic Symbols and Codes |
Citations (3)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| WO2003042648A1 (en) * | 2001-11-16 | 2003-05-22 | Matsushita Electric Industrial Co., Ltd. | Speech encoder, speech decoder, speech encoding method, and speech decoding method |
| JP2006119655A (ja) * | 2005-11-21 | 2006-05-11 | Yamaha Corp | 音声合成装置 |
| JP2007140002A (ja) * | 2005-11-17 | 2007-06-07 | Oki Electric Ind Co Ltd | 音声合成装置,音声合成方法,およびコンピュータプログラム |
Family Cites Families (16)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| JPS6054680B2 (ja) * | 1981-07-16 | 1985-11-30 | カシオ計算機株式会社 | Lsp音声合成装置 |
| US5060269A (en) * | 1989-05-18 | 1991-10-22 | General Electric Company | Hybrid switched multi-pulse/stochastic speech coding technique |
| DE4111995A1 (de) * | 1991-04-12 | 1992-10-15 | Philips Patentverwaltung | Schaltungsanordnung zur spracherkennung |
| GB2291571A (en) * | 1994-07-19 | 1996-01-24 | Ibm | Text to speech system; acoustic processor requests linguistic processor output |
| US5708757A (en) * | 1996-04-22 | 1998-01-13 | France Telecom | Method of determining parameters of a pitch synthesis filter in a speech coder, and speech coder implementing such method |
| US5940791A (en) * | 1997-05-09 | 1999-08-17 | Washington University | Method and apparatus for speech analysis and synthesis using lattice ladder notch filters |
| US6487531B1 (en) * | 1999-07-06 | 2002-11-26 | Carol A. Tosaya | Signal injection coupling into the human vocal tract for robust audible and inaudible voice recognition |
| JP4067762B2 (ja) * | 2000-12-28 | 2008-03-26 | ヤマハ株式会社 | 歌唱合成装置 |
| US20030191645A1 (en) * | 2002-04-05 | 2003-10-09 | Guojun Zhou | Statistical pronunciation model for text to speech |
| US7584104B2 (en) * | 2006-09-08 | 2009-09-01 | At&T Intellectual Property Ii, L.P. | Method and system for training a text-to-speech synthesis system using a domain-specific speech database |
| US8321222B2 (en) * | 2007-08-14 | 2012-11-27 | Nuance Communications, Inc. | Synthesis by generation and concatenation of multi-form segments |
| US8224648B2 (en) * | 2007-12-28 | 2012-07-17 | Nokia Corporation | Hybrid approach in voice conversion |
| CA2724753A1 (en) * | 2008-05-30 | 2009-12-03 | Nokia Corporation | Method, apparatus and computer program product for providing improved speech synthesis |
| US20100057435A1 (en) * | 2008-08-29 | 2010-03-04 | Kent Justin R | System and method for speech-to-speech translation |
| US8332225B2 (en) * | 2009-06-04 | 2012-12-11 | Microsoft Corporation | Techniques to create a custom voice font |
| US8315871B2 (en) * | 2009-06-04 | 2012-11-20 | Microsoft Corporation | Hidden Markov model based text to speech systems employing rope-jumping algorithm |
-
2010
- 2010-05-07 GB GB1007705.5A patent/GB2480108B/en not_active Expired - Fee Related
-
2011
- 2011-04-28 JP JP2011100487A patent/JP2011237795A/ja active Pending
- 2011-05-06 US US13/102,372 patent/US20110276332A1/en not_active Abandoned
Patent Citations (3)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| WO2003042648A1 (en) * | 2001-11-16 | 2003-05-22 | Matsushita Electric Industrial Co., Ltd. | Speech encoder, speech decoder, speech encoding method, and speech decoding method |
| JP2007140002A (ja) * | 2005-11-17 | 2007-06-07 | Oki Electric Ind Co Ltd | 音声合成装置,音声合成方法,およびコンピュータプログラム |
| JP2006119655A (ja) * | 2005-11-21 | 2006-05-11 | Yamaha Corp | 音声合成装置 |
Non-Patent Citations (2)
| Title |
|---|
| CSNG199901127001; 舟木 慶一 Keiichi Funaki: 'Glottal-ARMAX音声分析法におけるマルチレート処理の導入について A multirate glottal-ARMA' 日本音響学会誌 第55巻 第2号 THE JOURNAL OF THE ACOUSTICAL SOCIETY OF JAPAN 第55巻, 19990201, 社団法人日本音響学会 Acoustical Society of Japan * |
| JPN6012033184; 舟木 慶一 Keiichi Funaki: 'Glottal-ARMAX音声分析法におけるマルチレート処理の導入について A multirate glottal-ARMA' 日本音響学会誌 第55巻 第2号 THE JOURNAL OF THE ACOUSTICAL SOCIETY OF JAPAN 第55巻, 19990201, 社団法人日本音響学会 Acoustical Society of Japan * |
Cited By (11)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| JP2014056235A (ja) * | 2012-07-18 | 2014-03-27 | Toshiba Corp | 音声処理システム |
| WO2016080713A1 (ko) * | 2014-11-18 | 2016-05-26 | 박남태 | 음성제어 영상표시 장치 및 영상표시 장치의 음성제어 방법 |
| WO2017046887A1 (ja) * | 2015-09-16 | 2017-03-23 | 株式会社東芝 | 音声合成装置、音声合成方法、音声合成プログラム、音声合成モデル学習装置、音声合成モデル学習方法及び音声合成モデル学習プログラム |
| JPWO2017046887A1 (ja) * | 2015-09-16 | 2018-04-12 | 株式会社東芝 | 音声合成装置、音声合成方法、音声合成プログラム、音声合成モデル学習装置、音声合成モデル学習方法及び音声合成モデル学習プログラム |
| CN107924678A (zh) * | 2015-09-16 | 2018-04-17 | 株式会社东芝 | 语音合成装置、语音合成方法、语音合成程序、语音合成模型学习装置、语音合成模型学习方法以及语音合成模型学习程序 |
| CN113724685A (zh) * | 2015-09-16 | 2021-11-30 | 株式会社东芝 | 语音合成模型学习装置、语音合成模型学习方法及存储介质 |
| CN107924678B (zh) * | 2015-09-16 | 2021-12-17 | 株式会社东芝 | 语音合成装置、语音合成方法及存储介质 |
| CN113724685B (zh) * | 2015-09-16 | 2024-04-02 | 株式会社东芝 | 语音合成模型学习装置、语音合成模型学习方法及存储介质 |
| JP2021010156A (ja) * | 2019-06-28 | 2021-01-28 | ベイジン バイドゥ ネットコム サイエンス アンド テクノロジー カンパニー リミテッド | 情報を生成する方法および装置 |
| US11151765B2 (en) | 2019-06-28 | 2021-10-19 | Beijing Baidu Netcom Science And Technology Co., Ltd. | Method and apparatus for generating information |
| JP7104683B2 (ja) | 2019-06-28 | 2022-07-21 | ベイジン バイドゥ ネットコム サイエンス テクノロジー カンパニー リミテッド | 情報を生成する方法および装置 |
Also Published As
| Publication number | Publication date |
|---|---|
| US20110276332A1 (en) | 2011-11-10 |
| GB201007705D0 (en) | 2010-06-23 |
| GB2480108B (en) | 2012-08-29 |
| GB2480108A (en) | 2011-11-09 |
Similar Documents
| Publication | Publication Date | Title |
|---|---|---|
| JP5242724B2 (ja) | 音声プロセッサ、音声処理方法および音声プロセッサの学習方法 | |
| US20110276332A1 (en) | Speech processing method and apparatus | |
| JP3933750B2 (ja) | 連続密度ヒドンマルコフモデルを用いた音声認識方法及び装置 | |
| JP4545456B2 (ja) | 最適区画の分類神経網の構成方法、最適区画の分類神経網を用いた自動ラベリング方法、並びに装置 | |
| EP1515305B1 (en) | Noise adaption for speech recognition | |
| CN103310784B (zh) | 文本到语音的方法和系统 | |
| JP5418223B2 (ja) | 音声分類装置、音声分類方法、および音声分類用プログラム | |
| EP2846327B1 (en) | Acoustic model training method and system | |
| JP5398909B2 (ja) | テキスト音声合成方法及びシステム | |
| CN113724685B (zh) | 语音合成模型学习装置、语音合成模型学习方法及存储介质 | |
| KR20070077042A (ko) | 음성처리장치 및 방법 | |
| US9466285B2 (en) | Speech processing system | |
| JPH04313034A (ja) | 合成音声生成方法及びテキスト音声合成装置 | |
| GB2546981B (en) | Noise compensation in speaker-adaptive systems | |
| KR20040068023A (ko) | 은닉 궤적 은닉 마르코프 모델을 이용한 음성 인식 방법 | |
| EP4020464A1 (en) | Acoustic model learning device, voice synthesis device, method, and program | |
| EP3038103A1 (en) | Quantitative f0 pattern generation device and method, and model learning device and method for generating f0 pattern | |
| GB2508411A (en) | Speech synthesis by combining probability distributions from different linguistic levels | |
| JP5474713B2 (ja) | 音声合成装置、音声合成方法および音声合成プログラム | |
| Yu et al. | Probablistic modelling of F0 in unvoiced regions in HMM based speech synthesis | |
| JP6142401B2 (ja) | 音声合成モデル学習装置、方法、及びプログラム | |
| Yu et al. | Unsupervised adaptation with discriminative mapping transforms | |
| JP6468519B2 (ja) | 基本周波数パターン予測装置、方法、及びプログラム | |
| JP6167063B2 (ja) | 発話リズム変換行列生成装置、発話リズム変換装置、発話リズム変換行列生成方法、及びそのプログラム | |
| Zhao et al. | Online noise estimation using stochastic-gain HMM for speech enhancement |
Legal Events
| Date | Code | Title | Description |
|---|---|---|---|
| A977 | Report on retrieval |
Free format text: JAPANESE INTERMEDIATE CODE: A971007 Effective date: 20120618 |
|
| A131 | Notification of reasons for refusal |
Free format text: JAPANESE INTERMEDIATE CODE: A131 Effective date: 20120626 |
|
| A02 | Decision of refusal |
Free format text: JAPANESE INTERMEDIATE CODE: A02 Effective date: 20121113 |