EP2680262B1 - Procédé de débruitage d'un signal acoustique pour un dispositif audio multi-microphone opérant dans un milieu bruité - Google Patents
Procédé de débruitage d'un signal acoustique pour un dispositif audio multi-microphone opérant dans un milieu bruité Download PDFInfo
- Publication number
- EP2680262B1 EP2680262B1 EP13171948.6A EP13171948A EP2680262B1 EP 2680262 B1 EP2680262 B1 EP 2680262B1 EP 13171948 A EP13171948 A EP 13171948A EP 2680262 B1 EP2680262 B1 EP 2680262B1
- Authority
- EP
- European Patent Office
- Prior art keywords
- sensors
- signal
- denoising
- speech
- noise
- Prior art date
- Legal status (The legal status is an assumption and is not a legal conclusion. Google has not performed a legal analysis and makes no representation as to the accuracy of the status listed.)
- Active
Links
Images


Classifications
-
- H—ELECTRICITY
- H04—ELECTRIC COMMUNICATION TECHNIQUE
- H04R—LOUDSPEAKERS, MICROPHONES, GRAMOPHONE PICK-UPS OR LIKE ACOUSTIC ELECTROMECHANICAL TRANSDUCERS; ELECTRIC HEARING AIDS; PUBLIC ADDRESS SYSTEMS
- H04R3/00—Circuits for transducers
- H04R3/002—Damping circuit arrangements for transducers, e.g. motional feedback circuits
-
- G—PHYSICS
- G10—MUSICAL INSTRUMENTS; ACOUSTICS
- G10L—SPEECH ANALYSIS TECHNIQUES OR SPEECH SYNTHESIS; SPEECH RECOGNITION; SPEECH OR VOICE PROCESSING TECHNIQUES; SPEECH OR AUDIO CODING OR DECODING
- G10L21/00—Speech or voice signal processing techniques to produce another audible or non-audible signal, e.g. visual or tactile, in order to modify its quality or its intelligibility
- G10L21/02—Speech enhancement, e.g. noise reduction or echo cancellation
- G10L21/0208—Noise filtering
-
- G—PHYSICS
- G10—MUSICAL INSTRUMENTS; ACOUSTICS
- G10L—SPEECH ANALYSIS TECHNIQUES OR SPEECH SYNTHESIS; SPEECH RECOGNITION; SPEECH OR VOICE PROCESSING TECHNIQUES; SPEECH OR AUDIO CODING OR DECODING
- G10L21/00—Speech or voice signal processing techniques to produce another audible or non-audible signal, e.g. visual or tactile, in order to modify its quality or its intelligibility
- G10L21/02—Speech enhancement, e.g. noise reduction or echo cancellation
- G10L21/0208—Noise filtering
- G10L21/0216—Noise filtering characterised by the method used for estimating noise
- G10L2021/02161—Number of inputs available containing the signal or the noise to be suppressed
- G10L2021/02166—Microphone arrays; Beamforming
Definitions
- the invention relates to the treatment of speech in a noisy environment.
- microphones include one or more microphones (“microphones”) sensitive, capturing not only the voice of the user, but also the surrounding noise, noise that is a disruptive element that can go in some cases to make unintelligible the speaker's words . It is the same if one wants to implement speech recognition techniques, because it is very difficult to perform a form recognition on words embedded in a high noise level.
- the significant distance between the microphone (placed at the dashboard or in an angle of the cockpit of the passenger compartment) and the speaker (whose distance is constrained by the driving position) entails capturing a relatively high noise level, which makes it difficult to extract the useful signal embedded in the noise.
- the very noisy environment typical of the automotive environment has spectral characteristics that evolve unpredictably depending on driving conditions: passage on deformed or paved roads, car radio in operation, etc.
- the headset can be used in a noisy environment (subway, busy street, train, etc.), so that the microphone will not only pick up the word of the wearer of the helmet, but also the noise surrounding.
- the wearer is protected from this noise by the headphones, especially if it is a model with closed headphones isolating the ear from the outside, and even more if the headset is provided with an "active noise control"".
- the distant speaker the one at the other end of the communication channel
- the distant speaker will suffer from the noise picked up by the microphone and being superimposed and interfere with the speech signal of the near speaker (the helmet wearer).
- certain speech formers essential to the understanding of the voice are often embedded in noise components commonly encountered in the usual environments.
- the invention more particularly relates to denoising techniques using a network of several microphones, judiciously combining the signals simultaneously picked up by these microphones to discriminate the useful components of speech from the noise noise components.
- a conventional technique consists in placing and orienting one of the microphones so that it mainly captures the voice of the speaker, while the other is arranged to capture a greater noise component than the main microphone.
- the comparison of the signals captured makes it possible to extract the voice of the ambient noise by spatial coherence analysis of the two signals, with relatively simple software means.
- the US 2008/0280653 A1 describes such a configuration, where one of the pickups (the one that mainly picks up the voice) is that of a wireless headset carried by the driver of the vehicle, while the other (the one that captures the noise) is that of the telephone device, placed remotely in the passenger compartment of the vehicle, for example hung on the dashboard.
- this technique has the disadvantage of requiring two remote microphones, the efficiency being even higher than the two microphones are remote. Therefore, this technique is not applicable to a device in which the two microphones are close together, for example two microphones incorporated in the facade of a car radio, or two microphones that would be arranged on one of the shells an earphone.
- beamforming consists of creating by software means a directivity that improves the signal / noise ratio of the network or "antenna" microphones.
- the US 2007/0165879 A1 describes such a technique, applied to a pair of non-directional microphones placed back to back.
- An adaptive filtering of the captured signals makes it possible to derive at the output a signal in which the voice component has been reinforced.
- the EP 2 293 594 A1 and EP 2 309 499 A1 (Parrot ) describe other techniques, also based on the assumption that the wanted signal and / or spurious noises have a certain directivity, which combine the signals from the different microphones so as to improve the signal / noise ratio according to these conditions of directivity.
- These denoising techniques are based on the assumption that speech generally has a higher spatial coherence than noise and that, moreover, the direction of speech incidence is generally well defined and can be assumed to be known (in the case of motor vehicle, it is defined by the position of the driver, to which are turned the microphones).
- This assumption takes into account the reverberation effect typical of the cabin of a car, where powerful reflections and many make it difficult to calculate a direction of arrival. They can also be faulted by noises with a certain directivity, such as blows of horn, passage of a scooter, overtaking by a car, etc.
- the directivity is all the more marked as the frequency is high, so that this criterion becomes less discriminating for the lower frequencies.
- the invention provides a method of denoising a noisy acoustic signal for a multi-microphone audio device of the general type disclosed by the aforementioned article by McCowan and S. Sridharan, wherein the device comprises a sensor array formed of a plurality of microphone sensors arranged in a predetermined configuration and able to collect the noisy signal, the sensors being grouped into two sub-networks, with a first sub-network able to collect a RF portion of the spectrum, and a second sub-network of sensors able to collect a part BF of the spectrum distinct from the part HF.
- the first sub-array of sensors able to collect the RF portion of the spectrum may in particular comprise a linear array of at least two sensors aligned perpendicularly to the direction of the speech source, and the second sub-array of sensors adapted to collect the spectrum portion BF may comprise a linear network of at least two sensors aligned parallel to the direction of the speech source.
- the sensors of the first sub-array of sensors are advantageously unidirectional sensors, oriented in the direction of the speech source.
- the denoising processing of the HF part of the spectrum in step b1) can be differentially performed for a lower band and an upper band of this HF part, with the selection of different sensors among the sensors of the first sub-network, the distance between the sensors selected for denoising the upper band being smaller than the distance of the selected sensors for denoising the lower band.
- the step b13) of estimating the transfer function of the acoustic channels can in particular be implemented by an LMS-type linear least linear adaptive adaptive filter, with modulation by the probability of presence of speech, notably a modulation. by variation of the iteration step of the adaptive filter LMS.
- the prediction of the noise of one sensor on the other can be made in the time domain, in particular by a Wiener filter multichannel filter with weighting by the Speech distortion, SDW-MWF, including an SDW-MWF filter adaptively estimated by a gradient descent algorithm.
- Each microphone thus captures a component of the useful signal (the speech signal) and a component of the surrounding noise, in all its forms (directive or diffuse, stationary or evolving unpredictably, etc.).
- the network R is configured in two subnetworks R 1 and R 2 dedicated respectively to the capture and processing of the signals in the upper part (hereinafter "high frequency”, HF) of the spectrum and in the lower part (hereinafter after “low frequency”, BF) of this same spectrum.
- the microphone M 1 which belongs to the two subnetworks R 1 and R 2 , is shared, which makes it possible to reduce the total number of microphones of the network. This pooling is advantageous, but it is not necessary.
- the shared micro may be for example the micro M 3 , giving the whole network a configuration in the form of "T".
- the microphone M 2 of the BF network may be an omnidirectional microphone, since the directivity is much less marked in BF than in HF.
- the illustrated configuration showing two subnets R 1 + R 2 comprising 3 + 2 microphones (a total of 4 microphones given the pooling of one of the microphones) is not limiting.
- the minimum configuration is a configuration with 2 + 2 microphones (a minimum of 3 microphones if one of them is shared). Conversely, it is possible to increase the number of microphones, with configurations to 4 + 2 pickups, 4 + 3 pickups, etc.
- the increase in the number of microphones makes it possible, particularly in the high frequencies, to select different microphone configurations depending on the parts of the RF spectrum processed.
- FIGS. 2a and 2b illustrate, respectively for an omnidirectional microphone and for a unidirectional microphone, characteristics giving, as a function of frequency, the value of the correlation function between two microphones, for several distance values d between these microphones.
- the correlation function between two microphones distant from a distance d is a globally decreasing function of the distance between the microphones.
- This correlation function is represented by mean squared coherence MSC ( Mean Squared Coherence ) , which varies between 1 (the two signals are perfectly coherent, they differ only from a linear filter) and 0 (totally decorrelated signals).
- MSC Mean Squared Coherence
- unidirectional microphones will be used because, as can be seen by comparing the Figures 2a and 2b the variation of the coherence function is much more abrupt in this case than with an omnidirectional microphone.
- Denoising treatment description of a preferential mode
- a high-pass filter HF 10 receives the signals from the microphones M 1 , M 3 and M 4 of the sub-network R 1 , used jointly. These signals are first subject to a fast FFT Fourier transform (block 12), then to a frequency-domain processing by an algorithm (block 14) exploiting the predictability of the useful signal of a signal.
- microphone on the other, in this example an MMSE-STSA ( Minimum Mean-Squared Error Short-Time Spectral Amplitude ) type estimator, which will be described in detail below.
- a low pass filter BF 16 receives as input the signals picked up by the microphones M 1 and M 2 of the subnetwork R 2 . These signals are the subject of a denoising processing (block 18) operated in the time domain by an algorithm exploiting a prediction of the noise of a microphone on the other during the periods of silence of the speaker.
- a denoising processing (block 18) operated in the time domain by an algorithm exploiting a prediction of the noise of a microphone on the other during the periods of silence of the speaker.
- SDW-MWF Speech Distortion Weighted Multichannel Wiener Filter
- the resulting denoised signal is then subjected to a fast Fourier transform FFT (block 20).
- two resulting single-channel signals are available, one for the HF part originating from block 14, the other for part BF coming from block 18 after passing into the frequency domain by block 20. .
- an additional (single channel) processing of selective denoising (block 24) is performed on the corresponding reconstructed signal.
- the signal resulting from this treatment is finally the subject of a transformation of Fourier fast inverse iFFT (block 26) to return to the time domain.
- LSA Log-Spectral Amplitude
- this particular implementation is of course not limiting, other denoising techniques can be envisaged, since they are based on the predictability of the useful signal of a microphone on the other.
- this HF denoising is not necessarily operated in the frequency domain, it can also be operated in the time domain, by equivalent means.
- the proposed technique consists of searching for an optimal linear "projector" for each frequency, that is to say an operator corresponding to a transformation of a plurality of signals (those collected concurrently by the various microphones of the sub-network R 1 ). in a single single channel signal.
- This projection is an "optimal" linear projection in that it is sought that the residual noise component on the single-channel signal output is minimized and that the useful speech component is the less distorted possible.
- the transfer function H corresponds to a pure delay, it recognizes the formula beamforming MVDR (Minimum Variance Distorsionless Response), also called beamforming Capon. It will be noted that the residual noise power is worth, after projection 1 H T ⁇ R not - 1 ⁇ H .
- MVDR Minimum Variance Distorsionless Response
- the selective noise denoising treatment, applied to the single-channel signal resulting from beamforming processing is advantageously the OM-LSA type treatment described above, operated by block 24 on the complete spectrum after synthesis at 22.
- MVDR estimator (block 28) its implementation involves an estimation of the acoustic transfer functions H i between the speech source and each of the microphones M i (M 1 , M 3 or M 4 ).
- a frequency LMS estimator (block 30) receiving as input the signals from the different microphones and outputting the estimates of the various transfer functions H.
- x i is the sensed signal
- h i is the impulse response between the useful signal source (speaker speech signal) and the microphone M i
- s is the useful signal produced by the source S
- b i is the additive noise
- the MMSE-STSA estimator factorizes into a MVDR beamforming (block 28) followed by a single-channel estimator (the OM / LSA algorithm of block 24).
- MVDR X H T ⁇ ⁇ bb - 1 ⁇ X H T ⁇ ⁇ bb - 1 ⁇ H
- the adaptive MVDR beamforming thus exploits the coherence of the useful signal to estimate a transfer function H corresponding to the acoustic channel between the speaker and each of the microphones of the sub-network.
- LMS algorithms - or NLMS Normalized LMS which is a standardized version of the LMS - are relatively simple and undemanding algorithms in terms of computing resources.
- H can only be identified with a transfer function.
- H can only be identified with a transfer function.
- the LMS algorithm aims (in known manner) to estimate a filter H (block 36) by means of an adaptive algorithm, corresponding to the signal x i delivered by the microphone M 1 , by estimating the transfer of voice between the microphone M i and the microphone M 1 (taken as a reference).
- the output of the filter 36 is subtracted at 38 from the signal x 1 picked up by the microphone M 1 , to give a prediction error signal allowing the iterative adaptation of the filter 36. It is thus possible to predict from the signal x i the speech component contained in the signal x 1 .
- the signal x 1 is slightly delayed (block 40).
- the error signal of the adaptive filter 36 is weighted at 42 by the probability of presence of speech SPP delivered at the output of the block 34, so as to adapt the filter only when the probability of presence of speech is high.
- This weighting can in particular be made by modifying the adaptation step of the algorithm, as a function of the SPP probability .
- This noise prediction present on a microphone is operated from the noise present on all the microphones considered of the second subnetwork R 2 , and this in the periods of silence of the speaker, where only the noise is present.
- the Wiener filter (block 44) provides a noise prediction which is subtracted at 46 from the collected, non-denoised signal after applying a delay (block 48) to avoid causation problems.
- the Wiener filter 44 is parameterized by a coefficient ⁇ (represented at 50) which determines an adjustable weighting between, on the one hand, the distortion introduced by the processing on the speech signal denoised and, on the other hand, the noise level. residual.
- the Wiener filter used is advantageously a weighted Wiener filter (SDW-MVF), to take into account not only the energy of the noise to be eliminated by the filtering, but also the distortion introduced by this filtering, which should be minimized. .
- SDW-MVF weighted Wiener filter
- This filter is implemented adaptively by a gradient descent algorithm such as that set forth in the aforementioned article [6].
- the diagram is the one illustrated Figures 3 and 4 .
- R b ⁇ ⁇ ⁇ R b ⁇ t - 1 + 1 - ⁇ ⁇ x t ⁇ x ⁇ t T if there is no word R b ⁇ t - 1 if not ⁇ being a factor of forgetting.
- this parameter must correspond to a spatial and temporal reality, with a sufficient number of coefficients to predict the noise temporally (temporal coherence of the noise) and spatially (spatial transfer between the microphones).
- the parameter ⁇ is adjusted experimentally, increasing it until the distortion on the voice becomes perceptible to the ear.
- J kr ⁇ ⁇ E ⁇ b k t - w T ⁇ b t 2 + E w T ⁇ s t 2
Landscapes
- Engineering & Computer Science (AREA)
- Physics & Mathematics (AREA)
- Acoustics & Sound (AREA)
- Signal Processing (AREA)
- Computational Linguistics (AREA)
- Quality & Reliability (AREA)
- Health & Medical Sciences (AREA)
- Audiology, Speech & Language Pathology (AREA)
- Human Computer Interaction (AREA)
- Multimedia (AREA)
- Circuit For Audible Band Transducer (AREA)
- Soundproofing, Sound Blocking, And Sound Damping (AREA)
Description
- L'invention concerne le traitement de la parole en milieu bruité.
- Elle concerne notamment le traitement des signaux de parole captés par des dispositifs de téléphonie de type "mains libres" destinés à être utilisés dans un environnement bruité.
- Ces appareils comportent un ou plusieurs microphones ("micros") sensibles, captant non seulement la voix de l'utilisateur, mais également le bruit environnant, bruit qui constitue un élément perturbateur pouvant aller dans certains cas jusqu'à rendre inintelligibles les paroles du locuteur. Il en est de même si l'on veut mettre en oeuvre des techniques de reconnaissance vocale, car il est très difficile d'opérer une reconnaissance de forme sur des mots noyés dans un niveau de bruit élevé.
- Cette difficulté liée aux bruits environnants est particulièrement contraignante dans le cas des dispositifs "mains libres" pour véhicules automobiles qu'il s'agisse d'équipements incorporés au véhicule ou bien d'accessoires en forme de boitier amovible intégrant tous les composants et fonctions de traitement du signal pour la communication téléphonique.
- En effet, dans cette application, la distance importante entre le micro (placé au niveau de la planche de bord ou dans un angle du pavillon de l'habitacle) et le locuteur (dont l'éloignement est contraint par la position de conduite) entraine la captation d'un niveau de bruit relativement élevé, qui rend difficile l'extraction du signal utile noyé dans le bruit. De plus, le milieu très bruité typique de l'environnement automobile présente des caractéristiques spectrales qui évoluent de manière imprévisible en fonction des conditions de conduite : passage sur des chaussées déformées ou pavées, autoradio en fonctionnement, etc.
- Des difficultés comparables se présentent lorsque le dispositif est un casque audio de type micro/casque combiné utilisé pour des fonctions de communication telles que des fonctions de téléphonie "mains libres", en complément de l'écoute d'une source audio (musique par exemple) provenant d'un appareil sur lequel est branché le casque.
- Dans ce cas, il s'agit d'assurer une intelligibilité suffisante du signal capté par le micro, c'est-à-dire du signal de parole du locuteur proche (le porteur du casque). Or le casque peut être utilisé dans un environnement bruyant (métro, rue passante, train, etc.), de sorte que le micro captera non seulement la parole du porteur du casque, mais également les bruits parasites environnants. Le porteur est protégé de ce bruit par le casque, notamment s'il s'agit d'un modèle à écouteurs fermés isolant l'oreille de l'extérieur, et encore plus si le casque est pourvu d'un "contrôle actif de bruit". En revanche, le locuteur distant (celui se trouvant à l'autre bout du canal de communication) souffrira des bruits parasites captés par le micro et venant se superposer et interférer avec le signal de parole du locuteur proche (le porteur du casque). En particulier, certains formants de la parole essentiels à la compréhension de la voix sont souvent noyés dans des composantes de bruit couramment rencontrées dans les environnements habituels.
- L'invention concerne plus particulièrement les techniques de débruitage mettant en oeuvre un réseau de plusieurs micros, en combinant de façon judicieuse les signaux captés simultanément par ces micros pour discriminer les composantes utiles de parole d'avec les composantes parasites de bruit.
- Une technique classique consiste à placer et orienter l'un des micros pour qu'il capte principalement la voix du locuteur, tandis que l'autre est disposé de manière à capter une composante de bruit plus importante que le micro principal. La comparaison des signaux captés permet d'extraire la voix du bruit ambiant par analyse de cohérence spatiale des deux signaux, avec des moyens logiciels relativement simples.
- Le
US 2008/0280653 A1 décrit une telle configuration, où l'un des micros (celui qui capte principalement la voix) est celui d'une oreillette sans fil portée par le conducteur du véhicule, tandis que l'autre (celui qui capte principalement le bruit) est celui de l'appareil téléphonique, placé à distance dans l'habitacle du véhicule, par exemple accroché au tableau de bord. - Cette technique présente cependant l'inconvénient de nécessiter deux micros distants, l'efficacité étant d'autant plus élevée que les deux micros sont éloignés. De ce fait, cette technique n'est pas applicable à un dispositif dans lequel les deux micros sont rapprochés, par exemple deux micros incorporés à la façade d'un autoradio de véhicule automobile, ou deux micros qui seraient disposés sur l'une des coques d'un écouteur de casque audio.
- Une autre technique encore, dite beamforming, consiste à créer par des moyens logiciels une directivité qui améliore le rapport signal/bruit du réseau ou "antenne" de micros. Le
US 2007/0165879 A1 décrit une telle technique, appliquée à une paire de micros non directionnels placés dos à dos. Un filtrage adaptatif des signaux captés permet de dériver en sortie un signal dans lequel la composante de voix a été renforcée. - Toutefois, on estime qu'une méthode de débruitage multi-capteurs ne fournit de bons résultats qu'à condition de disposer d'un réseau d'au moins huit micros, les performances étant extrêmement limitées lorsque seulement deux micros sont utilisés.
- Les
EP 2 293 594 A1 etEP 2 309 499 A1 (Parrot ) décrivent d'autres techniques, également basées sur l'hypothèse que le signal utile et/ou les bruits parasites présentent une certaine directivité, qui combinent les signaux issus des différents micros de manière à améliorer le rapport signal/bruit en fonction de ces conditions de directivité. Ces techniques de débruitage reposent sur l'hypothèse que la parole présente généralement une cohérence spatiale supérieure au bruit et que, par ailleurs, la direction d'incidence de la parole est généralement bien définie et peut être supposée connue (dans le cas d'un véhicule automobile, elle est définie par la position du conducteur, vers lequel sont tournés les micros). Cette hypothèse prend cependant mal en compte l'effet de réverbération typique de l'habitacle d'une voiture, où les réflexions puissantes et nombreuses rendent difficile le calcul d'une direction d'arrivée. Elles peuvent être également mises en défaut par des bruits présentant une certaine directivité, tels que coups de klaxon, passage d'un scooter, dépassement par une voiture, etc. - Un autre procédé encore est décrit dans l'article de I. McCowan et S. Sridharan, "Adaptive Parameter Compensation for Robust Hands-free Speech Recognition using a Dual-Beamforming Microphone Array", Proceedings on 2001 International Symposium on Intelligent Multimedia, Video and Speech Processing, May 2001.
- De façon générale, ces techniques basées sur des hypothèses de directivité présentent toutes des performances limitées à l'encontre des composantes de bruit situées dans la région des fréquences les plus basses - là où, précisément, le bruit peut se trouver concentré à un niveau d'énergie relativement élevé.
- En effet, la directivité est d'autant plus marquée que la fréquence est élevée, de sorte que ce critère devient peu discriminant pour les fréquences les plus basses. En fait, pour rester suffisamment efficace, il est nécessaire d'écarter beaucoup les micros, par exemple de 15 à 20 cm, voire même plus en fonction des performances souhaitées, de manière à décorréler suffisamment les bruits captés par ces micros.
- Par voie de conséquence, il n'est pas possible d'incorporer un tel réseau de micros par exemple au boitier d'un autoradio de véhicule automobile ou à un boitier de "kit mains libres" autonome placé dans le véhicule, encore moins sur des coques d'écouteurs d'un casque audio.
- Le problème de l'invention est, dans un tel contexte, de pouvoir disposer d'une technique de réduction de bruit efficace permettant de délivrer au locuteur distant un signal vocal représentatif de la parole émise par le locuteur proche (conducteur du véhicule ou porteur du casque), en débarrassant ce signal des composantes parasites de bruit extérieur présentes dans l'environnement de ce locuteur proche, technique qui :
- présente des performances accrues dans le bas du spectre des fréquences, là où sont le plus souvent concentrées les composantes de bruit parasite les plus gênantes, notamment du point de vue du masquage du signal de parole ;
- ne requière pour sa mise en oeuvre qu'un nombre réduit de micros (typiquement, pas plus de trois à cinq micros) ; et
- avec une configuration géométrique suffisamment ramassée du réseau de micros (typiquement avec un écartement entre micros de quelques centimètres seulement), pour permettre notamment son intégration à des produits compacts de type "tout-en-un".
- Le point de départ de l'invention réside dans l'analyse du champ de bruit typique dans l'habitacle d'un véhicule automobile, qui conduit aux observations suivantes :
- le bruit dans l'habitacle est spatialement cohérent dans les basses fréquences (au-dessous de 1000 Hz environ) ;
- il perd en cohérence dans les hautes fréquences (au-dessus de 1000 Hz) ; et
- selon le type de micro utilisé, unidirectionnel ou omnidirectionnel, la cohérence spatiale est modifiée.
- Ces observations, qui seront précisées et justifiées plus loin, conduisent à proposer une stratégie de débruitage hybride, mettant en oeuvre en basse fréquence (BF) et en haute fréquence (HF) deux algorithmes différents, exploitant la cohérence ou la non-cohérence des composantes de bruit selon la partie du spectre considérée :
- la forte cohérence des bruits en BF permet d'envisager un algorithme exploitant une prédiction du bruit d'un micro sur l'autre, ce qui est possible car on peut observer des périodes de silence du locuteur, avec absence de signal utile et présence exclusive du bruit ;
- en revanche, en HF le bruit est faiblement cohérent et il est difficilement prédictible, sauf à prévoir un nombre élevé de micros (ce qui n'est pas souhaité) ou à rapprocher les micros pour rendre les bruits plus cohérents (mais l'on n'obtiendra jamais de grande cohérence dans cette bande, sauf à confondre les micros : les signaux captés seraient alors les mêmes, et l'on n'aurait aucune information spatiale). Pour cette partie HF, on utilisera alors un algorithme exploitant le caractère prédictible du signal utile d'un micro sur l'autre (et non plus une prédiction du bruit), ce qui est par hypothèse possible car on sait que ce signal utile est produit par une source ponctuelle (la bouche du locuteur).
- Plus précisément, l'invention propose un procédé de débruitage d'un signal acoustique bruité pour un dispositif audio multi-microphone du type général divulgué par l'article précité de McCowan and S. Sridharan, où le dispositif comprend un réseau de capteurs formé d'une pluralité de capteurs microphoniques disposés selon une configuration prédéterminée et aptes à recueillir le signal bruité, les capteurs étant regroupés en deux sous-réseaux, avec un premier sous-réseau apte à recueillir une partie HF du spectre, et un second sous-réseau de capteurs apte à recueillir une partie BF du spectre distincte de la partie HF.
- Ce procédé comporte des étapes de :
- a) partition du spectre du signal bruité entre ladite partie HF et ladite partie BF, par filtrage respectivement au-delà et en deçà d'une fréquence pivot prédéterminée,
- b) débruitage de chacune des deux parties du spectre avec mise en oeuvre d'un estimateur à algorithme adaptatif ; et
- c) reconstruction du spectre par combinaison des signaux délivrés après débruitage des deux parties du spectre aux étapes b1) et b2),
- De façon caractéristique de l'invention, l'étape b) de débruitage est opérée par des traitements distincts pour chacune des deux parties du spectre, avec :
- b1) pour la partie HF, un débruitage exploitant le caractère prédictible du signal utile d'un capteur sur l'autre entre capteurs du premier sous-réseau, au moyen d'un premier estimateur (14) à algorithme adaptatif, et
- b2) pour la partie BF, un débruitage par prédiction du bruit d'un capteur sur l'autre entre capteurs du second sous-réseau, au moyen d'un second estimateur (18) à algorithme adaptatif.
- En ce qui concerne la géométrie du réseau de capteurs, le premier sous-réseau de capteurs apte à recueillir la partie HF du spectre peut notamment comprendre un réseau linaire d'au moins deux capteurs alignés perpendiculairement à la direction de la source de parole, et le second sous-réseau de capteurs apte à recueillir la partie BF du spectre peut comprendre un réseau linaire d'au moins deux capteurs alignés parallèlement à la direction de la source de parole.
- Les capteurs du premier sous-réseau de capteurs sont avantageusement des capteurs unidirectionnels, orientés dans la direction de la source de parole.
- Le traitement de débruitage de la partie HF du spectre à l'étape b1) peut être opéré de façon différenciée pour une bande inférieure et une bande supérieure de cette partie HF, avec sélection de capteurs différents parmi les capteurs du premier sous-réseau, la distance entre les capteurs sélectionnés pour le débruitage de la bande supérieure étant plus réduite que la distance des capteurs sélectionnés pour le débruitage de la bande inférieure.
- Le traitement de débruitage prévoit de préférence, après l'étape c) de reconstruction du spectre, une étape de :
- d) réduction sélective du bruit par un traitement de type gain à amplitude log-spectrale modifié optimisé, OM-LSA, à partir du signal reconstruit produit à l'étape c) et d'une probabilité de présence de parole.
- En ce qui concerne le débruitage de la partie HF du spectre, l'étape b1), exploitant le caractère prédictible du signal utile d'un capteur sur l'autre, peut être opérée dans le domaine fréquentiel, en particulier par :
- b11) estimation d'une probabilité de présence de parole dans le signal bruité recueilli ;
- b12) estimation d'une matrice spectrale de covariance des bruits recueillis par les capteurs du premier sous-réseau, cette estimation étant modulée par la probabilité de présence de parole ;
- b13) estimation de la fonction de transfert des canaux acoustiques entre la source de parole et au moins certains des capteurs du premier sous-réseau, cette estimation étant opérée par rapport à une référence de signal utile constituée par le signal recueilli par l'un des capteurs du premier sous-réseau, et étant en outre modulée par la probabilité de présence de parole ; et
- b14) calcul, notamment par un estimateur de type beamforming à réponse sans distorsion à variance minimale, MVDR, d'un projecteur linéaire optimal donnant un signal combiné débruité unique à partir des signaux recueillis par au moins certains des capteurs du premier sous-réseau, de la matrice spectrale de covariance estimée à l'étape b12), et des fonctions de transfert estimées à l'étape b13).
- L'étape b13) d'estimation de la fonction de transfert des canaux acoustiques peut notamment être mise en oeuvre par un filtre adaptatif à prédiction linéaire de type moindres carrés moyens, LMS, avec modulation par la probabilité de présence de parole, notamment une modulation par variation du pas d'itération du filtre adaptatif LMS.
- Pour le débruitage de la partie BF à l'étape b2), la prédiction du bruit d'un capteur sur l'autre peut être opérée dans le domaine f temporel, en particulier par un filtre de type filtre de Wiener multicanal avec pondération par la distorsion de la parole, SDW-MWF, notamment un filtre SDW-MWF estimé de manière adaptative par un algorithme de descente de gradient.
- On va maintenant décrire un exemple de mise en oeuvre du dispositif de l'invention, en référence aux dessins annexés où les mêmes références numériques désignent d'une figure à l'autre des éléments identiques ou fonctionnellement semblables.
- La
Figure 1 illustre de façon schématique un exemple de réseau de micros, comprenant quatre micros utilisables de façon sélective pour la mise en oeuvre de l'invention. - Les
Figures 2a et 2b sont des caractéristiques, respectivement pour un micro omnidirectionnel et pour un micro unidirectionnel, montrant les variations, en fonction de la fréquence, de la corrélation (fonction de cohérence quadratique) entre deux micros pour un champ de bruit diffus, ceci pour plusieurs valeurs d'écartement entre ces deux micros. - La
Figure 3 est un schéma d'ensemble, sous forme de blocs fonctionnels, montrant les différents traitements selon l'invention pour le débruitage des signaux recueillis par le réseau de micros de laFigure 1 . - La
Figure 4 est une représentation schématique par blocs fonctionnels, généralisée à un nombre de micros supérieur à deux, d'un filtre adaptatif pour l'estimation de la fonction de transfert d'un canal acoustique, utilisable pour le traitement de débruitage de la partie BF du spectre dans le traitement d'ensemble de laFigure 3 . - On va maintenant décrire en détail un exemple de technique de débruitage mettant en oeuvre les enseignements de l'invention.
- On considèrera, comme illustré
Figure 1 , un réseau R de capteurs microphoniques M1 ... M4, chaque capteur pouvant être assimilé à un micro unique captant une version bruitée d'un signal de parole émis par une source de signal utile (locuteur) de direction d'incidence Δ. - Chaque micro capte donc une composante du signal utile (le signal de parole) et une composante du bruit parasite environnant, sous toutes ses formes (directif ou diffus, stationnaire ou évoluant de manière imprévisible, etc.).
- Le réseau R est configuré en deux sous-réseaux R1 et R2 dédiés respectivement à la captation et au traitement des signaux dans la partie supérieure (ci-après "haute fréquence", HF) du spectre et dans la partie inférieure (ci-après "basse fréquence", BF) de ce même spectre.
- Le sous-réseau R1 dédié à la partie HF du spectre est constitué des trois micros M1, M3, M4 qui sont alignés perpendiculairement à la direction d'incidence Δ, avec un écartement respectif de d = 2 cm dans l'exemple illustré. Ces micros sont de préférence des micros unidirectionnels dont le lobe principal est orienté dans la direction Δ du locuteur.
- Le sous-réseau R2 dédié à la partie BF du spectre est constitué des deux micros M1 et M2, alignés parallèlement à la direction Δ et écartés de d = 3 cm dans l'exemple illustré. On notera que le micro M1, qui appartient aux deux sous-réseaux R1 et R2, est mutualisé, ce qui permet de réduire le nombre total de micros du réseau. Cette mutualisation est avantageuse mais elle n'est toutefois pas nécessaire. D'autre part, on a illustré une configuration en forme de "L" où le micro mutualisé est le micro M1, mais cette configuration n'est pas restrictive, le micro mutualisé pouvant être par exemple le micro M3, donnant à l'ensemble du réseau une configuration en forme de "T".
- Par ailleurs, le micro M2 du réseau BF peut être un micro omnidirectionnel, dans la mesure où la directivité est beaucoup moins marquée en BF qu'en HF.
- Enfin, la configuration illustrée montrant deux sous-réseaux R1 + R2 comprenant 3 + 2 micros (soit un total de 4 micros compte tenu de la mutualisation de l'un des micros) n'est pas limitative. La configuration minimale est une configuration à 2 + 2 micros (soit un minimum de 3 micros si l'un d'entre eux est mutualisé). Inversement, il est possible d'augmenter le nombre de micros, avec des configurations à 4 + 2 micros, 4 + 3 micros, etc.
- L'augmentation du nombre de micros permet, notamment dans les hautes fréquences, de sélectionner des configurations de micros différentes selon les parties du spectre HF traitées.
- Ainsi, dans l'exemple illustré, si l'on opère en téléphonie wideband avec une plage de fréquences allant jusqu'à 8000 Hz (au lieu de 4000 Hz), pour la bande inférieure (1000 à 4000 Hz) de la partie HF du spectre on choisira les deux micros extrêmes {M1, M4} éloignés entre eux de d = 4 cm, tandis que pour la bande supérieure (4000 à 8000 Hz) de cette même partie HF on utilisera un couple de deux micros voisins {M1, M3} ou {M3, M4}, ou bien les trois micros {M1, M3, M4} ensemble, ces micros étant espacés chacun de d = 2 cm seulement: on bénéficie ainsi dans la bande inférieure du spectre HF de l'écartement maximum des micros, ce qui maximise la décorrélation des bruits captés, tout en évitant dans la bande supérieure un repliement des hautes fréquences du signal à restituer ; un tel repliement apparaitrait sinon du fait d'une fréquence d'échantillonnage spatiale trop faible, dans la mesure où il faut que le retard de phase maximal d'un signal capté par un micro puis par l'autre soit inférieur à la période d'échantillonnage du convertisseur de numérisation des signaux. On va maintenant exposer, en référence aux
Figures 2a et 2b , la manière de choisir la fréquence pivot entre les deux parties BF et HF du spectre, et le choix préférentiel du type de micro unidirectionnel/omnidirectionnel selon la partie du spectre à traiter, HF ou BF. - Ces
Figures 2a et 2b illustrent, respectivement pour un micro omnidirectionnel et pour un micro unidirectionnel, des caractéristiques donnant, en fonction de la fréquence, la valeur de la fonction de corrélation entre deux micros, pour plusieurs valeurs d d'écartement entre ces micros. - La fonction de corrélation entre deux micros éloignés d'une distance d, pour un modèle champ de bruit diffus, est une fonction globalement décroissante de la distance entre les micros. Cette fonction de corrélation est représentée par la cohérence quadratique moyenne MSC (Mean Squared Coherence), qui varie entre 1 (les deux signaux sont parfaitement cohérents, ils ne diffèrent que d'un filtre linéaire) et 0 (signaux totalement décorrélés). Dans le cas d'un micro omnidirectionnel, cette cohérence peut être modélisée en fonction de la fréquence par la fonction :

- Cette courbe modélisée a été illustrée sur la
Figure 2a , lesfigures 2a et 2b montant également la fonction de cohérence MSC réellement mesurée pour les deux types de micros et pour diverses valeurs de distances d. - Si l'on considère que l'on est en présence de signaux effectivement cohérents lorsque la valeur de MSC > 0,9, le bruit pourra être considéré comme étant cohérent lorsque l'on se trouve au-dessous d'une fréquence f0 telle que :
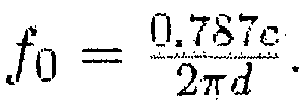
- Ceci donne une fréquence pivot f0 d'environ 1000 Hz pour des micros écartés de d = 4 cm (distance entre les micros M1 et M4 de l'exemple de réseau de la
Figure 1 ). - Dans le présent exemple, correspondant notamment au réseau de micros ayant les dimensions indiquées plus haut, on choisira ainsi une fréquence pivot f0 = 1000 Hz au-dessous de laquelle (partie BF) on considèrera que le bruit est cohérent, ce qui permet d'envisager un algorithme basé sur une prédiction de ce bruit d'un micro sur l'autre (prédiction opérée pendant les périodes de silence du locuteur, où seul le bruit est présent).
- De préférence, on utilisera pour cette partie BF, des micros unidirectionnels, car comme on peut le voir en comparant les
Figures 2a et 2b la variation de la fonction de cohérence est beaucoup plus abrupte dans ce cas qu'avec un micro omnidirectionnel. - Dans la partie HF du spectre, où le bruit est faiblement cohérent, il n'est plus possible de prédire ce bruit de façon satisfaisante ; on mettra alors en oeuvre un autre algorithme, exploitant le caractère prédictible du signal utile (et non plus du bruit) d'un micro sur l'autre.
- On notera enfin que le choix de la fréquence pivot (f0 = 1000 Hz pour d = 2 cm) dépend aussi de l'écartement entre micros, un écartement plus grand correspondant à une fréquence pivot plus faible, et vice versa.
- On va maintenant décrire, en référence à la
Figure 3 , un mode de mise en oeuvre préférentiel de débruitage des signaux recueillis par le réseau de micros de laFigure 1 , de façon bien entendu non limitative. - Comme expliqué plus haut, des traitements différents sont opérés pour le haut du spectre (hautes fréquences, HF) et pour le bas du spectre (basses fréquences, BF).
- Pour le haut du spectre, un filtre passe-haut HF 10 reçoit les signaux des micros M1, M3 et M4 du sous-réseau R1, utilisés conjointement. Ces signaux font d'abord l'objet d'une transformée rapide de Fourier FFT (bloc 12), puis d'un traitement, dans le domaine fréquentiel, par un algorithme (bloc 14) exploitant le caractère prédictible du signal utile d'un micro sur l'autre, dans cet exemple un estimateur de type MMSE-STSA (Minimum Mean-Squared Error Short-Time Spectral Amplitude), qui sera décrit en détail plus bas.
- Pour le bas du spectre, un filtre passe-bas BF 16 reçoit en entrée les signaux captés par les micros M1 et M2 du sous-réseau R2. Ces signaux font l'objet d'un traitement de débruitage (bloc 18) opéré dans le domaine temporel par un algorithme exploitant une prédiction du bruit d'un micro sur l'autre pendant les périodes de silence du locuteur. Dans cet exemple, on utilise un algorithme de type SDW-MWF (Speech Distorsion Weighted Multichannel Wiener Filter), qui sera décrit plus en détail par la suite. Le signal débruité résultant fait ensuite l'objet d'une transformée rapide de Fourier FFT (bloc 20).
- On dispose ainsi, à partir de deux traitements multicanal, de deux signaux monocanal résultants, l'un pour la partie HF issue du bloc 14, l'autre pour la partie BF issue du bloc 18 après passage dans le domaine fréquentiel par le bloc 20.
- Ces deux signaux résultants débruités sont combinés (bloc 22) de manière à opérer une reconstruction du spectre complet, HF + BF.
- Très avantageusement, un traitement (monocanal) supplémentaire de débruitage sélectif (bloc 24) est opéré sur le signal reconstruit correspondant. Le signal issu de ce traitement fait enfin l'objet d'une transformée de Fourier rapide inverse iFFT (bloc 26) pour repasser dans le domaine temporel.
- Plus précisément, ce traitement de débruitage sélectif final consiste à appliquer un gain variable propre à chaque bande de fréquence, ce débruitage étant également modulé par une probabilité de présence de parole. On peut avantageusement utiliser pour le débruitage du bloc 24 une méthode de type OM/LSA (Optimally Modified - Log Spectral Amplitude) telle que celle décrite par :
- [1] I. Cohen, "Optimal Speech Enhancement under Signal Presence Uncertainty Using Log-Spectral Amplitude Estimator", Signal Processing Letters, IEEE, Vol. 9, No 4, pp. 113-116, Apr. 2002.
- Essentiellement, l'application d'un gain nommé "gain LSA" (Log-Spectral Amplitude) permet de minimiser la distance quadratique moyenne entre le logarithme de l'amplitude du signal estimé et le logarithme de l'amplitude du signal de parole originel. Ce second critère se montre supérieur au premier car la distance choisie est en meilleure adéquation avec le comportement de l'oreille humaine et donne donc qualitativement de meilleurs résultats.
- Dans tous les cas, il s'agit de diminuer l'énergie des composantes fréquentielles très parasitées en leur appliquant un gain faible, tout en laissant intactes (par l'application d'un gain égal à 1) celles qui le sont peu ou pas du tout.
- L'algorithme "OM-LSA" (Optimally-Modified LSA) améliore le calcul du gain LSA à appliquer en le pondérant par une probabilité conditionnelle de présence de parole SPP (Speech Presence Probability), qui intervient à deux niveaux :
- pour l'estimation de l'énergie du bruit : la probabilité module le facteur d'oubli dans le sens d'une mise à jour plus rapide de l'estimation du bruit sur le signal bruité lorsque la probabilité de présence de parole est faible ;
- pour le calcul du gain final : la réduction de bruit appliquée est d'autant plus importante (c'est-à-dire que le gain appliqué est d'autant plus faible) que la probabilité de présence de parole est faible.
- La probabilité de présence de parole SPP est un paramètre pouvant prendre plusieurs valeurs différentes comprises entre 0 et 100 %. Ce paramètre est calculé selon une technique en elle-même connue, dont des exemples sont notamment exposés dans :
- [2] I. Cohen et B. Berdugo, "Two-Channel Signal Detection and Speech Enhancement Based on the Transient Beam-to-Reference Ratio", IEEE International Conference on Acoustics, Speech and Signal Processing ICASSP 2003, Hong-Kong, pp. 233-236, Apr. 2003.
- On pourra également se référer au
WO 2007/099222 A1 (Parrot ), qui décrit une technique de débruitage mettant en oeuvre un calcul de probabilité de présence de parole. - On va décrire un exemple de traitement de débruitage appliqué à la partie HF du spectre, par un estimateur MMSE-STSA opérant dans le domaine fréquentiel.
- Cette mise en oeuvre particulière n'est bien entendu pas limitative, d'autres techniques de débruitage pouvant être envisagées, dès lors qu'elles sont basées sur le caractère prédictible du signal utile d'un micro sur l'autre. En outre, ce débruitage HF n'est pas nécessairement opéré dans le domaine fréquentiel, il peut également être opéré dans le domaine temporel, par des moyens équivalents.
- La technique proposée consiste à rechercher un "projecteur" linéaire optimal pour chaque fréquence, c'est-à-dire un opérateur correspondant à une transformation d'une pluralité de signaux (ceux recueillis concurremment par les divers micros du sous-réseau R1) en un signal unique monocanal.
- Cette projection, estimée par le bloc 28, est une projection linéaire "optimale" en ce sens que l'on cherche à ce que la composante de bruit résiduel sur le signal monocanal délivré en sortie soit minimisée et que la composante utile de parole soit la moins déformée possible.
- Cette optimisation implique de rechercher pour chaque fréquence un vecteur A tel que :
- la projection ATX contienne le moins de bruit possible, c'est-à-dire que la puissance du bruit résiduel, qui vaut E[ ATVVTA ]= ATRnA, soit minimisée, et
- la voix du locuteur ne soit pas déformée, ce qui se traduit par la contrainte ATH =1 , où Rn est la matrice de corrélation entre les micros, pour chaque fréquence, et H est le canal acoustique considéré.
- Ce problème est un problème d'optimisation sous contrainte, à savoir la recherche de min( ATRnA) sous la contrainte ATH =1.
- Il peut être résolu en utilisant la méthode des multiplieurs de Lagrange, qui conduit à la solution :

- Dans le cas où les fonctions de transfert H correspondent à un retard pur, on reconnait la formule du beamforming MVDR (Minimum Variance Distorsionless Response), aussi appelé beamforming de Capon. On notera que la puissance de bruit résiduel vaut, après projection

- De plus, si l'on considère des estimateurs de type MMSE (Minimum Mean-Squared Error) sur l'amplitude et la phase du signal à chaque fréquence, on constate que ces estimateurs s'écrivent comme un beamforming de Capon suivi d'un traitement monocanal de débruitage sélectif, comme cela a été exposé par :
- [3] R. C. Hendriks et al., On optimal multichannel mean-squared error estimators for speech enhancement, IEEE Signal Processing Letters, vol. 16, no. 10, 2009.
- Le traitement de débruitage sélectif du bruit, appliqué au signal monocanal résultant du traitement de beamforming, est avantageusement le traitement de type OM-LSA décrit plus haut, opéré par le bloc 24 sur le spectre complet après synthèse en 22.
- La matrice interspectrale des bruits est estimée récursivement (bloc 32), en utilisant la probabilité de présence de parole SPP (bloc 34, voir plus haut) :


α 0 étant un facteur d'oubli. - En ce qui concerne l'estimateur MVDR (bloc 28), sa mise en oeuvre implique une estimation des fonctions de transfert acoustiques Hi entre la source de parole et chacun des micros Mi (M1, M3 ou M4).
- Ces fonctions de transfert sont avantageusement évaluées par un estimateur de type LMS fréquentiel (bloc 30) recevant en entrée les signaux issus des différents micros et délivrant en sortie les estimées des diverses fonctions de transfert H .
- Il est également nécessaire d'estimer (bloc 32) la matrice de corrélation Rn (matrice spectrale de covariance, également dénommée matrice interspectrale des bruits). Enfin, ces diverses estimations impliquent la connaissance d'une probabilité de présence de parole SPP, obtenue à partir du signal recueilli par l'un des micros (bloc 34).
- On va maintenant décrire en détail la manière dont opère l'estimateur MMSE-STSA.
- Il s'agit de traiter les signaux multiples produits par les micros pour fournir un signal débruité unique qui soit le plus proche possible du signal de parole émis par le locuteur, c'est-à-dire :
- contenant le moins de bruit possible, et
- déformant le moins possible la voix du locuteur restituée en sortie.
- Sur le micro de rang i, le signal recueilli est :

où xi est le signal capté, hi est la réponse impulsionnelle entre la source de signal utile (signal de parole du locuteur) et le micro Mi, s est le signal utile produit par la source S et bi est le bruit additif. - Pour l'ensemble des micros, on peut utiliser la notation vectorielle :

- Dans le domaine fréquentiel, cette expression devient (les majuscules représentant les transformées de Fourier correspondantes) :

- On fera les hypothèses suivantes, pour toutes les fréquences ω:
- le signal S(ω) est gaussien de moyenne nulle et de puissance spectrale

- les bruits Bi (ω) sont gaussiens de moyenne nulle et ont une matrice interspectrale (E[BB T ]) notée ∑ bb (ω) ;
- le signal et les bruits considérés sont décorrélés, et chacun est décorrélé lorsque les fréquences sont différentes.
- Comme cela a été indiqué plus haut, dans le cas multi-microphone l'estimateur MMSE-STSA se factorise en un beamforming MVDR (bloc 28) suivi d'un estimateur monocanal (l'algorithme OM/LSA du bloc 24).
- Le beamforming MVDR s'écrit :
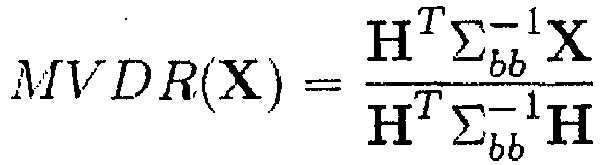
- Le beamforming MVDR adaptatif exploite ainsi la cohérence du signal utile pour estimer une fonction de transfert H correspondant au canal acoustique entre le locuteur et chacun des micros du sous-réseau.
- Pour l'estimation de ce canal acoustique, on utilise un algorithme de type bloc-LMS dans le domaine fréquentiel (bloc 30) tel que celui décrit notamment par :
- [4] J. Prado and E. Moulines, Frequency-Domain Adaptive Filtering with Applications to Acoustic Echo Cancellation, Springer, Ed. Annals of Telecommunications, 1994.
- Les algorithmes de type LMS - ou NLMS (Normalized LMS) qui est une version normalisée du LMS - sont des algorithmes relativement simples et peu exigeants en termes de ressources de calcul.
- Pour un beamforming de type GSC (Generalized Sidelobe Canceller), cette approche est similaire à celle proposée par :
- [5] M.-S. Choi, C.-H. Baik, Y.-C. Park, and H.-G. Kang, "A Soft-Decision Adaptation Mode Controller for an Efficient Frequency-Domain Generalized Sidelobe Canceller," IEEE International Conference on Acoustics, Speech and Signal Processing ICASSP 2007, Vol. 4, April 2007, pp. IV-893-IV-896.
- Le signal utile s(t) étant inconnu, on ne peut identifier H qu'à une fonction de transfert près. On choisit donc l'un des canaux comme référence de signal utile, par exemple le canal du micro M1, et l'on calcule les fonctions de transfert H 2 ... Hn pour les autres canaux (ce qui revient à contraindre H1 = 1). Si le micro de référence choisi n'apporte pas de dégradation majeure sur le signal utile, ce choix n'a pas d'influence notable sur les performances de l'algorithme.
- Comme illustré sur la figure, l'algorithme LMS vise (de façon connue) à estimer un filtre H (bloc 36) au moyen d'un algorithme adaptatif, correspondant au signal xi délivré par le micro M1, en estimant le transfert de voix entre le micro Mi et le micro M1 (pris comme référence). La sortie du filtre 36 est soustraite en 38 au signal x 1 capté par le micro M1, pour donner un signal d'erreur de prédiction permettant l'adaptation itérative du filtre 36. Il est ainsi possible de prédire à partir du signal xi la composante de parole contenue dans le signal x 1.
- Pour éviter les problèmes liés à la causalité (c'est-à-dire pour être sûr que les signaux xi arrivent en avance par rapport à la référence x 1), on retarde légèrement (bloc 40) le signal x 1.
- Par ailleurs, on pondère en 42 le signal d'erreur du filtre adaptatif 36 par la probabilité de présence de parole SPP délivrée en sortie du bloc 34, de manière à ne procéder à l'adaptation du filtre que quand la probabilité de présence de parole est élevée.
- Cette pondération peut notamment être opérée par modification du pas d'adaptation de l'algorithme, en fonction de la probabilité SPP.
- L'équation de mise à jour du filtre adaptatif est, pour le bin de fréquence k et pour le micro i :

avec
t étant l'indice temporel de la trame courante, µ 0 étant une constante choisie expérimentalement, et SPP étant la probabilité de présence de parole a posteriori, estimée comme indiqué plus haut (bloc 34). - Le pas µ d'adaptation de l'algorithme, modulé par la probabilité de présence de parole SPP, s'écrit sous forme normalisée du LMS (le dénominateur correspondant à la puissance spectrale du signal x 1 à la fréquence considérée) :

- L'hypothèse que les bruits sont décorrélés conduit à une prédiction de la voix, et non du bruit, par l'algorithme LMS, de sorte que la fonction de transfert estimé correspond effectivement au canal acoustique H entre le locuteur et les micros.
- On va décrire un exemple d'algorithme de débruitage du type SDW-MWF, opéré dans le domaine temporel, mais ce choix n'est pas limitatif, d'autres techniques de débruitage pouvant être envisagées, dès lors qu'elles sont basées sur la prédiction du bruit d'un micro sur l'autre. En outre, ce débruitage BF n'est pas nécessairement opéré dans le domaine temporel, il peut également être opéré dans le domaine fréquentiel, par des moyens équivalents.
- La technique employée par l'invention est basée sur une prédiction du bruit d'un micro sur l'autre décrite, pour une aide auditive, par :
- [6] A. Spriet, M. Moonen, and J. Wouters, "Stochastic Gradient-Based Implementation of Spatially Preprocessed Speech Distortion Weighted Multichannel Wiener Filtering for Noise Reduction in Hearing Aids," IEEE Transactions on Signal Processing, Vol. 53, pp. 911-925, Mar. 2005.
- Chaque micro capte une composante de signal utile et une composante de bruit. Pour le micro de rang i, on a : xi (t) = si (t) + bi (t) si étant la composante du signal utile et bi la composante de bruit. Si l'on souhaite estimer une version du signal utile présente sur un micro k par un estimateur des moindres carrés linéaires, ceci revient à estimer un filtre W de taille M.L tel que :

où : - x i (t) est le vecteur [xi (t - L + 1) ... xi (t)] T et
- x(t) = [x1(t) T x2(t) T ... x M (t) T ] T .
- La solution est donnée par le filtre de Wiener :

- Dans la mesure où, comme on l'a expliqué en introduction, pour la partie BF du spectre on cherche à estimer le bruit et non plus le signal utile, on obtient :

- Cette prédiction du bruit présent sur un micro est opérée à partir du bruit présent sur tous les micros considérés du second sous-réseau R2, et ceci dans les périodes de silence du locuteur, où seul le bruit est présent.
- La technique utilisée est voisine de celle du débruitage ANC (Adaptative Noise Cancellation), en utilisant plusieurs micros pour la prédiction et en incluant dans le filtrage un micro de référence (par exemple le micro M1). La technique ANC est exposée notamment par :
- [7] B. Widrow, J. Glover, J.R., J. McCool, J. Kaunitz, C. Williams, R. Hearn, J. Zeidler, J. Eugene Dong, and R. Goodlin, "Adaptive Noise Cancelling : Principles and applications," Proceedings of the IEEE, Vol. 63, No. 12, pp. 1692-1716, Dec. 1975.
- Comme illustré sur la
Figure 3 , le filtre de Wiener (bloc 44) fournit une prédiction du bruit qui est soustraite en 46 du signal recueilli, non débruité, après application d'un retard (bloc 48) pour éviter les problèmes de causalité. Le filtre de Wiener 44 est paramétré par un coefficient µ (schématisé en 50) qui détermine une pondération ajustable entre, d'une part, la distorsion introduite par le traitement sur le signal vocal débruité et, d'autre part, le niveau de bruit résiduel. - Dans le cas d'un signal recueilli par un plus grand nombre de micros, la généralisation de ce schéma de la prédiction de bruit pondéré est donnée
Figure 4 . - Le signal estimé étant :

la solution est donnée, de la même façon que précédemment, par le filtre de Wiener :
- Le signal estimé est alors rigoureusement le même, car on peut prouver que


- Le filtre de Wiener utilisé est avantageusement un filtre de Wiener pondéré (SDW-MVF), pour prendre en compte non seulement l'énergie du bruit à éliminer par le filtrage, mais également la distorsion introduite par ce filtrage et qu'il convient de minimiser.
- Dans le cas du filtre de Wiener Ŵ k , la "fonction de cout" peut être séparée en deux, l'écart quadratique moyen pouvant s'écrire comme la somme de deux termes :

où : - si (t) est le vecteur [si (t - L + 1) ... si (t)] T
- s(t) = [s1(t) T s2(t) T ... s M (t) T ] T
- b i (t) est le vecteur ┌b i (t - L + 1) ... bi (t)┐ T et
- b(t) = [b1(t) T b2(t) T ... b M (t) T ] T
- es est la distorsion introduite par le filtrage sur le signal utile, et
- eb est le bruit résiduel après filtrage.
- Il est possible de pondérer ces deux erreurs es et eb selon que l'on privilégie la réduction de distorsion ou bien la réduction du bruit résiduel.
- En invoquant la décorrélation entre bruit et signal utile, le problème devient :


l'indice ".r ' indiquant que l'on régularise la fonction de cout pour pondérer selon la distorsion, et µ étant un paramètre ajustable : - plus µ est grand, plus l'on privilégie la réduction du bruit, mais au prix d'une distorsion plus importante sur le signal utile ;
- si µ est nul, aucune importance n'est accordée à la réduction du bruit, et la sortie vaut xk (t) car les coefficients du filtre sont nuls ;
- si µ est infini, les coefficients du filtre sont nuls à l'exception du terme en position k*L (L étant la longueur du filtre) qui vaut 1, la sortie vaut donc zéro.
- Pour le filtre dual


avec pour solution :
- On démontre également que le signal de sortie est le même quelle que soit l'approche utilisée.
- Ce filtre est mis en oeuvre de manière adaptative, par un algorithme de descente de gradient tel que celui exposé dans l'article [6] précité.
- Le schéma est celui illustré
Figures 3 et4 . - Pour la mise en oeuvre de ce filtre, il est nécessaire d'estimer les matrices R s = E[s(t)s(t) T ], R b = E[b(t)b(t) T ], le vecteur E[b(t)bk (t)] ainsi que les paramètres L (la longueur souhaitée pour le filtre) et µ (qui ajuste la pondération entre réduction de bruit et distorsion).
- Si l'on suppose que l'on dispose d'un détecteur d'activité vocale (qui permet de discriminer entre phases de parole du locuteur et phases de silence) et que le bruit b(t) est stationnaire, on peut estimer R b durant les phases de silence, où seul le bruit est capté par les micros. Pendant ces phases de silence, on estime la matrice R b au fil de l'eau :

λ étant un facteur d'oubli. - On peut estimer E[b(t)bk(t)], ou remarquer que c'est une colonne de R b . Pour estimer R s , on invoque la décorrélation du bruit et du signal utile. Si l'on note R x = E[x(t)x(t) T ], on peut alors écrire : R x = R s + R b .
- On peut estimer R x de la même façon que R b , mais sans condition sur la présence de parole :

ce qui permet de déduire R s (t) = R x (t) - R b (t). - En ce qui concerne la longueur L du filtre, ce paramètre doit correspondre à une réalité spatiale et temporelle, avec un nombre de coefficients suffisant pour prédire le bruit temporellement (cohérence temporelle du bruit) et spatialement (transfert spatial entre les micros).
- Le paramètre µ est ajusté expérimentalement, en l'augmentant jusqu'à ce que la distorsion sur la voix devienne perceptible à l'oreille.
- Ces estimateurs sont utilisés pour opérer une descente de gradient sur la fonction de cout suivante :

- Le gradient de cette fonction vaut :

- D'où l'équation de mise à jour :

où α est un pas d'adaptation proportionnel à
Claims (14)
- Un procédé de débruitage d'un signal acoustique bruité pour un dispositif audio multi-microphone opérant dans un milieu bruité,
le signal acoustique bruité comprenant une composante utile issue d'une source de parole et une composante parasite de bruit,
ledit dispositif comprenant un réseau de capteurs formé d'une pluralité de capteurs microphoniques (M1 ... M4) disposés selon une configuration prédéterminée et aptes à recueillir le signal bruité,
les capteurs étant regroupés en deux sous-réseaux, avec un premier sous-réseau (R1) de capteurs apte à recueillir une partie haute fréquence du spectre, et un second sous-réseau (R2) de capteurs apte à recueillir une partie basse fréquence du spectre distincte de ladite partie haute fréquence,
ce procédé comportant les étapes suivantes :a) partition du spectre du signal bruité en ladite partie haute fréquence (HF) et ladite partie basse fréquence (BF), par filtrage (10, 16) respectivement au-delà et en deçà d'une fréquence pivot prédéterminée,b) débruitage de chacune des deux parties du spectre avec mise en oeuvre d'un estimateur à algorithme adaptatif ; etc) reconstruction du spectre par combinaison (22) des signaux délivrés après débruitage des deux parties du spectre aux étapes b1) et b2),procédé caractérisé en ce que l'étape b) de débruitage est opérée par des traitements distincts pour chacune des deux parties du spectre, avec :b1) pour la partie haute fréquence, un débruitage exploitant le caractère prédictible du signal utile d'un capteur sur l'autre entre capteurs du premier sous-réseau, au moyen d'un premier estimateur (14) à algorithme adaptatif, etb2) pour la partie basse fréquence, un débruitage par prédiction du bruit d'un capteur sur l'autre entre capteurs du second sous-réseau, au moyen d'un second estimateur (18) à algorithme adaptatif. - Le procédé de la revendication 1, dans lequel le premier sous-réseau de capteurs (R1) apte à recueillir la partie haute fréquence du spectre comprend un réseau linaire d'au moins deux capteurs (M1, M3, M4) alignés perpendiculairement à la direction (Δ) de la source de parole.
- Le procédé de la revendication 1, dans lequel le second sous-réseau de capteurs (R2) apte à recueillir la partie basse fréquence du spectre comprend un réseau linaire d'au moins deux capteurs (M1, M2) alignés parallèlement à la direction (Δ) de la source de parole.
- Le procédé de la revendication 2, dans lequel les capteurs (M1, M3, M4) du premier sous-réseau de capteurs (R1) sont des capteurs unidirectionnels orientés dans la direction (Δ) de la source de parole.
- Le procédé de la revendication 2, dans lequel le traitement de débruitage de la partie haute fréquence du spectre à l'étape b1) est opéré de façon différenciée pour une bande inférieure et une bande supérieure de cette partie haute fréquence, avec sélection de capteurs différents parmi les capteurs du premier sous-réseau (R1), la distance entre les capteurs (M1, M4) sélectionnés pour le débruitage de la bande supérieure étant plus réduite que celle des capteurs (M3, M4) sélectionnés pour le débruitage de la bande inférieure.
- Le procédé de la revendication 1 comprenant en outre, après l'étape c) de reconstruction du spectre, une étape de :d) réduction sélective du bruit (24) par un traitement de type gain à amplitude log-spectrale modifié optimisé, OM-LSA, à partir du signal reconstruit produit à l'étape c) et d'une probabilité de présence de parole.
- Le procédé de la revendication 1 dans lequel l'étape b1) de débruitage de la partie haute fréquence, exploitant le caractère prédictible du signal utile d'un capteur sur l'autre, est opérée dans le domaine fréquentiel.
- Le procédé de la revendication 7 dans lequel l'étape b1) de débruitage de la partie haute fréquence, exploitant le caractère prédictible du signal utile d'un capteur sur l'autre, est opérée par :b11) estimation (34) d'une probabilité de présence de parole (SPP) dans le signal bruité recueilli ;b12) estimation (32) d'une matrice spectrale de covariance des bruits recueillis par les capteurs du premier sous-réseau, cette estimation étant modulée par la probabilité de présence de parole ;b13) estimation (30) de la fonction de transfert des canaux acoustiques entre la source de parole et au moins certains des capteurs du premier sous-réseau, cette estimation étant opérée par rapport à une référence de signal utile constituée par le signal recueilli par l'un des capteurs du premier sous-réseau, et étant en outre modulée par la probabilité de présence de parole ; etb14) calcul (28) d'un projecteur linéaire optimal donnant un signal combiné débruité unique à partir des signaux recueillis par au moins certains des capteurs du premier sous-réseau, de la matrice spectrale de covariance estimée à l'étape b12), et des fonctions de transfert estimées à l'étape b13).
- Le procédé de la revendication 8, dans lequel l'étape b14) de calcul d'un projecteur linéaire optimal (28) est mise en oeuvre par un estimateur de type beamforming à réponse sans distorsion à variance minimale, MVDR.
- Le procédé de la revendication 9, dans lequel l'étape b13) d'estimation de la fonction de transfert des canaux acoustiques (30) est mise en oeuvre par un filtre adaptatif (36, 38, 40) à prédiction linéaire de type moindres carrés moyens, LMS, avec modulation (42) par la probabilité de présence de parole.
- Le procédé de la revendication 10, dans lequel ladite modulation par la probabilité de présence de parole est une modulation par variation du pas d'itération du filtre adaptatif LMS.
- Le procédé de la revendication 1 dans lequel, pour le débruitage de la partie basse fréquence à l'étape b2), la prédiction du bruit d'un capteur sur l'autre est opérée dans le domaine temporel.
- Le procédé de la revendication 12, dans lequel la prédiction du bruit d'un capteur sur l'autre est mise en oeuvre par un filtre (44, 46, 48) de type filtre de Wiener multicanal avec pondération par la distorsion de la parole, SDW-MWF.
- Le procédé de la revendication 13, dans lequel le filtre SDW-MWF est estimé de manière adaptative par un algorithme de descente de gradient.
Applications Claiming Priority (1)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| FR1256049A FR2992459B1 (fr) | 2012-06-26 | 2012-06-26 | Procede de debruitage d'un signal acoustique pour un dispositif audio multi-microphone operant dans un milieu bruite. |
Publications (2)
| Publication Number | Publication Date |
|---|---|
| EP2680262A1 EP2680262A1 (fr) | 2014-01-01 |
| EP2680262B1 true EP2680262B1 (fr) | 2015-05-13 |
Family
ID=47227906
Family Applications (1)
| Application Number | Title | Priority Date | Filing Date |
|---|---|---|---|
| EP13171948.6A Active EP2680262B1 (fr) | 2012-06-26 | 2013-06-14 | Procédé de débruitage d'un signal acoustique pour un dispositif audio multi-microphone opérant dans un milieu bruité |
Country Status (4)
| Country | Link |
|---|---|
| US (1) | US9338547B2 (fr) |
| EP (1) | EP2680262B1 (fr) |
| CN (1) | CN103517185B (fr) |
| FR (1) | FR2992459B1 (fr) |
Families Citing this family (31)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| CN103329566A (zh) * | 2010-12-20 | 2013-09-25 | 峰力公司 | 用于房间中的语音增强的方法和系统 |
| AU2013300143A1 (en) * | 2012-05-31 | 2014-11-27 | University Of Mississippi | Systems and methods for detecting transient acoustic signals |
| JP6349899B2 (ja) * | 2014-04-14 | 2018-07-04 | ヤマハ株式会社 | 放収音装置 |
| US10149047B2 (en) * | 2014-06-18 | 2018-12-04 | Cirrus Logic Inc. | Multi-aural MMSE analysis techniques for clarifying audio signals |
| US10242690B2 (en) | 2014-12-12 | 2019-03-26 | Nuance Communications, Inc. | System and method for speech enhancement using a coherent to diffuse sound ratio |
| US10602265B2 (en) * | 2015-05-04 | 2020-03-24 | Rensselaer Polytechnic Institute | Coprime microphone array system |
| US9691238B2 (en) * | 2015-07-29 | 2017-06-27 | Immersion Corporation | Crowd-based haptics |
| EP3171613A1 (fr) * | 2015-11-20 | 2017-05-24 | Harman Becker Automotive Systems GmbH | Amélioration audio |
| DE102015016380B4 (de) * | 2015-12-16 | 2023-10-05 | e.solutions GmbH | Technik zum Unterdrücken akustischer Störsignale |
| CN107045874B (zh) * | 2016-02-05 | 2021-03-02 | 深圳市潮流网络技术有限公司 | 一种基于相关性的非线性语音增强方法 |
| CN106289506B (zh) * | 2016-09-06 | 2019-03-05 | 大连理工大学 | 一种使用pod分解法消除流场壁面麦克风阵列噪声信号的方法 |
| US9906859B1 (en) * | 2016-09-30 | 2018-02-27 | Bose Corporation | Noise estimation for dynamic sound adjustment |
| JP7175441B2 (ja) * | 2016-12-23 | 2022-11-21 | シナプティクス インコーポレイテッド | 雑音のある時変環境のための重み付け予測誤差に基づくオンライン残響除去アルゴリズム |
| CN107910011B (zh) * | 2017-12-28 | 2021-05-04 | 科大讯飞股份有限公司 | 一种语音降噪方法、装置、服务器及存储介质 |
| CN108074585A (zh) * | 2018-02-08 | 2018-05-25 | 河海大学常州校区 | 一种基于声源特征的语音异常检测方法 |
| CN108449687B (zh) * | 2018-03-13 | 2019-04-26 | 江苏华腾智能科技有限公司 | 一种多麦克风阵列降噪的会议系统 |
| CN108564963B (zh) * | 2018-04-23 | 2019-10-18 | 百度在线网络技术(北京)有限公司 | 用于增强语音的方法和装置 |
| CN108831495B (zh) * | 2018-06-04 | 2022-11-29 | 桂林电子科技大学 | 一种应用于噪声环境下语音识别的语音增强方法 |
| CN109949810B (zh) * | 2019-03-28 | 2021-09-07 | 荣耀终端有限公司 | 一种语音唤醒方法、装置、设备及介质 |
| US11900730B2 (en) * | 2019-12-18 | 2024-02-13 | Cirrus Logic Inc. | Biometric identification |
| CN111028857B (zh) * | 2019-12-27 | 2024-01-19 | 宁波蛙声科技有限公司 | 基于深度学习的多通道音视频会议降噪的方法及系统 |
| TWI789577B (zh) * | 2020-04-01 | 2023-01-11 | 同響科技股份有限公司 | 音訊資料重建方法及系統 |
| CN111447524B (zh) * | 2020-04-22 | 2025-06-27 | 东莞市猎声电子科技有限公司 | 一种多分频独立处理降噪耳机及其降噪方法 |
| CN113948098B (zh) * | 2020-07-17 | 2025-06-10 | 华为技术有限公司 | 一种立体声音频信号时延估计方法及装置 |
| WO2022027208A1 (fr) * | 2020-08-04 | 2022-02-10 | 华为技术有限公司 | Procédé d'annulation active du bruit, appareil d'annulation active du bruit et système d'annulation active du bruit |
| CN114822571B (zh) * | 2021-04-25 | 2024-11-15 | 美的集团(上海)有限公司 | 一种回声消除方法、装置、电子设备和存储介质 |
| CN115223582B (zh) * | 2021-12-16 | 2024-01-30 | 广州汽车集团股份有限公司 | 一种音频的噪声处理方法、系统、电子装置及介质 |
| US11948547B2 (en) * | 2021-12-17 | 2024-04-02 | Hyundai Motor Company | Information quantity-based reference sensor selection and active noise control using the same |
| CN114999512A (zh) * | 2022-05-26 | 2022-09-02 | 山东衡昊信息技术有限公司 | 一种基于最值限定的人工耳蜗语音信号净化方法 |
| CN115840120B (zh) * | 2023-02-24 | 2023-04-28 | 山东科华电力技术有限公司 | 一种高压电缆局放异常监测及预警方法 |
| CN120808809B (zh) * | 2025-09-09 | 2025-11-11 | 陕西欧迪亚实业有限公司 | 智能降噪设备的宽频带自适应滤波与反向声波合成方法 |
Family Cites Families (10)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| US8280072B2 (en) * | 2003-03-27 | 2012-10-02 | Aliphcom, Inc. | Microphone array with rear venting |
| US7617099B2 (en) * | 2001-02-12 | 2009-11-10 | FortMedia Inc. | Noise suppression by two-channel tandem spectrum modification for speech signal in an automobile |
| EP1640971B1 (fr) * | 2004-09-23 | 2008-08-20 | Harman Becker Automotive Systems GmbH | Traitement adaptatif d'un signal de parole multicanaux avec suppression du bruit |
| CN100571295C (zh) * | 2005-08-02 | 2009-12-16 | 明基电通股份有限公司 | 一种可降低麦克风噪声的移动装置和方法 |
| US8488803B2 (en) * | 2007-05-25 | 2013-07-16 | Aliphcom | Wind suppression/replacement component for use with electronic systems |
| ATE551692T1 (de) * | 2008-02-05 | 2012-04-15 | Phonak Ag | Verfahren zur verringerung von rauschen in einem eingangssignal eines hörgeräts sowie ein hörgerät |
| US8321214B2 (en) * | 2008-06-02 | 2012-11-27 | Qualcomm Incorporated | Systems, methods, and apparatus for multichannel signal amplitude balancing |
| FR2945696B1 (fr) * | 2009-05-14 | 2012-02-24 | Parrot | Procede de selection d'un microphone parmi deux microphones ou plus, pour un systeme de traitement de la parole tel qu'un dispositif telephonique "mains libres" operant dans un environnement bruite. |
| KR101782050B1 (ko) * | 2010-09-17 | 2017-09-28 | 삼성전자주식회사 | 비등간격으로 배치된 마이크로폰을 이용한 음질 향상 장치 및 방법 |
| FR2976710B1 (fr) * | 2011-06-20 | 2013-07-05 | Parrot | Procede de debruitage pour equipement audio multi-microphones, notamment pour un systeme de telephonie "mains libres" |
-
2012
- 2012-06-26 FR FR1256049A patent/FR2992459B1/fr not_active Expired - Fee Related
-
2013
- 2013-06-11 US US13/915,298 patent/US9338547B2/en active Active
- 2013-06-14 EP EP13171948.6A patent/EP2680262B1/fr active Active
- 2013-06-25 CN CN201310256621.1A patent/CN103517185B/zh active Active
Also Published As
| Publication number | Publication date |
|---|---|
| CN103517185A (zh) | 2014-01-15 |
| US20130343558A1 (en) | 2013-12-26 |
| US9338547B2 (en) | 2016-05-10 |
| EP2680262A1 (fr) | 2014-01-01 |
| FR2992459A1 (fr) | 2013-12-27 |
| CN103517185B (zh) | 2018-09-21 |
| FR2992459B1 (fr) | 2014-08-15 |
Similar Documents
| Publication | Publication Date | Title |
|---|---|---|
| EP2680262A1 (fr) | Procédé de débruitage d'un signal acoustique pour un dispositif audio multi-microphone opérant dans un milieu bruité | |
| EP2538409B1 (fr) | Procédé de débruitage pour équipement audio multi-microphones, notamment pour un système de téléphonie "mains libres" | |
| EP2530673B1 (fr) | Equipement audio comprenant des moyens de débruitage d'un signal de parole par filtrage à délai fractionnaire | |
| EP2293594B1 (fr) | Procédé de filtrage des bruits latéraux non-stationnaires pour un dispositif audio multi-microphone, notamment un dispositif téléphonique "mains libres" pour véhicule automobile | |
| EP2309499B1 (fr) | Procédé de filtrage optimisé des bruits non stationnaires captés par un dispositif audio multi-microphone, notamment un dispositif téléphonique "mains libres" pour véhicule automobile | |
| EP2518724B1 (fr) | Combiné audio micro/casque comprenant des moyens de débruitage d'un signal de parole proche, notamment pour un système de téléphonie "mains libres" | |
| EP2122607B1 (fr) | Procede de reduction active d'une nuisance sonore | |
| EP2772916B1 (fr) | Procédé de débruitage d'un signal audio par un algorithme à gain spectral variable à dureté modulable dynamiquement | |
| US7761291B2 (en) | Method for processing audio-signals | |
| US9467775B2 (en) | Method and a system for noise suppressing an audio signal | |
| JP2009522942A (ja) | 発話改善のためにマイク間レベル差を用いるシステム及び方法 | |
| EP3025342B1 (fr) | Procédé de suppression de la réverbération tardive d'un signal sonore | |
| EP0884926B1 (fr) | Procédé et dispositif de traitement optimisé d'un signal perturbateur lors d'une prise de son | |
| EP4315328B1 (fr) | Estimation d'un masque optimise pour le traitement de donnees sonores acquises | |
| Kim et al. | Probabilistic spectral gain modification applied to beamformer-based noise reduction in a car environment | |
| FR2906070A1 (fr) | Reduction de bruit multi-reference pour des applications vocales en environnement automobile | |
| WO2017207286A1 (fr) | Combine audio micro/casque comprenant des moyens de detection d'activite vocale multiples a classifieur supervise | |
| Plucienkowski et al. | Combined front-end signal processing for in-vehicle speech systems. | |
| FR2906071A1 (fr) | Reduction de bruit multibande avec une reference de bruit non acoustique | |
| CN115481649A (zh) | 信号滤波方法及装置、存储介质、电子装置 | |
| KR20190136841A (ko) | 다중 마이크로폰을 가진 디지털 보청기 | |
| FR2878399A1 (fr) | Dispositif et procede de debruitage a deux voies mettant en oeuvre une fonction de coherence associee a une utilisation de proprietes psychoacoustiques, et programme d'ordinateur correspondant |
Legal Events
| Date | Code | Title | Description |
|---|---|---|---|
| PUAI | Public reference made under article 153(3) epc to a published international application that has entered the european phase |
Free format text: ORIGINAL CODE: 0009012 |
|
| 17P | Request for examination filed |
Effective date: 20130617 |
|
| AK | Designated contracting states |
Kind code of ref document: A1 Designated state(s): AL AT BE BG CH CY CZ DE DK EE ES FI FR GB GR HR HU IE IS IT LI LT LU LV MC MK MT NL NO PL PT RO RS SE SI SK SM TR |
|
| AX | Request for extension of the european patent |
Extension state: BA ME |
|
| RBV | Designated contracting states (corrected) |
Designated state(s): AL AT BE BG CH CY CZ DE DK EE ES FI FR GB GR HR HU IE IS IT LI LT LU LV MC MK MT NL NO PL PT RO RS SE SI SK SM TR |
|
| GRAP | Despatch of communication of intention to grant a patent |
Free format text: ORIGINAL CODE: EPIDOSNIGR1 |
|
| INTG | Intention to grant announced |
Effective date: 20141217 |
|
| GRAS | Grant fee paid |
Free format text: ORIGINAL CODE: EPIDOSNIGR3 |
|
| GRAA | (expected) grant |
Free format text: ORIGINAL CODE: 0009210 |
|
| AK | Designated contracting states |
Kind code of ref document: B1 Designated state(s): AL AT BE BG CH CY CZ DE DK EE ES FI FR GB GR HR HU IE IS IT LI LT LU LV MC MK MT NL NO PL PT RO RS SE SI SK SM TR |
|
| REG | Reference to a national code |
Ref country code: GB Ref legal event code: FG4D Free format text: NOT ENGLISH |
|
| REG | Reference to a national code |
Ref country code: CH Ref legal event code: EP |
|
| REG | Reference to a national code |
Ref country code: IE Ref legal event code: FG4D Free format text: LANGUAGE OF EP DOCUMENT: FRENCH |
|
| REG | Reference to a national code |
Ref country code: AT Ref legal event code: REF Ref document number: 727090 Country of ref document: AT Kind code of ref document: T Effective date: 20150615 |
|
| REG | Reference to a national code |
Ref country code: DE Ref legal event code: R096 Ref document number: 602013001738 Country of ref document: DE Effective date: 20150625 Ref country code: FR Ref legal event code: PLFP Year of fee payment: 3 |
|
| REG | Reference to a national code |
Ref country code: NL Ref legal event code: T3 |
|
| REG | Reference to a national code |
Ref country code: AT Ref legal event code: MK05 Ref document number: 727090 Country of ref document: AT Kind code of ref document: T Effective date: 20150513 |
|
| REG | Reference to a national code |
Ref country code: LT Ref legal event code: MG4D |
|
| PG25 | Lapsed in a contracting state [announced via postgrant information from national office to epo] |
Ref country code: ES Free format text: LAPSE BECAUSE OF FAILURE TO SUBMIT A TRANSLATION OF THE DESCRIPTION OR TO PAY THE FEE WITHIN THE PRESCRIBED TIME-LIMIT Effective date: 20150513 Ref country code: HR Free format text: LAPSE BECAUSE OF FAILURE TO SUBMIT A TRANSLATION OF THE DESCRIPTION OR TO PAY THE FEE WITHIN THE PRESCRIBED TIME-LIMIT Effective date: 20150513 Ref country code: PT Free format text: LAPSE BECAUSE OF FAILURE TO SUBMIT A TRANSLATION OF THE DESCRIPTION OR TO PAY THE FEE WITHIN THE PRESCRIBED TIME-LIMIT Effective date: 20150914 Ref country code: LT Free format text: LAPSE BECAUSE OF FAILURE TO SUBMIT A TRANSLATION OF THE DESCRIPTION OR TO PAY THE FEE WITHIN THE PRESCRIBED TIME-LIMIT Effective date: 20150513 Ref country code: NO Free format text: LAPSE BECAUSE OF FAILURE TO SUBMIT A TRANSLATION OF THE DESCRIPTION OR TO PAY THE FEE WITHIN THE PRESCRIBED TIME-LIMIT Effective date: 20150813 Ref country code: FI Free format text: LAPSE BECAUSE OF FAILURE TO SUBMIT A TRANSLATION OF THE DESCRIPTION OR TO PAY THE FEE WITHIN THE PRESCRIBED TIME-LIMIT Effective date: 20150513 |
|
| PG25 | Lapsed in a contracting state [announced via postgrant information from national office to epo] |
Ref country code: RS Free format text: LAPSE BECAUSE OF FAILURE TO SUBMIT A TRANSLATION OF THE DESCRIPTION OR TO PAY THE FEE WITHIN THE PRESCRIBED TIME-LIMIT Effective date: 20150513 Ref country code: BG Free format text: LAPSE BECAUSE OF FAILURE TO SUBMIT A TRANSLATION OF THE DESCRIPTION OR TO PAY THE FEE WITHIN THE PRESCRIBED TIME-LIMIT Effective date: 20150813 Ref country code: AT Free format text: LAPSE BECAUSE OF FAILURE TO SUBMIT A TRANSLATION OF THE DESCRIPTION OR TO PAY THE FEE WITHIN THE PRESCRIBED TIME-LIMIT Effective date: 20150513 Ref country code: LV Free format text: LAPSE BECAUSE OF FAILURE TO SUBMIT A TRANSLATION OF THE DESCRIPTION OR TO PAY THE FEE WITHIN THE PRESCRIBED TIME-LIMIT Effective date: 20150513 Ref country code: GR Free format text: LAPSE BECAUSE OF FAILURE TO SUBMIT A TRANSLATION OF THE DESCRIPTION OR TO PAY THE FEE WITHIN THE PRESCRIBED TIME-LIMIT Effective date: 20150814 Ref country code: IS Free format text: LAPSE BECAUSE OF FAILURE TO SUBMIT A TRANSLATION OF THE DESCRIPTION OR TO PAY THE FEE WITHIN THE PRESCRIBED TIME-LIMIT Effective date: 20150913 |
|
| PG25 | Lapsed in a contracting state [announced via postgrant information from national office to epo] |
Ref country code: DK Free format text: LAPSE BECAUSE OF FAILURE TO SUBMIT A TRANSLATION OF THE DESCRIPTION OR TO PAY THE FEE WITHIN THE PRESCRIBED TIME-LIMIT Effective date: 20150513 Ref country code: EE Free format text: LAPSE BECAUSE OF FAILURE TO SUBMIT A TRANSLATION OF THE DESCRIPTION OR TO PAY THE FEE WITHIN THE PRESCRIBED TIME-LIMIT Effective date: 20150513 |
|
| REG | Reference to a national code |
Ref country code: DE Ref legal event code: R097 Ref document number: 602013001738 Country of ref document: DE |
|
| PG25 | Lapsed in a contracting state [announced via postgrant information from national office to epo] |
Ref country code: CZ Free format text: LAPSE BECAUSE OF FAILURE TO SUBMIT A TRANSLATION OF THE DESCRIPTION OR TO PAY THE FEE WITHIN THE PRESCRIBED TIME-LIMIT Effective date: 20150513 Ref country code: MC Free format text: LAPSE BECAUSE OF FAILURE TO SUBMIT A TRANSLATION OF THE DESCRIPTION OR TO PAY THE FEE WITHIN THE PRESCRIBED TIME-LIMIT Effective date: 20150513 Ref country code: RO Free format text: LAPSE BECAUSE OF NON-PAYMENT OF DUE FEES Effective date: 20150513 Ref country code: PL Free format text: LAPSE BECAUSE OF FAILURE TO SUBMIT A TRANSLATION OF THE DESCRIPTION OR TO PAY THE FEE WITHIN THE PRESCRIBED TIME-LIMIT Effective date: 20150513 Ref country code: SK Free format text: LAPSE BECAUSE OF FAILURE TO SUBMIT A TRANSLATION OF THE DESCRIPTION OR TO PAY THE FEE WITHIN THE PRESCRIBED TIME-LIMIT Effective date: 20150513 |
|
| PLBE | No opposition filed within time limit |
Free format text: ORIGINAL CODE: 0009261 |
|
| STAA | Information on the status of an ep patent application or granted ep patent |
Free format text: STATUS: NO OPPOSITION FILED WITHIN TIME LIMIT |
|
| REG | Reference to a national code |
Ref country code: IE Ref legal event code: MM4A |
|
| 26N | No opposition filed |
Effective date: 20160216 |
|
| PG25 | Lapsed in a contracting state [announced via postgrant information from national office to epo] |
Ref country code: IE Free format text: LAPSE BECAUSE OF NON-PAYMENT OF DUE FEES Effective date: 20150614 |
|
| PG25 | Lapsed in a contracting state [announced via postgrant information from national office to epo] |
Ref country code: SI Free format text: LAPSE BECAUSE OF FAILURE TO SUBMIT A TRANSLATION OF THE DESCRIPTION OR TO PAY THE FEE WITHIN THE PRESCRIBED TIME-LIMIT Effective date: 20150513 |
|
| REG | Reference to a national code |
Ref country code: FR Ref legal event code: PLFP Year of fee payment: 4 |
|
| PG25 | Lapsed in a contracting state [announced via postgrant information from national office to epo] |
Ref country code: MT Free format text: LAPSE BECAUSE OF FAILURE TO SUBMIT A TRANSLATION OF THE DESCRIPTION OR TO PAY THE FEE WITHIN THE PRESCRIBED TIME-LIMIT Effective date: 20150513 |
|
| REG | Reference to a national code |
Ref country code: DE Ref legal event code: R081 Ref document number: 602013001738 Country of ref document: DE Owner name: PARROT AUTOMOTIVE, FR Free format text: FORMER OWNER: PARROT, PARIS, FR |
|
| REG | Reference to a national code |
Ref country code: CH Ref legal event code: PL |
|
| REG | Reference to a national code |
Ref country code: NL Ref legal event code: PD Owner name: PARROT AUTOMOTIVE; FR Free format text: DETAILS ASSIGNMENT: CHANGE OF OWNER(S), ASSIGNMENT; FORMER OWNER NAME: PARROT Effective date: 20170125 |
|
| REG | Reference to a national code |
Ref country code: FR Ref legal event code: TP Owner name: PARROT AUTOMOTIVE, FR Effective date: 20170106 |
|
| REG | Reference to a national code |
Ref country code: GB Ref legal event code: 732E Free format text: REGISTERED BETWEEN 20170223 AND 20170303 |
|
| PG25 | Lapsed in a contracting state [announced via postgrant information from national office to epo] |
Ref country code: LI Free format text: LAPSE BECAUSE OF NON-PAYMENT OF DUE FEES Effective date: 20160630 Ref country code: CH Free format text: LAPSE BECAUSE OF NON-PAYMENT OF DUE FEES Effective date: 20160630 |
|
| PG25 | Lapsed in a contracting state [announced via postgrant information from national office to epo] |
Ref country code: HU Free format text: LAPSE BECAUSE OF FAILURE TO SUBMIT A TRANSLATION OF THE DESCRIPTION OR TO PAY THE FEE WITHIN THE PRESCRIBED TIME-LIMIT; INVALID AB INITIO Effective date: 20130614 |
|
| REG | Reference to a national code |
Ref country code: FR Ref legal event code: PLFP Year of fee payment: 5 |
|
| PG25 | Lapsed in a contracting state [announced via postgrant information from national office to epo] |
Ref country code: SE Free format text: LAPSE BECAUSE OF FAILURE TO SUBMIT A TRANSLATION OF THE DESCRIPTION OR TO PAY THE FEE WITHIN THE PRESCRIBED TIME-LIMIT Effective date: 20150513 Ref country code: CY Free format text: LAPSE BECAUSE OF FAILURE TO SUBMIT A TRANSLATION OF THE DESCRIPTION OR TO PAY THE FEE WITHIN THE PRESCRIBED TIME-LIMIT Effective date: 20150513 |
|
| PG25 | Lapsed in a contracting state [announced via postgrant information from national office to epo] |
Ref country code: BE Free format text: LAPSE BECAUSE OF NON-PAYMENT OF DUE FEES Effective date: 20150630 |
|
| PG25 | Lapsed in a contracting state [announced via postgrant information from national office to epo] |
Ref country code: TR Free format text: LAPSE BECAUSE OF FAILURE TO SUBMIT A TRANSLATION OF THE DESCRIPTION OR TO PAY THE FEE WITHIN THE PRESCRIBED TIME-LIMIT Effective date: 20150513 |
|
| PG25 | Lapsed in a contracting state [announced via postgrant information from national office to epo] |
Ref country code: LU Free format text: LAPSE BECAUSE OF NON-PAYMENT OF DUE FEES Effective date: 20150614 |
|
| PG25 | Lapsed in a contracting state [announced via postgrant information from national office to epo] |
Ref country code: SM Free format text: LAPSE BECAUSE OF FAILURE TO SUBMIT A TRANSLATION OF THE DESCRIPTION OR TO PAY THE FEE WITHIN THE PRESCRIBED TIME-LIMIT Effective date: 20150513 |
|
| REG | Reference to a national code |
Ref country code: FR Ref legal event code: PLFP Year of fee payment: 6 |
|
| PG25 | Lapsed in a contracting state [announced via postgrant information from national office to epo] |
Ref country code: MK Free format text: LAPSE BECAUSE OF FAILURE TO SUBMIT A TRANSLATION OF THE DESCRIPTION OR TO PAY THE FEE WITHIN THE PRESCRIBED TIME-LIMIT Effective date: 20150513 |
|
| PG25 | Lapsed in a contracting state [announced via postgrant information from national office to epo] |
Ref country code: AL Free format text: LAPSE BECAUSE OF FAILURE TO SUBMIT A TRANSLATION OF THE DESCRIPTION OR TO PAY THE FEE WITHIN THE PRESCRIBED TIME-LIMIT Effective date: 20150513 |
|
| PGFP | Annual fee paid to national office [announced via postgrant information from national office to epo] |
Ref country code: NL Payment date: 20190619 Year of fee payment: 7 |
|
| REG | Reference to a national code |
Ref country code: NL Ref legal event code: MM Effective date: 20200701 |
|
| PG25 | Lapsed in a contracting state [announced via postgrant information from national office to epo] |
Ref country code: NL Free format text: LAPSE BECAUSE OF NON-PAYMENT OF DUE FEES Effective date: 20200701 |
|
| PGFP | Annual fee paid to national office [announced via postgrant information from national office to epo] |
Ref country code: IT Payment date: 20230523 Year of fee payment: 11 Ref country code: FR Payment date: 20230523 Year of fee payment: 11 |
|
| PGFP | Annual fee paid to national office [announced via postgrant information from national office to epo] |
Ref country code: GB Payment date: 20230523 Year of fee payment: 11 |
|
| GBPC | Gb: european patent ceased through non-payment of renewal fee |
Effective date: 20240614 |
|
| PG25 | Lapsed in a contracting state [announced via postgrant information from national office to epo] |
Ref country code: FR Free format text: LAPSE BECAUSE OF NON-PAYMENT OF DUE FEES Effective date: 20240630 |
|
| PG25 | Lapsed in a contracting state [announced via postgrant information from national office to epo] |
Ref country code: GB Free format text: LAPSE BECAUSE OF NON-PAYMENT OF DUE FEES Effective date: 20240614 Ref country code: IT Free format text: LAPSE BECAUSE OF NON-PAYMENT OF DUE FEES Effective date: 20240614 |
|
| PGFP | Annual fee paid to national office [announced via postgrant information from national office to epo] |
Ref country code: DE Payment date: 20250520 Year of fee payment: 13 |