CN110348564B - 基于systolic阵列的SCNN推理加速装置、处理器及计算机设备 - Google Patents
基于systolic阵列的SCNN推理加速装置、处理器及计算机设备 Download PDFInfo
- Publication number
- CN110348564B CN110348564B CN201910500982.3A CN201910500982A CN110348564B CN 110348564 B CN110348564 B CN 110348564B CN 201910500982 A CN201910500982 A CN 201910500982A CN 110348564 B CN110348564 B CN 110348564B
- Authority
- CN
- China
- Prior art keywords
- pulse
- membrane potential
- reg
- register
- weight
- Prior art date
- Legal status (The legal status is an assumption and is not a legal conclusion. Google has not performed a legal analysis and makes no representation as to the accuracy of the status listed.)
- Active
Links
Images



Classifications
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06N—COMPUTING ARRANGEMENTS BASED ON SPECIFIC COMPUTATIONAL MODELS
- G06N3/00—Computing arrangements based on biological models
- G06N3/02—Neural networks
- G06N3/04—Architecture, e.g. interconnection topology
- G06N3/045—Combinations of networks
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06N—COMPUTING ARRANGEMENTS BASED ON SPECIFIC COMPUTATIONAL MODELS
- G06N3/00—Computing arrangements based on biological models
- G06N3/02—Neural networks
- G06N3/06—Physical realisation, i.e. hardware implementation of neural networks, neurons or parts of neurons
- G06N3/063—Physical realisation, i.e. hardware implementation of neural networks, neurons or parts of neurons using electronic means
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06N—COMPUTING ARRANGEMENTS BASED ON SPECIFIC COMPUTATIONAL MODELS
- G06N5/00—Computing arrangements using knowledge-based models
- G06N5/04—Inference or reasoning models
Landscapes
- Engineering & Computer Science (AREA)
- Physics & Mathematics (AREA)
- Theoretical Computer Science (AREA)
- Software Systems (AREA)
- Health & Medical Sciences (AREA)
- Data Mining & Analysis (AREA)
- Computing Systems (AREA)
- General Engineering & Computer Science (AREA)
- General Physics & Mathematics (AREA)
- Mathematical Physics (AREA)
- Computational Linguistics (AREA)
- Artificial Intelligence (AREA)
- Evolutionary Computation (AREA)
- Life Sciences & Earth Sciences (AREA)
- Biomedical Technology (AREA)
- Biophysics (AREA)
- General Health & Medical Sciences (AREA)
- Molecular Biology (AREA)
- Neurology (AREA)
- Complex Calculations (AREA)
Abstract
本发明公开了一种基于systolic阵列的SCNN推理加速装置、处理器及计算机设备,本发明的SCNN推理加速装置包括systolic阵列和后处理单元,systolic阵列包括脉冲缓存、权值缓存、systolic控制器、处理单元阵列,用于脉冲与权值点积,后处理单元包括膜电位更新与脉冲产生模块、脉冲累积与最大池化模块、结果缓存、后处理机制控制器。本发明能高效利用片上数据、减少片外访存压力,能够对SCNN卷积层、池化层推理过程进行加速,具有计算密度大、吞吐率高、支持流水并行的特点,能够减少不必要的片外数据搬移,最大限度的利用片上数据,实现对卷积层、池化层推理的硬件加速。
Description
技术领域
本发明涉及图像实时处理的脉冲卷积神经网络(SCNN)硬件加速引擎技术,具体涉及一种基于systolic阵列的SCNN推理加速装置、处理器及计算机设备。
背景技术
人工神经网络是当前人工智能领域研究的热点。主流的方法是采用部分数据集对人工神经网络进行预先的训练(训练过程),而后将训练好的人工神经网络应用于实际的工作场景,利用其进行实际的图像分类、识别等操作(推理过程)。卷积神经网络(CNN)、脉冲神经网络(SNN)都属于人工神经网络。脉冲神经网络(SNN)主要通过模仿人脑神经元工作过程实现计算并行,减少功耗。传统的方法在训练SNN时存在网络性能弱,训练收敛慢的缺点,而卷积神经网络(CNN)直接转SNN的方法能够有效解决这一问题,该方法最终得到的SNN称为脉冲卷积神经网络(SCNN)。卷积神经网络(CNN)采用卷积核(Kernel)对图像进行特征识别,通过非线性函数过滤次要信息。在实际过程中还采用稀疏化方法减少神经元数目(池化操作)来提高计算性能。脉冲神经网络则通过对神经元间脉冲影响神经元内部膜电位更新,模仿生物神经元抑制兴奋机制,完成计算处理。在实际工作中,卷积神经网络(CNN)通过导数对层间误差进行修正,采用BP算法进行训练。脉冲卷积神经网络(SCNN)本身理论基于生物神经元工作原理,采用脉冲作为内部激励进行传导,本身无法求导。因此,采用拟生物训练算法进行训练。但是,该系列算法本身在训练上效率不高,收敛速度慢,最终得到的脉冲神经网络图像分类精度不高。针对这一情况,研究界有两种方案。一种是采用更加先进的拟生物的训练算法,进一步提高脉冲神经网络的训练效率,但目前进展甚微,另一种就是采用DNN转脉冲卷积神经网络(SCNN)的方式,通过间接方式保证脉冲卷积神经网络的训练效率,提高脉冲卷积神经网络的性能,以便高效的获取能够实际应用的脉冲神经网络。针对第二种方案,如何实现针对脉冲卷积神经网络(SCNN)进行硬件加速,尤其是采用同步电路对SCNN推理过程进行硬件加速,目前仍然是一项亟待解决的关键技术问题。
发明内容
本发明要解决的技术问题:针对现有技术的上述问题,提供一种基于systolic阵列的SCNN推理加速装置、处理器及计算机设备,本发明采用同步电路实现,通过内部数据流共享减少片外(off-chip)数据搬移,能够支持片上膜电位更新、池化操作,具有计算密度大、并行度高、吞吐率高的特点。
为了解决上述技术问题,本发明采用的技术方案为:
一种基于systolic阵列的SCNN推理加速装置,包括systolic阵列和后处理单元,所述systolic阵列包括:
脉冲缓存IB,用于输入脉冲缓存;
权值缓存WB,用于权值缓存;
systolic控制器systolic_ctrl,用于控制systolic阵列行为;
处理单元阵列PEs,用于脉冲与权值点积;
所述后处理单元包括:
膜电位更新与脉冲产生模块MU&SG,用于膜电位更新及脉冲产生;
脉冲累积与最大池化模块SA&MP,用于同一神经元的脉冲缓存以及池化操作;
结果缓存RB,用于结果脉冲缓存;
后处理机制控制器post_ctrl,用于控制后处理机制行为;
所述systolic控制器systolic_ctrl的控制输出端分别与脉冲缓存IB、权值缓存WB以及处理单元阵列PEs相连,所述脉冲缓存IB、权值缓存WB的输出端分别与处理单元阵列PEs的输入端相连,所述处理单元阵列PEs的输出端与后处理单元2的输入端相连;所述膜电位更新与脉冲产生模块MU&SG、脉冲累积与最大池化模块SA&MP、结果缓存RB依次相连且其控制端均与后处理机制控制器post_ctrl相连,所述膜电位更新与脉冲产生模块MU&SG根据处理单元阵列PEs的输出结果进行膜电位更新及脉冲产生,所述脉冲累积与最大池化模块SA&MP对膜电位更新与脉冲产生模块MU&SG输出的同一神经元的脉冲缓存以及池化操作,所述结果缓存RB用于将脉冲累积与最大池化模块SA&MP的输出缓存输出。
优选地,所述处理单元阵列PEs包括以systolic阵列形式组织的多个处理单元PE,每一个处理单元PE的包括脉冲寄存器spike_reg、权重寄存器weight_reg、零值判断器、控制寄存器control_reg、累积寄存器accumulate_reg、乘法器、选择器MUX和输出寄存器res_reg,上一级处理单元PE的脉冲输入激励pre_spike输入脉冲寄存器spike_reg并直接作为脉冲spike输出、权重输入激励pre_ weight输入权重寄存器weight_reg并直接作为权重weight输出,零值判断器对脉冲寄存器spike_reg中的值进行判断并在脉冲寄存器spike_reg中的值为0时写控制寄存器control_reg,在控制寄存器control_reg为1时乘法器将权重输入激励pre_ weight、脉冲输入激励pre_spike进行乘法运算并输出至累积寄存器accumulate_reg,且选择器MUX在控制信号switch_in的控制下选择将上一级处理单元PE的输出pre_res或累积寄存器accumulate_reg中的值写入输出寄存器res_reg并通过输出寄存器res_reg输出。
优选地,所述膜电位更新与脉冲产生模块MU&SG包括:
历史膜电位存储器RAM1,用于存储历史膜电位,且历史膜电位存储RAM每个块bank对应同一行中一个处理单元PE;
当前膜电位寄存器current_m_reg,用于缓存systolic阵列1输出的膜电位增量;
加法器,用于将systolic阵列1计算的膜电位增量与当前拍数对应的处理单元PE的历史膜电位进行累加得到加和值;
累加膜电位寄存器next_m_reg,用于存储加法器累加得到的加和值;
比较器CMP,用于将累加膜电位寄存器next_m_reg保存的加和值与膜电位阈值进行比较,若加和值大于膜电位阈值,则以膜电位复位值RESET_VALUE更新历史膜电位存储器RAM1中存储的历史膜电位,并完成脉冲点火,输出脉冲“1”;若加和值小于膜电位阈值,则以加和值更新历史膜电位存储器RAM1中存储的历史膜电位,输出脉冲“0”;
脉冲生成器spike_gen,用于根据比较器CMP的输出脉冲生成脉冲信号。
优选地,所述脉冲累积与最大池化模块SA&MP包括:
脉冲信号存储器RAM2,用于按照指定的长度批量存储膜电位更新与脉冲产生模块MU&SG输出的脉冲信号;
最大池化层,用于将脉冲信号存储器RAM2中的各批脉冲信号进行逻辑或运算输出。
此外,本发明还提供一种处理器,包括处理器本体,该处理器本体中设有所述的基于systolic阵列的SCNN推理加速装置。
此外,本发明还提供一种计算机设备,该计算机设备中设有所述的基于systolic阵列的SCNN推理加速装置。
和现有技术相比,本发明具有下述优点:本发明基于systolic阵列的SCNN推理加速装置包括systolic阵列和后处理单元,systolic阵列包括脉冲缓存IB、权值缓存WB、systolic控制器systolic_ctrl、处理单元阵列PEs,用于脉冲与权值点积,后处理单元包括膜电位更新与脉冲产生模块MU&SG、脉冲累积与最大池化模块SA&MP、结果缓存RB、后处理机制控制器post_ctrl,采用systolic阵列计算神经元膜电位更新值,通过硬件模块实现批次池化,从而高效利用片上数据、减少片外访存压力,支持人工神经元模型中的集成与点火模型(IF),能够对SCNN卷积层、池化层推理过程进行加速,具有计算密度大、吞吐率高、支持流水并行的特点,本发明能够减少不必要的片外(off-chip)数据搬移,最大限度的利用片上数据,实现对卷积层、池化层推理的硬件加速。
附图说明
图1为本发明实施例SCNN推理加速装置的基本结构示意图。
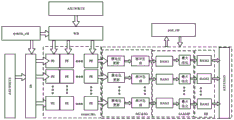
图2为本发明实施例SCNN推理加速装置的详细结构示意图。
图3为本发明实施例中处理单元的基本结构示意图。
图4为本发明实施例中膜电位更新与脉冲产生模块MU&SG的结构示意图。
图5为本发明实施例中脉冲累积与最大池化模块SA&MP的结构示意图。
具体实施方式
如图1所示,本实施例基于systolic阵列的SCNN推理加速装置包括systolic阵列1和后处理单元2,systolic阵列1包括:
脉冲缓存IB,用于输入脉冲缓存;
权值缓存WB,用于权值缓存;
systolic控制器systolic_ctrl,用于控制systolic阵列行为;
处理单元阵列PEs,用于脉冲与权值点积;
后处理单元2包括:
膜电位更新与脉冲产生模块MU&SG,用于膜电位更新及脉冲产生;
脉冲累积与最大池化模块SA&MP,用于同一神经元的脉冲缓存以及池化操作;
结果缓存RB,用于结果脉冲缓存;
后处理机制控制器post_ctrl,用于控制后处理机制行为;
systolic控制器systolic_ctrl的控制输出端分别与脉冲缓存IB、权值缓存WB以及处理单元阵列PEs相连,脉冲缓存IB、权值缓存WB的输出端分别与处理单元阵列PEs的输入端相连,处理单元阵列PEs的输出端与后处理单元2的输入端相连;膜电位更新与脉冲产生模块MU&SG、脉冲累积与最大池化模块SA&MP、结果缓存RB依次相连且其控制端均与后处理机制控制器post_ctrl相连,膜电位更新与脉冲产生模块MU&SG根据处理单元阵列PEs的输出结果进行膜电位更新及脉冲产生,脉冲累积与最大池化模块SA&MP对膜电位更新与脉冲产生模块MU&SG输出的同一神经元的脉冲缓存以及池化操作,结果缓存RB用于将脉冲累积与最大池化模块SA&MP的输出缓存输出。
脉冲缓存IB,权值缓存WB,结果缓存RB只是单纯的缓存,本实施例省略其详细介绍。systolic控制器systolic_ctrl与后处理机制控制器post_ctrl内部均实现计数器,但值一样,以数拍数的方式控制两大部分(systolic阵列1与后处理机制2)行为。
如图2和图3所示,处理单元阵列PEs包括以systolic阵列形式组织的多个处理单元PE,每一个处理单元PE的包括脉冲寄存器spike_reg、权重寄存器weight_reg、零值判断器、控制寄存器control_reg、累积寄存器accumulate_reg、乘法器、选择器MUX和输出寄存器res_reg,上一级处理单元PE的脉冲输入激励pre_spike输入脉冲寄存器spike_reg并直接作为脉冲spike输出、权重输入激励pre_ weight输入权重寄存器weight_reg并直接作为权重weight输出,零值判断器对脉冲寄存器spike_reg中的值进行判断并在脉冲寄存器spike_reg中的值为0时写控制寄存器control_reg,在控制寄存器control_reg为1时乘法器将权重输入激励pre_ weight、脉冲输入激励pre_spike进行乘法运算并输出至累积寄存器accumulate_reg,且选择器MUX在控制信号switch_in的控制下选择将上一级处理单元PE的输出pre_res或累积寄存器accumulate_reg中的值写入输出寄存器res_reg并通过输出寄存器res_reg输出。
本实施例中,处理单元PE有4个输入,3个输出。其中“pre_”标号所示输入分别表示来自前一处理单元PE的脉冲、权值以及结果;switch_in输入用于控制累加结果传出;三个输出用于向下一处理单元PE传递脉冲、权值以及结果。注意,由于脉冲为“0”或“1”序列,脉冲与权值的点积可以通过选择器与加法器实现。具体计算过程中,使用一个处理单元PE处理一组脉冲与权值的点积。由于需要多拍才能得到最终的累加值,所有点积中间结果均通过寄存器记录在处理单元内部。通过systolic控制器systolic_ctrl内部的计数器记录拍数。当处理单元完成累加拍数后,switch_in输入控制处理单元将累加结果传出。结果传出时需要按照一拍一个处理单元的方式传出,最终在最后一列的处理单元获得最终结果。处理单元PE以systolic阵列形式组织,同行共享脉冲数据流,同列共享权值数据流。
如图4所示,膜电位更新与脉冲产生模块MU&SG包括:
历史膜电位存储器RAM1,用于存储历史膜电位,且历史膜电位存储RAM每个块bank对应同一行中一个处理单元PE;
当前膜电位寄存器current_m_reg,用于缓存systolic阵列1输出的膜电位增量;
加法器,用于将systolic阵列1计算的膜电位增量与当前拍数对应的处理单元PE的历史膜电位进行累加得到加和值;
累加膜电位寄存器next_m_reg,用于存储加法器累加得到的加和值;
比较器CMP,用于将累加膜电位寄存器next_m_reg保存的加和值与膜电位阈值进行比较,若加和值大于膜电位阈值,则以膜电位复位值RESET_VALUE更新历史膜电位存储器RAM1中存储的历史膜电位,并完成脉冲点火,输出脉冲“1”;若加和值小于膜电位阈值,则以加和值更新历史膜电位存储器RAM1中存储的历史膜电位,输出脉冲“0”;
脉冲生成器spike_gen,用于根据比较器CMP的输出脉冲生成脉冲信号。
本实施例支持人工神经元模型中的集成与点火模型(IF模型)。该IF模型主要包括膜电位更新、脉冲产生两个功能过程。算法1对应膜电位更新过程,算法2对应脉冲产生过程。其中m表示膜电位,T表示膜电位阈值,Δm表示脉冲与权值的点积(即膜电位增量),SUM表示膜电位更新值与历史膜电位的加和值。
算法1:膜电位更新过程:
首先初始化(initialization),包括:膜电位m l j (初始为0),阈值T(初始为Thr),膜电位增量Δm l j (初始为0),复位膜电位R(初始为RESET_VALUE),下标j表示循环变量(初始为0),上标l表示神经元层层数。
然后逐个神经元层进行遍历,针对当前的第j次循环变量:(1)将上一层的膜电位m l j-1 加上膜电位增量Δm l j 得到膜电位累积量SUM(m l j );(2)针对膜电位累积量SUM(m l j )进行下述处理(working out the added result):如果膜电位累积量SUM(m l j )>=阈值T,则将本层的膜电位m l j-1 复位为复位膜电位R;如果膜电位累积量SUM(m l j )<阈值T,则将本层的膜电位m l j-1 更新为膜电位累积量SUM(m l j ),上一层的膜电位m l j-1 加上膜电位增量Δm l j 的结果;最终存储本层的膜电位m l j-1 (membrane potential)至内存RAM中的对应的bank中。
本实施例中,算法1以systolic阵列1计算得来的膜电位增量同对应的历史膜电位(j-1 cycle的膜电位)进行加和,得到加和值;若该加和值大于阈值,则以加和值更新当前历史膜电位;若该加和值小于阈值,则以复位膜电位更新当前历史膜电位;而后循环前进一步。
算法2:脉冲产生过程:
首先初始化(initialization),包括:脉冲spike l j (初始为0),阈值T(初始为Thr),下标j表示循环变量(初始为0),上标l表示神经元层层数;
然后针对来自算法1(Algorithm 1)的膜电位累积量SUM(m l j ):如果膜电位累积量SUM(m l j )>=阈值T,则产生脉冲“1”(spike l j <-1);如果膜电位累积量SUM(m l j )<阈值T,则产生脉冲“0”(spike l j <-0);最终将生成的脉冲传递给脉冲累积与最大池化模块SA&MP。
膜电位更新与脉冲产生模块MU&SG主要对相应的两个功能过程(膜电位更新、脉冲产生)进行支持。使用RAM对历史膜电位进行存储,每个块(bank)对应同一行中一个处理单元。将systolic阵列计算的膜电位增量与当前拍数对应的处理单元的历史膜电位进行累加,得到加和值。以此加和值与膜电位阈值进行比较。若加和值大于膜电位阈值,则以膜电位复位值(RESET_VALUE)更新历史膜电位,并完成脉冲点火,输出“1”;若加和值小于膜电位阈值,则以加和值更新历史膜电位,输出脉冲“0”。
如图5所示,脉冲累积与最大池化模块SA&MP包括:
脉冲信号存储器RAM2,用于按照指定的长度批量存储膜电位更新与脉冲产生模块MU&SG输出的脉冲信号;
最大池化层,用于将脉冲信号存储器RAM2中的各批脉冲信号进行逻辑或运算输出。
由于SNN本身理论设计,需要将同一像素点转换为多组“0”或“1”序列。在算法上,表示对同一神经元进行多次脉冲与权值的点积。若不进行同一神经元的脉冲累积直接进行池化操作,势必造成多次片外数据(同一神经元脉冲与权值)搬移。本实施例提出在片上对同一神经元的脉冲进行累积,而后批次进行池化操作。注意,由于平均池化(avg-pooling)操作涉及“0”“1”以外的数据表示,在SNN中无法实现,故只设计最大池化(max-pooling)操作。此处,最大池化操作本质为逻辑或运算,即范围内有脉冲则输出“1”,否则为“0”。
此外,本实施例还提供一种处理器,包括处理器本体,该处理器本体中设有本实施例前述的基于systolic阵列的SCNN推理加速装置。
此外,本实施例还提供一种计算机设备,该计算机设备中设有本实施例前述的基于systolic阵列的SCNN推理加速装置。
以上所述仅是本发明的优选实施方式,本发明的保护范围并不仅局限于上述实施例,凡属于本发明思路下的技术方案均属于本发明的保护范围。应当指出,对于本技术领域的普通技术人员来说,在不脱离本发明原理前提下的若干改进和润饰,这些改进和润饰也应视为本发明的保护范围。
Claims (6)
1.一种基于systolic阵列的SCNN推理加速装置,其特征在于,包括systolic阵列(1)和后处理单元(2),所述systolic阵列(1)包括:
脉冲缓存(IB),用于输入脉冲缓存;
权值缓存(WB),用于权值缓存;
systolic控制器(systolic_ctrl),用于控制systolic阵列行为;
处理单元阵列(PEs),用于脉冲与权值点积;
所述后处理单元(2)包括:
膜电位更新与脉冲产生模块(MU&SG),用于膜电位更新及脉冲产生;
脉冲累积与最大池化模块(SA&MP),用于同一神经元的脉冲缓存以及池化操作;
结果缓存(RB),用于结果脉冲缓存;
后处理机制控制器(post_ctrl),用于控制后处理机制行为;
所述systolic控制器(systolic_ctrl)的控制输出端分别与脉冲缓存(IB)、权值缓存(WB)以及处理单元阵列(PEs)相连,所述脉冲缓存(IB)、权值缓存(WB)的输出端分别与处理单元阵列(PEs)的输入端相连,所述处理单元阵列(PEs)的输出端与后处理单元(2)的输入端相连;所述膜电位更新与脉冲产生模块(MU&SG)、脉冲累积与最大池化模块(SA&MP)、结果缓存(RB)依次相连,且所述膜电位更新与脉冲产生模块(MU&SG)、脉冲累积与最大池化模块(SA&MP)、结果缓存(RB)的控制端均与后处理机制控制器(post_ctrl)相连,所述膜电位更新与脉冲产生模块(MU&SG)根据处理单元阵列(PEs)的输出结果进行膜电位更新及脉冲产生,所述脉冲累积与最大池化模块(SA&MP)对膜电位更新与脉冲产生模块(MU&SG)输出的同一神经元的脉冲缓存以及池化操作,所述结果缓存(RB)用于将脉冲累积与最大池化模块(SA&MP)的输出缓存输出。
2.根据权利要求1所述的基于systolic阵列的SCNN推理加速装置,其特征在于,所述处理单元阵列(PEs)包括以systolic阵列形式组织的多个处理单元(PE),每一个处理单元(PE)包括脉冲寄存器(spike_reg)、权重寄存器(weight_reg)、零值判断器、控制寄存器(control_reg)、累积寄存器(accumulate_reg)、乘法器、选择器(MUX)和输出寄存器(res_reg),上一级处理单元(PE)的脉冲输入激励(pre_spike)输入脉冲寄存器(spike_reg)并直接作为脉冲(spike)输出、权重输入激励(pre_ weight)输入权重寄存器(weight_reg)并直接作为权重(weight)输出,零值判断器对脉冲寄存器(spike_reg)中的值进行判断并在脉冲寄存器(spike_reg)中的值为0时写控制寄存器(control_reg),在控制寄存器(control_reg)为1时乘法器将权重输入激励(pre_ weight)、脉冲输入激励(pre_spike)进行乘法运算并输出至累积寄存器(accumulate_reg),且选择器(MUX)在控制信号(switch_in)的控制下选择将上一级处理单元(PE)的输出(pre_res)或累积寄存器(accumulate_reg)中的值写入输出寄存器(res_reg)并通过输出寄存器(res_reg)输出。
3.根据权利要求1所述的基于systolic阵列的SCNN推理加速装置,其特征在于,所述膜电位更新与脉冲产生模块(MU&SG)包括:
历史膜电位存储器(RAM1),用于存储历史膜电位,且历史膜电位存储(RAM)每个块(bank)对应同一行中一个处理单元(PE);
当前膜电位寄存器(current_m_reg),用于缓存systolic阵列(1)输出的膜电位增量;
加法器,用于将systolic阵列(1)计算的膜电位增量与当前拍数对应的处理单元(PE)的历史膜电位进行累加得到加和值;
累加膜电位寄存器(next_m_reg),用于存储加法器累加得到的加和值;
比较器(CMP),用于将累加膜电位寄存器(next_m_reg)保存的加和值与膜电位阈值进行比较,若加和值大于膜电位阈值,则以膜电位复位值(RESET_VALUE)更新历史膜电位存储器(RAM1)中存储的历史膜电位,并完成脉冲点火,输出脉冲“1”;若加和值小于膜电位阈值,则以加和值更新历史膜电位存储器(RAM1)中存储的历史膜电位,输出脉冲“0”;
脉冲生成器(spike_gen),用于根据比较器(CMP)的输出脉冲生成脉冲信号。
4.根据权利要求1所述的基于systolic阵列的SCNN推理加速装置,其特征在于,所述脉冲累积与最大池化模块(SA&MP)包括:
脉冲信号存储器(RAM2),用于按照指定的长度批量存储膜电位更新与脉冲产生模块(MU&SG)输出的脉冲信号;
最大池化层,用于将脉冲信号存储器(RAM2)中的各批脉冲信号进行逻辑或运算输出。
5.一种处理器,包括处理器本体,其特征在于,该处理器本体中设有权利要求1~4中任意一项所述的基于systolic阵列的SCNN推理加速装置。
6.一种计算机设备,其特征在于,该计算机设备中设有权利要求1~4中任意一项所述的基于systolic阵列的SCNN推理加速装置。
Priority Applications (1)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| CN201910500982.3A CN110348564B (zh) | 2019-06-11 | 2019-06-11 | 基于systolic阵列的SCNN推理加速装置、处理器及计算机设备 |
Applications Claiming Priority (1)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| CN201910500982.3A CN110348564B (zh) | 2019-06-11 | 2019-06-11 | 基于systolic阵列的SCNN推理加速装置、处理器及计算机设备 |
Publications (2)
| Publication Number | Publication Date |
|---|---|
| CN110348564A CN110348564A (zh) | 2019-10-18 |
| CN110348564B true CN110348564B (zh) | 2021-07-09 |
Family
ID=68181768
Family Applications (1)
| Application Number | Title | Priority Date | Filing Date |
|---|---|---|---|
| CN201910500982.3A Active CN110348564B (zh) | 2019-06-11 | 2019-06-11 | 基于systolic阵列的SCNN推理加速装置、处理器及计算机设备 |
Country Status (1)
| Country | Link |
|---|---|
| CN (1) | CN110348564B (zh) |
Families Citing this family (5)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| CN113095503B (zh) * | 2020-01-09 | 2024-05-03 | 北京君正集成电路股份有限公司 | 一种实现检测模型高效的系统 |
| CN111860778B (zh) * | 2020-07-08 | 2025-05-13 | 北京灵汐科技有限公司 | 一种全加卷积方法和装置 |
| CN113269317B (zh) * | 2021-04-14 | 2024-05-31 | 南京大学 | 一种脉冲神经网络计算阵列 |
| CN113554162B (zh) * | 2021-07-23 | 2022-12-20 | 上海新氦类脑智能科技有限公司 | 轴突输入扩展方法、装置、设备和存储介质 |
| CN115481739B (zh) * | 2022-07-28 | 2026-03-03 | 清华大学 | 一种基于预测稀疏性实现cnn推理无损加速方法及系统 |
Family Cites Families (7)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| US11501130B2 (en) * | 2016-09-09 | 2022-11-15 | SK Hynix Inc. | Neural network hardware accelerator architectures and operating method thereof |
| US9646243B1 (en) * | 2016-09-12 | 2017-05-09 | International Business Machines Corporation | Convolutional neural networks using resistive processing unit array |
| CN107578098B (zh) * | 2017-09-01 | 2020-10-30 | 中国科学院计算技术研究所 | 基于脉动阵列的神经网络处理器 |
| CN107918794A (zh) * | 2017-11-15 | 2018-04-17 | 中国科学院计算技术研究所 | 基于计算阵列的神经网络处理器 |
| CN108182471B (zh) * | 2018-01-24 | 2022-02-15 | 上海岳芯电子科技有限公司 | 一种卷积神经网络推理加速器及方法 |
| CN109032781A (zh) * | 2018-07-13 | 2018-12-18 | 重庆邮电大学 | 一种卷积神经网络算法的fpga并行系统 |
| CN109284824B (zh) * | 2018-09-04 | 2021-07-23 | 复旦大学 | 一种基于可重构技术的用于加速卷积和池化运算的装置 |
-
2019
- 2019-06-11 CN CN201910500982.3A patent/CN110348564B/zh active Active
Also Published As
| Publication number | Publication date |
|---|---|
| CN110348564A (zh) | 2019-10-18 |
Similar Documents
| Publication | Publication Date | Title |
|---|---|---|
| Li et al. | A free lunch from ANN: Towards efficient, accurate spiking neural networks calibration | |
| CN110348564A (zh) | 基于systolic阵列的SCNN推理加速装置、处理器及计算机设备 | |
| JP6708044B2 (ja) | 画像認識装置、画像認識プログラム、画像認識方法および認識装置 | |
| CN114330644B (zh) | 一种基于结构搜索和通道剪枝的神经网络模型压缩方法 | |
| KR102610842B1 (ko) | 뉴럴 네트워크에서의 프로세싱 엘리먼트 및 그 동작 방법 | |
| CN107609641A (zh) | 稀疏神经网络架构及其实现方法 | |
| CN117272040A (zh) | 一种基于元学习框架的小样本时间序列预测方法 | |
| CN109460813B (zh) | 卷积神经网络计算的加速方法、装置、设备及存储介质 | |
| CN105981055A (zh) | 神经网络对当前计算资源的自适应 | |
| CN109032781A (zh) | 一种卷积神经网络算法的fpga并行系统 | |
| CN111626403B (zh) | 一种基于cpu-fpga内存共享的卷积神经网络加速器 | |
| CN108710770A (zh) | 一种面向多脉冲神经网络监督学习的精确突触调整方法 | |
| CN109359735B (zh) | 深度神经网络硬件加速的数据输入装置与方法 | |
| CN113313252A (zh) | 一种基于脉动阵列的深度可分离卷积实现方法 | |
| CN106845632B (zh) | 脉冲神经网络信息转换为人工神经网络信息的方法和系统 | |
| CN112101517A (zh) | 基于分段线性脉冲神经元网络的fpga实现方法 | |
| CN108960414A (zh) | 一种基于深度学习加速器实现单广播多运算的方法 | |
| CN108304925B (zh) | 一种池化计算装置及方法 | |
| Guo et al. | A high-efficiency FPGA-based accelerator for binarized neural network | |
| CN108810551A (zh) | 一种视频帧预测方法、终端及计算机存储介质 | |
| KR102788433B1 (ko) | 심층 신경망 구조 학습 및 경량화 방법 | |
| CN119378618B (zh) | 一种基于近似计算的可在线学习神经形态处理器 | |
| CN109190757A (zh) | 任务处理方法、装置、设备及计算机可读存储介质 | |
| CN113065648A (zh) | 一种低硬件开销的分段线性函数的硬件实现方法 | |
| CN120046660A (zh) | 一种基于时空域脉冲卷积编码的脉冲神经网络加速器 |
Legal Events
| Date | Code | Title | Description |
|---|---|---|---|
| PB01 | Publication | ||
| PB01 | Publication | ||
| SE01 | Entry into force of request for substantive examination | ||
| SE01 | Entry into force of request for substantive examination | ||
| GR01 | Patent grant | ||
| GR01 | Patent grant |