CN1093290C - 利用部分特征空间上投影特征向量的模式识别装置和方法 - Google Patents
利用部分特征空间上投影特征向量的模式识别装置和方法 Download PDFInfo
- Publication number
- CN1093290C CN1093290C CN97103439A CN97103439A CN1093290C CN 1093290 C CN1093290 C CN 1093290C CN 97103439 A CN97103439 A CN 97103439A CN 97103439 A CN97103439 A CN 97103439A CN 1093290 C CN1093290 C CN 1093290C
- Authority
- CN
- China
- Prior art keywords
- proper vector
- dictionary
- input
- feature
- vector
- Prior art date
- Legal status (The legal status is an assumption and is not a legal conclusion. Google has not performed a legal analysis and makes no representation as to the accuracy of the status listed.)
- Expired - Fee Related
Links
Images




Classifications
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F18/00—Pattern recognition
- G06F18/20—Analysing
- G06F18/21—Design or setup of recognition systems or techniques; Extraction of features in feature space; Blind source separation
- G06F18/213—Feature extraction, e.g. by transforming the feature space; Summarisation; Mappings, e.g. subspace methods
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F18/00—Pattern recognition
- G06F18/20—Analysing
- G06F18/21—Design or setup of recognition systems or techniques; Extraction of features in feature space; Blind source separation
- G06F18/213—Feature extraction, e.g. by transforming the feature space; Summarisation; Mappings, e.g. subspace methods
- G06F18/2132—Feature extraction, e.g. by transforming the feature space; Summarisation; Mappings, e.g. subspace methods based on discrimination criteria, e.g. discriminant analysis
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F17/00—Digital computing or data processing equipment or methods, specially adapted for specific functions
- G06F17/10—Complex mathematical operations
- G06F17/16—Matrix or vector computation, e.g. matrix-matrix or matrix-vector multiplication, matrix factorization
Landscapes
- Engineering & Computer Science (AREA)
- Data Mining & Analysis (AREA)
- Theoretical Computer Science (AREA)
- Physics & Mathematics (AREA)
- Computer Vision & Pattern Recognition (AREA)
- General Physics & Mathematics (AREA)
- General Engineering & Computer Science (AREA)
- Bioinformatics & Computational Biology (AREA)
- Evolutionary Computation (AREA)
- Evolutionary Biology (AREA)
- Bioinformatics & Cheminformatics (AREA)
- Artificial Intelligence (AREA)
- Life Sciences & Earth Sciences (AREA)
- Mathematical Physics (AREA)
- Mathematical Optimization (AREA)
- Mathematical Analysis (AREA)
- Computational Mathematics (AREA)
- Pure & Applied Mathematics (AREA)
- Computing Systems (AREA)
- Algebra (AREA)
- Databases & Information Systems (AREA)
- Software Systems (AREA)
- Character Discrimination (AREA)
- Image Analysis (AREA)
Abstract
特征提取装置从输入字符模式中提取输入特征向量。学习装置计算并存储原始特征空间的部分本征空间的规范正交基。学习装置计算并存储对应每个目标字符模式在部分本征空间中规定的每个字典选择特征向量。特征选择装置利用上述的规范正交基,通过将由特征提取装置所提取的输入选择特征向量投射在部分本征空间上来计算输入选择特征向量。校对装置校对上述的输入选择特征向量,估算该输入字符模式的类型。
Description
本发明涉及识别字符等的模式的技术,通过有效地减少指示模式的特征向量的维数来选择特征。
最近,文档识别技术,即采用电子技术手段汇存文档,有效地执行办公室的工作流,并且当需要时对数据编码,这样的一种技术正被认真地提出需求。具体来说,字符识别技术,即文档识别技术的一个方面,对于编码字符串信息来说是十分重要的。在这种技术中,要求采用按所需的识别精度快速估计字符类型的方法,使这种字符识别技术能在各领域中投入实际应用。利用统计技术减少输入字符的字符向量的维数来选择特征的方法对于减少用校对识别字典进行校对的计算量是很有效的。因此,当生产实用的文档识别装置时,使用特征选择法的字符识别技术将发挥重要的作用。对于生产用于识别非字符的各种模式的设备来说,这也是一种十分重要的技术。
下面首先介绍字符识别的一般概念,以字符做为模式的例子。
首先,当某个字符模式被输入时,其尺寸将被规范化。
接着,将规范化得到的矩形字符区域划分为形成该矩形字符区域的多个块。例如,一个矩形字符区域可相等地划分为3行3列的9块或者6行6列的36个块。
接着,存在于每块中的指示字符轮廓的象素(轮廓象素)被提取。对于每个象素,确定包含象素的轮廓的方向。轮廓象素为直接对应某个字符区域的象素,或者也可以通过处理细线处理中的字符区域得到。上述方向可以是8个方向(上、下、左、右和4个对角线)中的一个,或者是进一步细化的36个方向中的一个。接着,对每个块中的每个方向得到轮廓象素的数目。结果,对每个块可得到某个部分特征向量,其维数等于方向的数目,其元素的值对应在该元素的方向上的轮廓象素的数目。对于每个输入字符模式,可以得到包括对应被包含在对应的矩形字符区域中的每个块的每个部分特征向量的所有元素的特征向量。
如果对于每个这样得到的字符模式的特征向量被分类为目标字符的类型,则对每种字符类型形成一个群集(聚类),即对在所具有的维数对应该特征向量的元素数目的多维空间中相同类字符类型的字符模式的特征向量进行分组。基于这样的特征,对学习字符模式的特征向量进行分类,并且从被包含在该群集中的特征向量中计算出表示对应每个结果群集的字符类型的平均特征向量。平均特征向量是通过计算特征向量的每个元素的平均值得到的。每个字符类型的平均特征向量被存在字典中。
当实际识别某个字符时,输入字符模式的特向向量被计算出来,然后再计算特征向量和进入字典的每个平均特征向量之间的距离。这样,对应指示最短距离的平均特征向量的字符类型被估计为该输入字符的类型。距离可以是欧几里德距离或市街区距离。
当对整个特征空间计算距离时,需要对应该特征空间维数的时间长度。高速执行这样一种计算任务的一种众所周知的方法是在减少特征空间的维数(例如,从384维减少到64维)后再计算距离。在特征空间中减少维数的方法被称为特征选择。用于特征选择的一种具体方法可以是典型确认分析或主要部分分析。经实验已确认,通过特征选择,仅对原始维数的1/8,识别率几乎没有什么降低。反之,在特征选择中,通过减少不需要的噪声特征向量,也能够提高识别率。
下面首先结合图1所示的配置介绍通过典型确认分析进行特征选择的识别字符的常规技术。
如上所述,特征提取装置101从被包含在9个类型的每个字符类型之(1≤i≤g)中的ni个字符模式的示例中提取由下面等式(1)所代表的ni组学习特征向量
x j (i)(1≤j≤ni)。上标T表示矩阵(或向量)的转置。 下标K表示特征向量在范围1≤K≤N内的元素数目。在下面的描述中,带下划线的符号表示向量的数量,具有元素个数而没有如上所述的下划线的符号则表示向量的一个元素的值。
学习装置102计算由下面等式(2)表示的平均特征向量
m (i),对应和字符类型之相应的上述特征向量
X j (i)(1≤j≤ni)中的g个类型中的每个字行类型i(1≤i≤g)。
m (i)=(mk (i))=(m1 (i),…,mN (i))T ……(2)
学习装置102从每个字符类型i的ni个示例和上述的平均特征向量m (i)中为所有的字符类型计算由下式(3)表示的平均特征向量(整体平均特征向量)
m。
m=(mk)=(m1,…,mN)T ……(3)
接着,学习装置102计算字符类型之间的方差矩阵Sb以及字符类型内部的方差矩阵SW,根据每个字符类型i的特征向量
X j (i),示例的个数ni,上述的平均特征向量
m (i),以及整体的平均特征向量
m,如下式(4)至(7)所示。下标P和q表示在范围1≤p,q≤N中的特征向量的元素个数。
Sb=(bpq) ……(4)
SW=(Wpq) ……(6)
而且,学习装置102利用上述的字符类型之间的方差矩阵Sb和字符类型内部的方差矩阵SW来满足下面的等式(8),并计算N组特征向量φ k(维数为N且其长度为1)和一组特征根λk(1≤K≤N)。
Sb φ K=λKSWφK (1≤K≤N)
λ1≥λ2≥…≥λN ……(8)
接着,学习装置102从对应被计算的N个特征向量
φ K的特征根λK中选取较大的M(M<N)个特征向量
φ h(1≤h≤M),并将其存放在特征向量存储装置103中。
学习装置102通过计算上述M个特征向量
φ h(1≤h≤M)与每个字符类型i的N维平均特征向量
m (i)的内积,为每个字符类型之计算M维的平均选择特征向量
m (i),由下式(9)所示。接着,将其存放在识别字典装置104中。
m (i)’=(mh (i)’)
=(
φ 1 T m (i),
φ 2 T m (i),…,
φMT m (i)) ……(9)
这里的下标h表示在范围1≤h≤M中选择特征向量的元素个数。这样,通过对被存放在字典中的每个字符类型的平均特征向量,将N维减少为M维,执行特征选择处理。这种特征选择处理等同于将一个N维的平均特征向量投射在用M个特征向量
φ h定义的M个座标轴上的处理过程,,因此,字符类型之间的方差可以被扩大,而字符类型内部的方差可以被减少,即,使得不同类型的字符可以被区分,而相同类型的字符在经过由M个特征向量
φ h所规定的特征选择之后,能被收集在一个空间中。即,在典型确认分析中,对应所有目标字符类型的原始特征空间中的所有群集都被转换为新的空间。
当实际识别某个字符时,特征提取装置101从其字符类型未知的输入字符模式中提取由下式(10)所表示的N维特征向量
X。
X=(XK)=(X1,…,XN)T ……(10)
这里的下标K指示在特征选择前在1≤K≤N的范围内特征向量的元素个数。
特征选择装置105计算M维选择特征向量
Y,通过计算M个特征向量
φ h(1≤h≤M)以及存放在特征向量存储装置103中的N维特征向量
X的内积,由下式(11)表示。
y=(yh)=(φ1 T X,φ2 T X,…φM TX) ……(11)
这样,通过对输入的特征向量将N维减少为M维来执行特征选择处理。
最后,校对装置106为每个字型类型i计算出M维选择特征向量
Y和存放在识别字典104中的每个平均选择特征向量
m (i)之间的每个欧几里德距离d(i),利用下面的等式(12)。
接着,校对装置106输出对应具有最短距离d(i)的平均选择特征向量m (i)的字符类型i做为被估计的字符类型。
根据上述的利用典型确认分析做为特征选择的常规技术,用来计算距离的元素个数被从N项减少为M项。因此,通过近似地将M设置为N的1/8,就能大大地提高识别速度。
然而,根据利用典型确认分析做为特征选择的常规技术,不能保证M个特征向量
φ h(1≤h≤M)互相正交。因此,如果新的特征空间被定义在这些特征向量
φ h的基础上,目标字符的特征向量X被投影在对应上述M个特征向量
φ h的M个座标轴上,并且如果在投影结果,即选择特征向量
Y和每个字符类型i的平均选择特征向量
m (i)之间的欧几里德距离被计算时,则该距离可能会和在原始的N维特征空间中的距离大不一样。
为了容易理解,假定特征选择前的维数为3,而特征选择后的维数为2,如图2所示。
在特征选择前3维特征空间中特征向量
X 2和特征向量
X 1之间的欧几里德距离dorg由下式(13)得到。
dorg=||
x 2-
x 1||
{(
a 1 T x 2-
a 1 T x 1)2+(
a 2 T x 2-
a 2 T x 1)2+(
a 3 T x 2-
a 3 T x 1)2}1/2 ……(13)
而特征选择后在2维特征空间中的特征向量
X 2和特征向量
X 1之间的近似的欧几里德距离dnew由下式(14)得到。
dnew={(
φ 1 T x 2-
φ 1 T x 1)2+(
φ 2 T x 2-
φ 2 T x 1)2}1/2 ……(14)
在上面的等式(14)中,右手边上每一项中的物理量由图2所示。如图2所示,等式(14)并不基于勾股定理。在特征选择后的2维特征空间中的欧几里德距离dnew完全不同于特征选择前3维特征空间中的欧几里德距离dorg。
根据使用典型确认分析做为特征选择的常规技术,特征向量
X的投影和由典型确认分析法得到的M个特征向量
φ h(1≤h≤M)的组合并不能看作原始特征空间的部分特征空间上的特征向量
X的投影,因此在识别字符中将导致精度的降低。所以,实现具有实用识别精度的字符识别装置是很困难的。
利用主要部分分析法,即特征选择的另一种方法,需要对每种字符类型计算出一组能使每个字符类型互相区分的主要部分向量(每种字符类型对应一组主要部分向量)。使用这种分析方法,不是为了确定多类字符而对字符分类,而是当特征空间相邻区域中存在类似的字符类型时,通过将某个目标字符的特征向量投影到对应每种字符类型的主要部分向量以获得正确的识别结果。即,在主要部分分析法中,为每个字符类型生成指定某个主要部分向量做为座标轴的新的独立空间。因为在目标字符的特征向量被投影在每个字符类型的主要部分向量上之后才计算目标字符和每个字符类型之间的距离,因此,当涉及大量的字符类型时,就需要大量的计算。所以,该分析方法主要用于,例如,确定诸如数字字符、少量类型的字型等这样的字符。
特征向量距离的定义涉及Mahalanobis距离和贝叶斯(Bayes)距离。当某种识别装置利用这些距离设计时,在做了这样的限制后再计算距离,即,用来计算距离的座标轴应互相正交。因此,典型确认分析法中的问题不会出现在该方法中,但存在的问题是:计算被复杂化且需要进行大量的计算。
上述的问题不仅涉及字符识别装置,而且对于通过特征向量识别其它的各种模式(例如图像模式、声音模式等)的技术也同样存在。
本发明是基于上述的背景而被开发的,目的是利用某种特征选择方法减少特征向量的维数,实现能在高速执行识别过程的同时保持识别精度的一种模式识别装置,以便识别各种模式。
本发明的第一方面是基于一种模式识别装置,该装置利用代表例如某个输入字符模式等一类的输入模式的特征的输入特征向量来识别某个输入模式。
首先,本发明包括输入特征向量提取装置,用于提取代表输入模式的特征的输入特征向量。
还包括规范正交基存储装置,用于保存原始特征空间的部分特征空间的规范正交基。
还包括识别字典装置,存放对应一个或多个目标模式在部分特征空间中被规定的每个字典选择特征向量。
进一步包括特征选择装置,利用被存放在规范正交基存储装置中的规范正交基,计算被投影在由输入特征向量提取装置所提取的输入特征向量的部分特征空间上的输入选择特征问量。
还包括校对装置,通过校对由字符选择装置计算出来的输入选择特征向量和存放在识别字典装置中的每个字典选择特征向量,识别对应该输入选择特征向量的输入模式的类型。这种校对是通过例如计算输入选择特征向量和每个字典选择特征向量之间的距离并互相比较所得到的距离的值来实现的。距离可以是,例如,基于欧几里德距离,市街区距离或棋盘距离等的距离。
本发明的第二方面是基于模式学习装置,用于计算规范正交基和由根据本发明第一方面的模式识别装置得到的每个字典选择特征向量。
首先,本发明包括学习特征向量提取装置,用于提取代表学习模式的特征的每个学习特征向量。
还包括规范正交基计算装置,根据由学习特征向量提取装置所提取的学习特征向量计算部分特征空间的规范正交基。
还包括字典特征向量计算装置,用于计算在对应基于由学习特征向量提取装置所提取的学习特征向量的每个目标模式的原始特征空间中指定的每个字典特征向量。
进一步包括字典选择特征向量计算装置,利用规范正交基计算装置所计算的规范正交基计算被投影在由字典特征向量计算装置所计算出来的每个字典特征向量的部分特征空间上的每个字典选择特征向量。
根据本发明第一或第二方面的配置,可以计算正交基,例如,在学习模式的学习特征向量上执行典型确认分析之后,从具有最大特征根的一个开始,顺序计算少于原始特征空间的维数的预定数目的特征向量,并且,从具有最大特征根的一个开始,顺序地规范正交化预定数目的特征向量。
根据本发明的第一或第二方面的配置,将输入特征向量或字典特征向量投影在部分特征空间上得到的输入选择特征向量或字典选择特征向量可以被配置得似乎是将输入特征向量或字典特征一投射在正交基向量上得到的一样。此外,做为投影结果得到的输入选择特征向量或每个字典选择特征向量可以被配置得似乎是做为计算输入特征向量或字典特征向量与每个正交基向量的内积后所得到的结果。
根据上述的本发明第一或第二方面,字典选择特征向量可以被配置得似乎基于做为每类目标模式的特征向量的平均向量得到的平均特征向量。
本发明可以被配置到具有根据上述的本发明第一或第二方面的功能。
本发明也可以被配置成为计算机可读的存储介值,被用来指导计算机执行根据上述的本发明第一或第二方面的功能。
正如上述配置所指出的那样,本发明通过减少在常规技术中那样的距离计算中的元素个数来实现高速识别。而且,本发明的唯一特征是通过将特征向量投影在原始特征空间的部分特征空间上来存储距离的,由此实现具有实用识别精度的字符识别装置。
在这种情况下,在用常规的典型确认分析法等方法计算特征向量之后,利用规范正交化的一个简单递归方程计算正交基向量,就能用简单的处理计算得到正交基。
可以预料在字符类型内部方差可以被最小化而字符类型之间的方差可以被最大化的典型确认分析法中,通过规范正交化上述的特征向量,其特征可能会在某种程度上受到损失。然而,从实验中知道,通过提高由正交化距离计算的规范化得到的识别率,就足以补偿识别率的这种损失,由此确切地显示出本发明的意义。
对于一般熟悉本技术的人来说,结合附图和本发明的最佳实施例说明,就能很容易地理解本发明的其他目的和特征。
图1表示常规技术的配置;
图2表示常规技术的问题;
图3表示根据该最佳实施例的配置;
图4表示本发明的最佳实施例的原理;
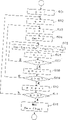
图5是一个流程图,表示在本发明最佳实施例中学习过程的操作;
图6是一个流程图,表示计算字符类型之间方差矩阵Sb的过程;
图7是一个流程图,表示计算字符类型内部方差矩阵SW的过程;
图8是一个流程图,表示计算正交基向量的过程;以及
图9表示计算
ψ h的过程。
图10表示实施最佳实施例的系统结构。
结合附图顺序地介绍本发明的最佳实施例。
根据本发明的最佳实施例,在根据典型确认分析法从具有最大特征值的一个开始顺序计算M个特征向量
φ h(1≤h≤M)之后,再利用施密特(schmidt)规范正交化方法规范正交化特征向量
φ h计算M个规范正交基向量
ψ h(1≤h≤M)。接着,通过将N维特征向量投射在上述的M个规范正交基向量
ψ h上来计算选择特征向量。利用选择特征向量执行识别处理,并通过特征选择方法减少特征一的维数。因此,根据本发明,既能高速执行识别处理,又能保持高识别精度。
为了便于理解,假定在特征选择前的维数为3,而特征选择后的维数为2,如图4所示。
首先,在根据典型确认分析法从具有最大特征值的一个开始顺序计算两个特征向量
φ 1和
φ 2之后,再利用施密特规范正交化方法规范正交化特征向量来计算两个规范正交基向量
ψ 1(=
φ 1)和
ψ 2。
在特征选择之前,在3维特征空间中从特征向量
X 2到特征向量
X 1的欧几里德距离dorg由上述的等式(13)得到。
特征选择后,在2维特征空间中从特征向量
X 2到特征向量
X 1的近似欧几里德距离dnew由下式(15)得到。
dnew={(
φ 1 T x 2-
φ 1 T x 1)2+(
φ 2 T x 2-
φ 2 T x 1)2}1/2 ……(15)
在上述的等式(15)中,右手边每一项的物理量如图4所示。正如图4中所清楚表示的那样,等式(15)基于勾股定理,而且特征选择后的在2维特征空间中的欧几里德距离dnew近似于特征选择前在3维特征空间中的欧几里德距离dorg。
上述的原理适用于维数很大的情况。在下面实际介绍的最佳实施例中,在正交基向量
ψ h上特征向量
X的每个投影的组合等于在原始特征空间的部分特征空间上特征向量
X的投影。结果,即使在特征选择之后,也能保证足够的字符识别精度。
图3表示根据上述原理的最佳实施例的配置。
首先,在学习过程中,特征提取装置301和学习装置302执行图5中的流程图所表示的学习过程。
特征提取装置301在步503中从被包含在每个字符类型之中的ni个字符模式的示例中提取由上述等式(1)指示的ni组学习特征向量
X j (i)(1≤j≤ni)。在示例数目字在步502被置为1之后,由步504对示例数目字增1,重复执行步503中的处理直到在步505中判定示例数字已经超出了字符类型i的示例数ni。因此,字符类型i的ni组学习特征向量X j (i)被提取。
接着,学习装置302利用上述步502至505中得到的对应字符类型i的ni组学习特征向量
X j (i),通过对向量的每个元素的位置计算向量元素的平均值,对一个字符类型i计算由对应字符类型i的等式(2)所代表的平均特征向量
m (i)。
在将字符类型数i在步501置为1之后,由步507对字符类型数i增1,执行步502至步506中的处理,直到在步508中判定字符类型数i已经超过了字符类型的总数g。因此,对字符类型i的g次变化(1≤i≤g),在ni组学习特征向量
X j (i)和一个平均特征向量
m (i)上顺序执行计算处理。
接着,在步509中,学习装置302从每个字型类型i的ni个示例中计算出由上述等式(3)所示的所有字型类型的平均特征向量(总体平均特征向量)
m的每个元素mk,上述平均特征向量
m (i)的每个元素
m k (i)由下式(16)所示
在步510中,学习装置302根据每个字符类型i的特征向量
X j (i)、示例的个数ni、平均特征向量
m (i)以及总体平均特征向量
m计算字符类型之间的方差矩阵Sb。图6的流程图表示这一过程的细节。
在第一元素个数P在步601被设置为1之后,在步610中增1直到在步611中确定元素个数P已经超出个数N。在第二元素数q在步602被置为1之后,在步608中被增1,直到在步609中被确定该元素数q已经超出个数N。在步603至步607中对由这些控制循环确定的每组第一元素数P和第二元素数q。通过上述的等式(5)执行计算。
即,在步604中,被包含在由第一元素数P和第二元素数q确定的字符类型之间方差矩阵Sb中的元素值bpq被清零,并且在字符类型数i在步603中被置为1后,在步606中增1直到在步607中确定字符类型数i已经超过了字符类型的总数g。接着,在步605中,利用下式(17)重复执行计算得到元素值bpq。
bpq=bpq+ni(mp (i)-mp)(mq (i)-mq) ……(17)
被包含在字符类型之间的方差矩阵Sb中的所有元素值bpq都是由第一元素数P和第二元素数q的组合确定的,利用步601、602和608至611中的控制循环,在步603至607中重复执行这些处理过程。
接着,在步612中,字符类型之间的方差矩阵Sb被输出,做为由上述等式(4)所计算的一组所有的元素值bpq。
在步510中,学习装置302得到字符类型之间的方差矩阵Sb,如图5所示,并且在步511中,根据特征向量
X j (i)、示例的个数ni以及平均特征向量
m (i)计算字符类型内部的方差矩阵SW。图7为这些处理过程细节的流程图。
在步701中,第一元素数P被置为1,接着在步713中增1直到在步714中确定第一元素数P已经超出了个数N。第二元素数q在步702中被置为1并在步711中增1直到在步712中被判定第二元素数q已经超过个数N。在步703至710中,对由控制循环确定的每组第一元素数P和第二元素数q,由上述的等式(7)执行计算过程。
即,在步705中,被包含在由第一元素数P和第二元素数q确定的字符类型内部的方差矩阵Sw中的元素值Wpa被清零,并且在字符类型数i在步703被置为1之后,在步709中对字符类型数i增1,直到在步710中确认字符类型数i已经超过字符类型的总数g。接着,重复执行步706至708中的循环。而且在该循环中,示例数字在步704中被置为1,并且在步707中增1直到在步708中被确认示例数字已经超出示例的总数ni。接着,在步706中,由下式(18)重复执行计算过程得到元素值Wpq。
wpq=wpq+(xjp (i)-mp (i))(xjq (i)-mq (i) ……(18)
所有被包含在字符类型内部的方差矩阵SW中的元素值Wpq都是由第一元素数P和第二元素数q的组合确定的,利用步701、702以及711至714中的控制循环,在步703至710中重复执行这些处理。
接着,在步715中,字符类型内部的方差矩阵SW被输出做为由上述等式(6)计算出来的一组所有的元素值Wpq。
学习装置302利用图5所示的步510中计算的字符类型之间的方差矩阵Sb,以及在步511中计算的字符类型内部的方差矩阵SW,在步512中满足上述的等式(8),然后对N组特征向量
φ k和特征值λk(1≤k≤N)执行计算过程。由于该计算过程是众所周知的,因此在这里忽略了详细的解释。学习装置302在步512中从N个字符向量
φ k中选择具有较大的特征值λk的M(M<N)个特征向量
φ h(1≤h≤M)。
在步513中,学习装置302通过规范正交化上述的特征向量
φ h(1≤h≤M)计算出M个规范正交基向量
ψ h(1≤h≤M)。所用的规范正交方法可以是施密特规范正交化方法。在这种规范正交化中,从具有较大的特征值
λ h的特征向量
φ h开始顺序地计算M个规范正交基向量
ψ h(1≤h≤M),通过执行由下面的等式(19)和(20)所代表的递归方程以及由式(21)表示的规范化方程实现。
φ 1=
φ 1 ……(19)
φ h=th/‖th‖ ……(21)
这里,如图9和等式(20)所示的那样,向量
t h和基于具有大于当前被处理的特征向量
φ h特征值的特征向量
φ i(1≤i≤h-1)得到的所有规范正交基向量
ψ i(1≤i≤h-1)正交,并且顺序地对应从具有较大的特征值的特征向量开始的特征向量
φ h。接着,利用式(21)将向量
t h的长度规范化为1,计算对应特征向量
φ h的规范正交基向量
ψ h。
图8为图5中所示的步513中的详细处理过程的流程图。
首先,学习装置302在步801中利用方程(19)执行计算过程。
学习装置302在步802中置维数h为2,接着重复执行步803中对应等式(20)的计算过程和步804中对应等式(21)的计算过程,维数h增1直到在步806中判定维数h已经超过维数M。
在根据本实施例如上所述利用常规的典型确认分析法计算特征向量φ h之后,利用简单的递推方程就能计算规范正交基向量
ψ h。
在图5所示的步513中,学习装置302将上述计算得到的M个规范正交基向量
ψ h(1≤h≤M)存储在部分本征空间的规范正交基存储装置303中。
接着,在图5所示的步514中,学习装置302计算每个字符类型i的M维平均选择特征向量
m (i),通过对每个字符类型i用下面的等式(22)计算上述的M个规范正交基向量
ψ h(1≤h≤M)和在步506中得到的N维平均特征向量
m (i)的内积。接着,将结果存在识别字典装置304中。
m (i)′=(mh (i)′)
=(
ψ 1 T m (i),
ψ 2 (i) m (i),…,
ψ M T m (i)) ……(22)
这里的下标h表示在1≤h≤M的范围内选择特征向量的元素个数。因此,特征选择处理过程,即,将形成字典一部分的每个字符类型的平均特征向量的维数从N维减少为M维的处理过程被执行。根据本实施例的特征选择处理过程相当于将N维平均特征向量投射在由M个规范正交基向量ψh指定的M个座标轴上,因此字符类型之间的方差可以被增加,而字符类型内部的方差则可以被减少,正如在常规的技术中一样。由于M个规范正交基向量
ψ h互相正交,因此,上述的投影过程等价于将N维平均特征向量投射在原始空间的部分特征空间上。结果,在原始特征空间中的向量之间的距离对应在由M个规范正交基向量
ψ h指定的部分特征空间中的向量之间的距离,如图4所示。
如上所述,学习装置302执行根据图5所示流程图的学习过程。
当实际识别某个字符时,特征提取装置301从具有未知字符类型的输入字符模式中提取由上述等式(10)所指示的N维特征向量
X。
接着,特征选择装置305通过获取存放在部分特征空间中的规范正交基存储装置303中的M个规范正交基向量
ψ h(1≤h≤M)和N维特征向量
X的内积来计算M维选择特征向量
Z,如下式(23)所示。
z=(zh)=(
ψ 1 T x,
ψ 2 T x,…,
ψ M T x)T ……(23)
接着,输入特征向量被投射(特征选择)在M维部分特征空间上。
最后,校对装置306对每个字符类型之用下式(24)计算(例如)M维选择特征向量
Z和存放在识别字典装置304中的平均选择特征向量m (i)之间的欧几里德距离。
校对装置306输出对应具有最短距离d(i)的平均选择特征向量
m (i)’的字符类型i,做为对应输入字符模式的估算字符类型。
根据上述的最佳实施例,识别过程可以被大大加速,因为距离计算中元素的个数从N项被减少到M项,正如在常规的技术中一样。而且,本发明通过将特征向量投射到原始特征空间的部分特征空间上来存储距离的值,由此实现具有实用识别精度的字符识别装置。
可以预料在字符类型内部的方差被最小化而字符类型之间的方差被最大化的典型确认分析法中,其特征将稍微受到损失。从实验结果看,识别率的这种降低可通过正交化的距离计算规范化提高识别率来得到更多的补偿。因此,本发明的有效性已被实践证明。
根据上述的最佳实施例,欧几里德距离被用作向量之间的距离。然而,本发明并不局限于这种应用,基于欧几里德距离的其他距离,市于区距离、棋盘距离等,也可以被使用。向量
X 1和向量
X 2之间的市街区距离d是由下面的等式定义的。然而,
X 1h和
X 2h分别为向量
X 1和
X 2的元素。距离的计算是沿着座标轴的垂直或水平的向进行的。
而向量
X 1和
X 2之间的棋盘距离d是由下式定义的。沿着座标轴的垂直、水平或对角线方向中的一种方向计算出最短的距离。
本发明并不局限于在上述最佳实施例中所介绍的字符识别装置,也可以被应用到各种模式识别装置中。
此外,本发明也包括例如软盘、CD-ROM(只读光盘),光盘和可装卸式硬盘等一类的存储介质,存放计算机程序以实现上述的模式识别功能。
图10表示实现上述最佳实施例的系统结构。
扫描仪装置1001、中央处理器(CPU)1003、随机访问存储器(RAM)1004、硬盘驱动器1005以及CD-ROM驱动器1006被连接到公共总线1001上。
CD-ROM介质存放计算机程序以实现上述的模式识别功能。该程序通过CD-ROM驱动器1006和公共总线1001被装入到硬盘驱动器1005上。
CPU1003将程序从硬盘驱动器1005中装入随机存取存储器1004并执行这些程序。结果,对通过扫描仪装置1002读入的字符模式执行上述的模式识别过程。
Claims (14)
1.利用代表输入模式特征的特征向量识别某个输入模式的模式识别装置,包括:
一个输入特征向量提取单元,用于提取代表该输入模式的特征的输入特征向量;
一个规范正交基存储单元,用于存放原始特征空间的某个部分特征空间的规范正交基;
一个识别字典单元,存放对应将被识别的一个或多个目标模式的部分特征空间中所规定的每个字典选择特征向量;
一个特征选择单元,利用存放在所述规范正交基存储单元中的规范正交基,将由所述输入特征向量提取单元所提取的输入特征向量投影在部分特征空间上,由此计算出输入选择特征向量;以及
一个校对单元,通过用存放在所述识别字典单元中的每个字典选择特征向量校对由所述特征选择单元计算出来的输入选择特征向量来识别对应输入选择特征向量的输入模式的类型。
2.根据权利要求1的模式识别装置,进一步包括:
一个模式学习单元,用于计算规范正交基和每个字典选择特征向量,其中所述模式学习单元包括:
一个学习特征向量提取单元,用于提取代表学习模式的特征的学习特征向量;
一个规范正交基计算单元,根据由所述学习特征向量提取单元所提取的多个学习特征向量计算部分特征空间的规范正交基;
一个字典特征向量计算单元,根据所述学习特征向量提取单元所提取的多个学习特征向量,计算对应将被识别的每个目标模式的原始特征空间中所规定的每个字典特征向量;以及
一个字典选择特征向量计算单元,利用由所述规范正交基计算单元计算出来的规范正交基,通过将由所述字典特征向量计算单元计算出的每个字典特征向量投射到该部分特征空间上、计算出每个字典选择特征向量。
3.根据权利要求1的模式识别装置,其中,所述的规范正交基是这样计算出来的:
通过对多个学习特征向量执行典型确认分析,从具有最大特征值的一个开始,顺序计算出比原始特征空间的维数少的预定数目的特征向量;并且
通过从具有最大的特征值的一个开始顺序地规范正交化预定的特征向量计算出预定数目的规范正交基向量。
4.根据权利要求1的模式识别装置,其中,将输入特征向量或每个字典特征向量投射在部分特征空间上得到的所述输入选择特征向量或每个所述字典选择特征向量是通过将输入特征向量或每个字典特征向量投射在规范正交基向量上得到的。
5.根据权利要求4的模式识别装置,其中,将输入特征向量或每个字典特征向量投射在规范正交基向量上得到的所述输入选择特征向量或每个所述字典选择特征向量,是做为计算输入特征向量或每个字典特征向量和规范正交基向量的内积的结果。
6.根据权利要求1的模式识别装置,其中,所述字典选择特征向量基于表示每类将被识别的目标模式的特征向量的平均值的平均特征向量。
7.根据权利要求1的模式识别装置,其中通过计算输入选择特征向量和每个字典选择特征向量之间的距离并相互比较得到的距离值,用每个字典选择特征向量校对所述输入选择特征向量。
8.根据权利要求7的模式识别装置,其中,所述距离基于某个欧几里德距离。
9.根据权利要求7的模式识别装置,其中所述距离基于市街区距离。
10.根据权利要求7的模式识别装置,其中所述距离基于棋盘距离。
11.根据权利要求1的模式识别装置,其中所述模式为字符模式。
12.利用代表输入模式的特征的输入特征向量识别输入模式的模式识别方法,包括步骤:
提取代表输入模式的特征的输入特征向量;
存储原始特征空间的部分特征空间的规范正交基;
存储对应将被识别的一个或多个目标模式的部分特征空间中规定的每个字典选择特征向量;
利用规范正交基将对应输入模式的被提取的输入特征向量投射到部分特征空间计算出输入选择特征向量;并且
通过用每个字典选择特征向量校对输入选择特征向量,识别对应输入选择特征向量的输入模式的类型。
13.根据权利要求12的模式识别方法,进一步包括计算规范正交基和每个字典选择特征向量的步骤;
其中所述步骤包括:
提取代表某个学习模式的特征的学习特征向量;
根据多个被提取的学习特征向量计算部分特征空间的规范正交基;
利用多个学习特征向量,计算对应每个将被识别的目标模式在原始特征空间中指定的每个字典特征向量;并且
利用规范正交基,通过将每个字典特征向量投射在部分特征空间上,计算每个字典选择特征向量。
14.利用代表输入模式的特征的输入特征向量识别输入模式的模式识别装置,包括:
一个特征向量提取单元,用于提取代表输入模式特征的输入特征向量或代表学习模式特征的学习特征向量;
一个规范正交基存储单元,存储原始特征空间的部分特征空间的规范正交基;
一个识别字典单元,存放对应将被识别的一个或多个目标模式在部分特征空间中规定的每个字典选择特征向量;
一个规范正交基计算单元,根据由所述特征向量提取单元所提取的多个学习特征向量计算部分特征空间的规范正交基,并且将计算结果存放在所述规范正交基存储单元中;
一个字典特征向量计算单元,根据由所述特征向量提取单元所提取的多个学习特征向量,计算对应将被识别的每个目标模式在原始特征空间中规定的每个字典特征向量;
一个字典选择特征向量计算单元,利用由所述规范正交基计算单元计算出来的规范正交基,通过将由所述字典特征向量计算单元计算出来的每个字典特征向量投射到部分特征空间上来计算每个字典选择特征向量,并且将计算结果存放在所述识别字典单元中;
一个特征选择单元,利用存放在所述规范正交基存储单元中规范正交基,将由所述特征向量提取单元提取的输入模式的输入特征向量投射在部分特征空间上,计算出输入选择特征向量;
一个校对单元,通过用由所述识别字典单元存储的每个字典选择特征向量校对由所述特征选择单元计算出来的输入选择特征向量,识别对应输入选择特征向量的输入模式的类型。
Applications Claiming Priority (2)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| JP14410996 | 1996-06-06 | ||
| JP144109 | 1996-06-06 |
Publications (2)
| Publication Number | Publication Date |
|---|---|
| CN1167949A CN1167949A (zh) | 1997-12-17 |
| CN1093290C true CN1093290C (zh) | 2002-10-23 |
Family
ID=15354402
Family Applications (1)
| Application Number | Title | Priority Date | Filing Date |
|---|---|---|---|
| CN97103439A Expired - Fee Related CN1093290C (zh) | 1996-06-06 | 1997-03-10 | 利用部分特征空间上投影特征向量的模式识别装置和方法 |
Country Status (3)
| Country | Link |
|---|---|
| US (1) | US5920644A (zh) |
| KR (1) | KR100305977B1 (zh) |
| CN (1) | CN1093290C (zh) |
Families Citing this family (16)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| JP3584458B2 (ja) * | 1997-10-31 | 2004-11-04 | ソニー株式会社 | パターン認識装置およびパターン認識方法 |
| US7389208B1 (en) * | 2000-06-30 | 2008-06-17 | Accord Solutions, Inc. | System and method for dynamic knowledge construction |
| US8159561B2 (en) * | 2003-10-10 | 2012-04-17 | Nikon Corporation | Digital camera with feature extraction device |
| JP2005339039A (ja) * | 2004-05-25 | 2005-12-08 | Fuji Xerox Co Ltd | 文書処理装置および文書処理方法 |
| JP4217664B2 (ja) * | 2004-06-28 | 2009-02-04 | キヤノン株式会社 | 画像処理方法、画像処理装置 |
| JP2007233873A (ja) * | 2006-03-02 | 2007-09-13 | Toshiba Corp | パターン認識装置及びその方法 |
| JP4443576B2 (ja) * | 2007-01-18 | 2010-03-31 | 富士通株式会社 | パターン分離抽出プログラム、パターン分離抽出装置及びパターン分離抽出方法 |
| US7961955B1 (en) | 2008-01-28 | 2011-06-14 | Thomas Cecil Minter | Adaptive bayes feature extraction |
| KR101480221B1 (ko) * | 2013-05-23 | 2015-01-07 | 한국과학기술원 | 선형 판별 분석을 이용하여 복잡도를 줄인 특징 추출 방법 및 그 시스템 |
| JP6156126B2 (ja) * | 2013-12-19 | 2017-07-05 | 富士通株式会社 | 検索方法、検索プログラムおよび検索装置 |
| WO2016181474A1 (ja) * | 2015-05-11 | 2016-11-17 | 株式会社東芝 | パターン認識装置、パターン認識方法およびプログラム |
| US11026634B2 (en) | 2017-04-05 | 2021-06-08 | doc.ai incorporated | Image-based system and method for predicting physiological parameters |
| US11853891B2 (en) | 2019-03-11 | 2023-12-26 | Sharecare AI, Inc. | System and method with federated learning model for medical research applications |
| US11915802B2 (en) | 2019-08-05 | 2024-02-27 | Sharecare AI, Inc. | Accelerated processing of genomic data and streamlined visualization of genomic insights |
| US11256801B2 (en) * | 2020-04-21 | 2022-02-22 | doc.ai, Inc. | Artificial intelligence-based generation of anthropomorphic signatures and use thereof |
| US12039012B2 (en) | 2020-10-23 | 2024-07-16 | Sharecare AI, Inc. | Systems and methods for heterogeneous federated transfer learning |
Family Cites Families (7)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| US4259661A (en) * | 1978-09-01 | 1981-03-31 | Burroughs Corporation | Apparatus and method for recognizing a pattern |
| JPS6057475A (ja) * | 1983-09-07 | 1985-04-03 | Toshiba Corp | パタ−ン認識方式 |
| JP2607457B2 (ja) * | 1984-09-17 | 1997-05-07 | 株式会社東芝 | パターン認識装置 |
| US5109431A (en) * | 1988-09-22 | 1992-04-28 | Hitachi, Ltd. | Pattern discrimination method and apparatus using the same |
| EP0539439B1 (en) * | 1990-07-17 | 1999-06-16 | BRITISH TELECOMMUNICATIONS public limited company | Method and apparatus for processing an image |
| JP3163185B2 (ja) * | 1992-11-27 | 2001-05-08 | 株式会社東芝 | パターン認識装置およびパターン認識方法 |
| JP2690027B2 (ja) * | 1994-10-05 | 1997-12-10 | 株式会社エイ・ティ・アール音声翻訳通信研究所 | パターン認識方法及び装置 |
-
1997
- 1997-02-14 US US08/801,806 patent/US5920644A/en not_active Expired - Lifetime
- 1997-02-28 KR KR1019970006742A patent/KR100305977B1/ko not_active Expired - Fee Related
- 1997-03-10 CN CN97103439A patent/CN1093290C/zh not_active Expired - Fee Related
Also Published As
| Publication number | Publication date |
|---|---|
| KR100305977B1 (ko) | 2001-10-19 |
| US5920644A (en) | 1999-07-06 |
| CN1167949A (zh) | 1997-12-17 |
| KR980004035A (ko) | 1998-03-30 |
Similar Documents
| Publication | Publication Date | Title |
|---|---|---|
| CN1167949A (zh) | 利用部分特征空间上投影特征向量的模式识别装置和方法 | |
| CN1145872C (zh) | 手写汉字自动分割和识别方法以及使用该方法的系统 | |
| CN1301482C (zh) | 便于模式识别的系统和方法 | |
| CN100342399C (zh) | 提取用作面貌识别和重现的特征向量的方法和装置 | |
| Maitra et al. | A hybrid cooperative–comprehensive learning based PSO algorithm for image segmentation using multilevel thresholding | |
| CN1194320C (zh) | 利用一和二次本征特征的照明和视角不变的面容描绘方法 | |
| US8401283B2 (en) | Information processing apparatus, information processing method, and program | |
| Vasconcelos | On the efficient evaluation of probabilistic similarity functions for image retrieval | |
| US6600830B1 (en) | Method and system of automatically extracting facial features | |
| CN1700241A (zh) | 面部描述和识别的方法和装置 | |
| JP2022525267A5 (zh) | ||
| CN109961093B (zh) | 一种基于众智集成学习的图像分类方法 | |
| CN1977286A (zh) | 对象识别方法及其设备 | |
| CN1253353A (zh) | 使用本征话音技术使说话者规范化并使其与环境相适应 | |
| CN1459761A (zh) | 基于Gabor滤波器组的字符识别技术 | |
| CN101055620A (zh) | 形状比较装置和方法 | |
| US20050152604A1 (en) | Template matching method and target image area extraction apparatus | |
| CN108629373B (zh) | 一种图像分类方法、系统、设备及计算机可读存储介质 | |
| CN1498381A (zh) | 使用距离度量的图像检索 | |
| CN1701323A (zh) | 使用笔迹特征合成的数字笔迹数据库搜索 | |
| CN1392985A (zh) | 多处理器系统、数据处理系统、数据处理方法和计算机程序 | |
| CN1190764A (zh) | 利用候选表进行分类的模式识别设备及其方法 | |
| CN1922632A (zh) | 参考数据优化学习方法及模式识别系统 | |
| CN1368705A (zh) | 采用概率密度函数的模式识别装置及其方法 | |
| CN1570958A (zh) | 多字体多字号印刷体藏文字符识别方法 |
Legal Events
| Date | Code | Title | Description |
|---|---|---|---|
| C10 | Entry into substantive examination | ||
| SE01 | Entry into force of request for substantive examination | ||
| C06 | Publication | ||
| PB01 | Publication | ||
| C14 | Grant of patent or utility model | ||
| GR01 | Patent grant | ||
| C17 | Cessation of patent right | ||
| CF01 | Termination of patent right due to non-payment of annual fee |
Granted publication date: 20021023 Termination date: 20140310 |