CN106919579B - 一种信息处理方法及装置、设备 - Google Patents
一种信息处理方法及装置、设备 Download PDFInfo
- Publication number
- CN106919579B CN106919579B CN201510990666.0A CN201510990666A CN106919579B CN 106919579 B CN106919579 B CN 106919579B CN 201510990666 A CN201510990666 A CN 201510990666A CN 106919579 B CN106919579 B CN 106919579B
- Authority
- CN
- China
- Prior art keywords
- trigger
- characteristic parameter
- trigger event
- classification
- user
- Prior art date
- Legal status (The legal status is an assumption and is not a legal conclusion. Google has not performed a legal analysis and makes no representation as to the accuracy of the status listed.)
- Active
Links
Images


Classifications
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F16/00—Information retrieval; Database structures therefor; File system structures therefor
- G06F16/90—Details of database functions independent of the retrieved data types
- G06F16/95—Retrieval from the web
- G06F16/955—Retrieval from the web using information identifiers, e.g. uniform resource locators [URL]
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06Q—INFORMATION AND COMMUNICATION TECHNOLOGY [ICT] SPECIALLY ADAPTED FOR ADMINISTRATIVE, COMMERCIAL, FINANCIAL, MANAGERIAL OR SUPERVISORY PURPOSES; SYSTEMS OR METHODS SPECIALLY ADAPTED FOR ADMINISTRATIVE, COMMERCIAL, FINANCIAL, MANAGERIAL OR SUPERVISORY PURPOSES, NOT OTHERWISE PROVIDED FOR
- G06Q30/00—Commerce
- G06Q30/02—Marketing; Price estimation or determination; Fundraising
- G06Q30/0241—Advertisements
- G06Q30/0242—Determining effectiveness of advertisements
- G06Q30/0245—Surveys
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06Q—INFORMATION AND COMMUNICATION TECHNOLOGY [ICT] SPECIALLY ADAPTED FOR ADMINISTRATIVE, COMMERCIAL, FINANCIAL, MANAGERIAL OR SUPERVISORY PURPOSES; SYSTEMS OR METHODS SPECIALLY ADAPTED FOR ADMINISTRATIVE, COMMERCIAL, FINANCIAL, MANAGERIAL OR SUPERVISORY PURPOSES, NOT OTHERWISE PROVIDED FOR
- G06Q30/00—Commerce
- G06Q30/02—Marketing; Price estimation or determination; Fundraising
- G06Q30/0241—Advertisements
- G06Q30/0248—Avoiding fraud
Landscapes
- Engineering & Computer Science (AREA)
- Business, Economics & Management (AREA)
- Development Economics (AREA)
- Strategic Management (AREA)
- Finance (AREA)
- Theoretical Computer Science (AREA)
- Accounting & Taxation (AREA)
- Physics & Mathematics (AREA)
- General Physics & Mathematics (AREA)
- Game Theory and Decision Science (AREA)
- Entrepreneurship & Innovation (AREA)
- Databases & Information Systems (AREA)
- Economics (AREA)
- Marketing (AREA)
- General Business, Economics & Management (AREA)
- General Engineering & Computer Science (AREA)
- Data Mining & Analysis (AREA)
- Management, Administration, Business Operations System, And Electronic Commerce (AREA)
Abstract
本发明公开了一种信息处理方法,所述方法包括:确定待分类的第一触发事件;从所述第一触发事件中获取用户的标识信息和所述第一触发操作的属性信息;根据所述用户的标识信息获取用于描述所述用户在第一时间段内的用户行为特征的第一特征参数;根据所述第一触发操作的属性信息确定用于描述所述用户在第二时间段内的用户行为特征的第二特征参数,其中,所述第一时间段大于所述第二时间段;将所述第一特征参数和所述第二特征参数输入预设的分类模型,所述分类模型以所述第一特征参数和所述第二特征参数为分类参数;获取所述分类模型输出的所述第一触发事件的分类结果;输出所述分类结果。本发明同时还公开了一种信息处理方法及设备。
Description
技术领域
本发明涉及信息技术,尤其涉及一种信息处理方法及装置、设备。
背景技术
中国移动互联网行业的发展推升着移动广告行业的发展,而广告业务被认为是互联网经济中最活跃的引擎,其中移动互联网广告(简称移动广告)作为互联网广告中最重要的组成部分,是一类基于无线通信技术以移动设备为载体的一种广告形式,移动广告近年来得到了蓬勃的发展,2014年移动广告市场规模飙升至125亿美元。
图1A为相关技术中互联网广告的产业链示意图,如图1A所示,互联网广告的产业链10中包括广告主11、广告平台12、流量主(例如媒体等)13和受众(用户)15;其中广告平台12是广告主11与流量主13之间的中介,当广告主11有广告需要曝光的时候,广告主会付出经济上的代价以将待曝光的广告挂在广告平台12上,其中,广告主11在挂待曝光广告的时候往往会选择一些投放条件,例如受众、播放方式、计费方式、广告需要投放的流量主等。广告平台12根据广告主11设置的投放条件确定待投放的流量主13,然后将待曝光的广告挂在流量主上。当用户15使用流量主的产品(例如观看视频)时,用户15通过如手机、平板电脑、个人电脑等终端14接收广告,从而完成广告主的广告的曝光。从上述广告的产业链可以看出:广告主一般会付出真金白银来提高自己产品的知名度,而流量主通过消耗自身的流量来收取广告费用,一般来说广告平台会根据广告的实际曝光向广告主收取费用,然后通过协议向流量主分配收益。
目前互联网广告中广告费用的收取都是借助于一些数据,例如广告费用是按照按点击计价(CPC)来收费,如果广告平台或流量主采用作弊手段来进行大量点击,这样就会形成作弊流量(虚假数据),进而向广告主收费。一般来说,作弊手段包括:利用大量测试机或者模拟器直接发送点击事件,也有一些是雇佣或者激励式诱导用户来进行大量点击,从而形成作弊流量。由此可见,广告主是互联网广告链条里最大的受害者,所以许多广告主都在想方设法的进行作弊防护。随着互联网广告市场的健全,第三方监测平台应运而生,第三方监测平台凭借技术方面的专业性和第三方的中立性,兼顾全平台的数据进行作弊防护,可以很好的保护广告主的利益。
然而,互联网广告中的作弊不但会损害广告主的经济利益,还会损害广告平台的声誉,因为第三方监测平台会向广告主返回一个接近于真实的数据(该数据剔除由于作弊而产生的虚假数据),如果广告平台向广告主提供的数据虚高,那么就会让广告主对广告平台失去信任,从而造成广告平台的声誉下降。综上所述,如何防止互联网广告中作弊成为亟需解决的问题。
发明内容
有鉴于此,本发明实施例为解决现有技术中存在的至少一个问题而提供一种信息处理方法及装置、设备,能够防止互联网中的作弊操作,从而得出正确的效果点击结果。
本发明实施例的技术方案是这样实现的:
第一方面,本发明实施例提供一种信息处理方法,其特征在于,所述方法包括:
确定待分类的第一触发事件,所述第一触发事件用于描述第一触发操作;
从所述第一触发事件中获取用户的标识信息和所述第一触发操作的属性信息;
根据所述用户的标识信息获取用于描述所述用户在第一时间段内的用户行为特征的第一特征参数;
根据所述第一触发操作的属性信息确定用于描述所述用户在第二时间段内的用户行为特征的第二特征参数,其中,所述第一时间段大于所述第二时间段;
将所述第一特征参数和所述第二特征参数输入预设的分类模型,所述分类模型以所述第一特征参数和所述第二特征参数为分类参数;
获取所述分类模型输出的所述第一触发事件的分类结果;
输出所述分类结果。
第二方面,本发明实施例提供一种信息处理装置,所述装置包括第一确定单元、第一获取单元、第二获取单元、第二确定单元、输入单元、第三获取单元和输出单元,其中:
所述第一确定单元,用于确定待分类的第一触发事件,所述第一触发事件用于描述第一触发操作;
所述第一获取单元,用于从所述第一触发事件中获取用户的标识信息和所述第一触发操作的属性信息;
所述第二获取单元,用于根据所述用户的标识信息获取用于描述所述用户在第一时间段内的用户行为特征的第一特征参数;
所述第二确定单元,用于根据所述第一触发操作的属性信息确定用于描述所述用户在第二时间段内的用户行为特征的第二特征参数,其中,所述第一时间段大于所述第二时间段;
所述输入单元,用于将所述第一特征参数和所述第二特征参数输入预设的分类模型,所述分类模型以所述第一特征参数和所述第二特征参数为分类参数;
所述第三获取单元,用于获取所述分类模型输出的所述第一触发事件的分类结果;
所述输出单元,用于输出所述分类结果。
第三方面,本发明实施例提供一种信息处理设备,所述设备包括显示装置和处理装置,其中:
所述显示装置,用于显示所述处理装置输出的分类结果;
所述处理装置,用于:确定待分类的第一触发事件,所述第一触发事件用于描述第一触发操作;从所述第一触发事件中获取用户的标识信息和所述第一触发操作的属性信息;根据所述用户的标识信息获取用于描述所述用户在第一时间段内的用户行为特征的第一特征参数;根据所述第一触发操作的属性信息确定用于描述所述用户在第二时间段内的用户行为特征的第二特征参数,其中,所述第一时间段大于所述第二时间段;将所述第一特征参数和所述第二特征参数输入预设的分类模型,所述分类模型以所述第一特征参数和所述第二特征参数为分类参数;获取所述分类模型输出的所述第一触发事件的分类结果;输出所述分类结果。
本发明实施例提供的一种信息处理方法及装置、设备,其中确定待分类的第一触发事件;从所述第一触发事件中获取用户的标识信息和所述第一触发操作的属性信息;根据所述用户的标识信息获取用于描述所述用户在第一时间段内的用户行为特征的第一特征参数;根据所述第一触发操作的属性信息确定用于描述所述用户在第二时间段内的用户行为特征的第二特征参数,其中,所述第一时间段大于所述第二时间段;将所述第一特征参数和所述第二特征参数输入预设的分类模型,所述分类模型以所述第一特征参数和所述第二特征参数为分类参数;获取所述分类模型输出的所述第一触发事件的分类结果;输出所述分类结果,如此,能够防止互联网中的作弊操作,从而得出正确的效果点击结果。
附图说明
图1A为相关技术中互联网广告的产业链示意图;
图1B为本发明实施例中进行信息交互的各方硬件实体的示意图;
图2为本发明实施例一信息处理方法的实现流程示意图;
图3A为发明实施例三分类模型的训练过程示意图;
图3B为本发明实施例三抽取样本的框架示意图;
图3C为本发明实施例三GBDT的分类模型中回归树的示意图;
图3D为本发明实施例中基于规则的判罚方式对作弊流量进行实时过滤的方法的实现流程示意图;
图4为本发明实施例四信息处理方法的实现流程示意图;
图5A为本发明实施例各实体的硬件组成结构示意图;
图5B为本发明实施例五信息处理装置的组成结构示意图;
图6为本发明实施例六信息处理设备的组成结构示意图。
具体实施方式
为了更好地介绍和理解本发明的各实施例,下面介绍一下本发明的各实施例中可能涉及的一些专业词汇,具体包括:
广告请求:用户侧用广告请求拉取广告,用于展现;
广告曝光:广告在用户侧进行一次实际展示让用户看到算作一次曝光;
广告点击:用户通过点击广告而访问广告主的网页,称一次点击;
广告转化:用户通过点击广告后进行的转化行为,比如下载软件应用程序(APP,Application),购买商品等;
点击时间序:同一个用户当天发生一系列点击的顺序;
点击作弊:在广告系统中,用户出于某种恶意目的会存在刷广告点击量的行为;包含作弊的点击不但会严重影响广告平台的口碑,而且会恶意消耗广告主预算,从而拉低广告主投资回报率(ROI),最终导致广告主不再信任广告平台;
点击反作弊:运用多种手段对广告点击进行检查,判断点击是否为正常点击;
点击反作弊系统:对点击进行反作弊检查的系统;
作弊自反馈(FOPF,Fraud On Predict Fraud):表示实际作弊和预测作弊的比例,用来矫正模型预测精度。该概念来自点击转化率(CTR)预估中的COPC(Click On PredictClick);
反作弊策略:反作弊系统为打击反作弊行为,制定了一系列规则和模型,每种规则和模型称为一种策略;
CTR:点击转化率;
CVR:效果转化率;
CTR预估:基于机器学习预估用户点击广告的概率;
机器学习:依托概率论,统计学,神经传播等理论,使计算机能够模拟人类的学习行为,以获取新的知识或者技能,重新组织已有知识结构使之不断改善自身的性能;
模型训练:将人工选择的样本输入给机器学习系统,通过不断调整模型参数,使最终模型对样本识别的准召率达到最优;
有监督模型:需要人工指定正负样本进行训练;
无监督模型:不需要指定正负样本训练,也没有正负样本的概念;
在线打分:对实时产生的广告点击,通过机器学习的手段对其进行恶意度打分,分数越高,则作弊概率越大;
按每千次展示计价(Cost Per Mille,CPM);
按点击计价(Cost Per Click,CPC)。
下面介绍一下本发明实施例所涉及的信息交互的各方硬件实体,图1B为本发明实施例中进行信息交互的各方硬件实体的示意图,图1B中包括:服务器(可因为广告平台)11……1n、终端设备21-24,终端设备21-24通过有线网络或者无线网络与服务器进行信息交互,终端设备包括手机、台式机、PC机、一体机等类型,一个示例中,服务器11……1n还可以通过网络与第一终端31…3n(如广告主所在的终端,或称为提供广告素材和内容推广的对象)进行交互,第一终端(如广告主所在的终端,或称为提供广告素材和内容推广的对象)将想要投放的广告提交后,被存储在服务器集群中,可以配备管理员对第一终端(如广告主所在的终端,或称为提供广告素材和内容推广的对象)投放的广告进行审核等一系列处理。其中,相对于第一终端31…3n(如广告主所在的终端,或称为提供广告素材和内容推广的对象)而言,终端设备21至24可以称为第二终端(如普通用户所在的终端,或称为广告展示或曝光的对象),可以为通过视频应用看视频的用户,通过游戏应用打游戏的用户,通过上网浏览页面的用户等等。其中,终端设备中安装的所有应用或者指定的应用(如游戏应用、视频应用、浏览器应用等等)都可以添加广告以展示给用户更多的推荐信息。上述图1B的例子只是实现本发明实施例的一个系统架构实例,本发明实施例并不限于上述图1B所述的系统结构,基于该系统架构,提出本发明各个实施例。
下面结合附图和具体实施例对本发明的技术方案进一步详细阐述。
实施例一
为了解决前述的技术问题,本发明实施例提供一种信息处理方法,该方法应用于信息处理设备,所述信息处理设备包括各种具有信息处理能力的计算设备,例如个人计算机、平板电脑、笔记本电脑、集成服务器等。本发明实施例中的信息处理设备具体可以为广告平台或流量主侧的计算设备或第三方检测平台,在具体实现的过程中,该信息处理方法所实现的功能可以通过信息处理设备中的处理器调用程序代码来实现,当然程序代码可以保存在计算机存储介质中,可见,该信息处理设备至少包括处理器和存储介质。
图2为本发明实施例一信息处理方法的实现流程示意图,如图2所示,该信息处理方法包括:
步骤S101,确定待分类的第一触发事件,所述第一触发事件用于描述第一触发操作;
这里,所述第一触发操作可以包括触发广告曝光的操作,一般来说,触发广告曝光的操作可以包括点击操作和除所述点击操作之外的其他形式的操作,所述点击操作包括通过鼠标的点击操作和通过操作体在触摸屏上的触摸操作其他形式的操作例如可以声控操作、面部识别操作或眼神识别操作,通过语音识别来确定用户发出的声音是否要使广告曝光即通过声控操作触发广告曝光,通过面部识别确定用户是否要使广告曝光,即通过面部识别操作触发广告曝光;通过眼神识别确定用户是否要使广告曝光,即通过眼神识别操作触发广告曝光。
这里,下面以触发操作为点击广告的操作为例进行说明第一触发事件,所述第一触发事件在具体实现的过程中包括很多信息,例如第一触发事件包括用户信息、广告信息、点击的属性信息、终端信息等,其中用户信息包括用户的标识信息(ID)、用户的昵称、名称、联系方式、地址、单位、账户、性别、年龄、偏好等信息,广告信息包括广告的标识信息(ID)、广告类别、广告尺寸等信息,终端信息包括终端的型号、终端的厂商、网络的运营商、设备的标识信息(ID)等信息,而点击的属性信息包括点击的位置、点击时间、点击频率或点击的时间间隔、用户行为习惯(拖拽、双击、点击)、广告的曝光时间等信息。
步骤S102,从所述第一触发事件获取用户的标识信息和所述第一触发操作的属性信息;
步骤S103,根据所述用户的标识信息获取用于描述所述用户在第一时间段内的用户行为特征的第一特征参数;
这里,所述第一特征参数可以存储于本地也可以从网络上或其他数据库上获取,例如,可以将第一特征参数存储于内存服务器。
步骤S104,根据所述第一触发操作的属性信息确定用于描述所述用户在第二时间段内的用户行为特征的第二特征参数,其中,所述第一时间段大于所述第二时间段;
这里,在具体实现的过程中,所述第一特征参数可以为过去一个礼拜或过去一个月或者过去10天的特征参数,而第二特征参数可以为当天或过去24小时之内的或者过去36小时之内的特征参数。在本发明的一种实施例中,所述第一触发操作的属性信息至少包括所述第一触发事件的触发时刻(可以理解为点击时刻),所述第二时间段包括从预设的第一时刻至所述第一触发事件的触发时刻之间的时间段。
一般来说,以广告为例,广告的特征参数包括各种不同维度,例如包括:1)用户短期特征(当日点击次数、点击广告主数、点击频率或点击的时间间隔等);2)用户长期特征(过去一个周期内曝光/点击/转化次数、点击广告主/广告位APP数,点击时间分布、点击坐标分布等)、3)用户信息(性别、年龄、偏好等);4)点击上下文特征(点击和曝光IP是否匹配、用户是否登录帐号(如QQ)、广告播放时长、点击时刻等);5)流量主特征(播放广告是否展示退出按钮、历史一段周期内平均CTR/CVR/FOPF等);6)广告主特征(历史一段周期内平均CTR/CVR/FOPF等)。而本发明实施例中实际上值关注两个维度的特征参数,即第一特征参数和第二特征参数,其中,第一特征参数可以理解为长期特征,而第二特征参数可以理解为短期特征。
步骤S105,将所述第一特征参数和所述第二特征参数输入预设的分类模型,所述分类模型以所述第一特征参数和所述第二特征参数为分类参数;
这里,所述分类模型可以包括各种分类算法的模型,其中所述分类算法包括逻辑回归算法(LR)、支持向量机(SVM)和梯度提升决策树(Gradient Boosting Decision Tree,GBDT);当所述分类模型采用GBDT时,所述分类模型以所述第一特征参数和所述第二特征参数为分类节点的分类树。
步骤S106,获取所述分类模型输出的所述第一触发事件的分类结果;
步骤S107,输出所述分类结果。
这里,当信息处理设备包括处理装置(如处理器)和显示装置(显示屏)时,所述输出所述分类结果可以包括:处理装置将所述分类结果显示在所述显示装置上;当所述信息处理装置不包括显示装置时,所述输出所述分类结果可以包括:所述处理装置将所述分类结果通过通信装置(外部通信接口)发送其他的信息处理设备。
本发明实施例中,所述第一触发事件可以是在线数据,也可以是离线数据;当所述第一触发事件为在线数据时,所述确定待分类的第一触发事件,包括:接收在线的触发流,从所述触发流中分离出所述第一触发事件。在具体实现的过程中,用户通过终端点击广告,这样终端就会向本发明实施例的信息处理设备(也可以是其他的信息处理设备)发送一个判罚请求,该判罚请求至少携带有触发事件,用于请求信息处理设备判断触发事件是否作弊或违规,当很多终端都向信息处理设备发送判罚请求时,然后信息处理设备处理的就是源源不断的触发流,当信息处理设备需要对触发事件进行处理时,则从所述触发流中分离出第一触发事件。当所述第一触发事件为离线数据时,所述确定待分类的第一触发事件,包括:获取触发操作的日志(例如点击日志),从所述操作日志中提取出所述第一触发事件。
本发明实施例中,所述第一触发操作的属性信息至少包括所述第一触发事件的触发时刻,所述第二时间段包括从预设的第一时刻至所述第一触发事件的触发时刻之间的时间段。对应地,所述根据所述第一触发操作的属性信息确定用于描述所述用户在第二时间段内的用户行为特征的第二特征参数,包括:
步骤S131,根据所述用户的标识信息获取第二触发事件的第三特征参数;
这里,所述第二触发事件包括距离所述第一触发操作的点击时刻之间的时间差最短的触发事件,所述第二触发事件用于描述第二触发操作,所述第三特征参数用于所述用户从所述第一时刻至所述第二触发事件的触发时刻之间的时间段内的用户行为特征;所述第三特征参数与所述第一特征参数类似,都可以从本地或网络上获取。
步骤S132,根据所述第一触发操作的属性信息和所述第三特征参数确定所述第二特征参数。
这里,假设所述第二特征参数为当天的点击次数,那么在第一触发操作之前,当天的点击次数为18,那么加上第一触发操作的点击次数,即可以确定当前的点击次数为19次;再如,所述第二特征参数为点击时间间隔,那么则要从第三特征参数即为第二触发操作的点击时刻,第一触发操作的点击时刻与第二触发操作的点击时刻之差即可确定点击的时间间隔。
本发明实施例中,作为一种优选的技术方案,所述第一特征参数包括在第一时间段内的点击数,所述第二特征参数包括在第二时间段内的点击数和点击频率或点击的时间间隔。
实施例二
基于前述的实施例,本发明实施例提供一种基于引入机器学习技术而形成一种分类模型,对每一次点击分类都会考虑所有特征维度然后综合进行判断。在形成分类模型的初期,仍然需要人工挑选尽可能多维度的特征参数供机器学习模型训练,根据特征参数对训练结果的区分度决定选用哪些特征来描述,这里基本不存在人工干预选择参数的问题,机器学习可以自己学习出合适的参数来;由于特征含义相比没有意义的参数看来更为直观,结合特征数据的分布,解释起来也比较容易理解;首先基于机器学习模型的实时判罚,判罚逻辑非常复杂,作弊者无法通过简单的调整作弊手段对反作弊策略进行探测破解。另外由于模型自身具有进化学习的功能。即使作弊者变更作弊手法,通过简单的重新进行模型训练(有时候需要对特征进行微调),即可以识别新的作弊手段并进行惩罚,使作弊者始终难以绕过判罚策略。
机器学习实时判罚技术对每条点击都会进行单独判罚,而点击出现的时间序列只是其中一个特征点,不会对判罚起决定性作用。这样对于出现在时间序列开头的作弊流量或者出现在时间序末尾的正常流量均能正确的判罚和放过,从而避免一刀切的情况出现;机器学习技术在反作弊中的应用可以自由的分享和传播,因为机器学习判罚的原理复杂且可以自我进化,不针对特定某种作弊手段,因此甚至对作弊者一样可以公开基于机器学习模型的反作弊做法。基于前述的实施例,本发明实施例提供一种形成分类模型的方法,该方法包括:
步骤S201,按照预设的配置比例获取正样本和负样本;
这里,在实际操作的过程中,作弊操作和正常操作会存在一定的比例,这个比例即为配置比例,在形成分类模型时,训练数据也需要按照该配置比例进行设置。
步骤S202,提取所述正样本的不同维度的特征参数和所述负样本的不同维度的特征参数;
这里,以广告的点击操作为例,所述不同维度的特征参数可以包括广告的特征参数包括各种不同维度,例如包括:1)用户短期特征(当日点击次数、点击广告主数、点击频率或点击的时间间隔等);2)用户长期特征(过去一个周期内曝光/点击/转化次数、点击广告主/广告位/APP数,点击时间分布、点击坐标分布等)、3)用户信息(性别、年龄、偏好等);4)点击上下文特征(点击和曝光IP是否匹配、用户是否登录帐号、广告播放时长、点击时刻等);5)流量主特征(播放广告是否展示退出按钮、历史一段周期内平均CTR/CVR/FOPF等);6)广告主特征(历史一段周期内平均CTR/CVR/FOPF等)。而本发明实施例中实际上值关注两个维度的特征参数,即第一特征参数和第二特征参数,其中,第一特征参数可以理解为长期特征,而第二特征参数可以理解为短期特征。即从正样本和负样本中提取出上述这些不同维度的参数。
步骤S203,将所述正样本或所述负样本的不同维度的特征参数输入设置的第一训练模型,得到第一训练结果,所述第一训练模型以具有预设权重的不同维度的特征参数为分类参数;
步骤S204,如果所述第一训练结果不满足预设的条件,则逐一调整每一所述不同维度的特征参数的权重直至所述训练结果满足所述条件,将所述第一训练结果满足所述条件的第一训练模型作为所述分类模型输出;
本发明实施例中,所述每一所述不同维度的特征参数的权重,包括:
利用 从所述不同维度的特征参数中筛选出所述第一特征参数和所述第二特征参数;
其中,D表示作为训练数据集的正样本和负样本,A表示某一维度的特征参数,g(D,A)表示特征参数A在训练数据集D下获得的权重,P(D)i表示训练数据集D分类为i的概率,P(D/A)i表示在给定特征参数A的前提下,训练数据集D分类为i的条件概率。
步骤S205,如果所述第一训练结果满足预设的条件,则将所述第一训练模型作为所述分类模型输出。
本发明实施例中,不管采用何种训练模型,在开始训练之时,该训练模型的输入包括上述不同维度的特征参数,经过多次试验如果该特征参数不对训练结果产生有利影响或者分错的时候,就降低该特征参数的权重,如果该特征参数对训练结果产生有利影响时候,就提高该特征参数的权重,如果一个参数的权重降低为0,那么在训练模型中该特征参数将不起任何作用了。经过本发明实施例的最终试验,上述不同的维度的特征参数最终对训练结果能够产生积极影响的是长期特征(即第一特征参数)和长期特征(即第二特征参数)。下面假设不同维度的特征参数只包括第一特征参数和第二特征参数(即已经将其他的特征参数都剔除掉了),那么上述的分类模型的形成过程大致包括:将所述正样本的第一特征参数和第二特征参数输入第一训练模型,从所述第一训练模型获得第一训练结果;其中所述第一训练模型以第一特征参数和第二特征参数为分类参数,且每一分类参数具有对应的权重;
如果所述第一训练结果满足预设的第一条件,则将所述负样本的第一特征参数和第二特征参数输入第一训练模型,从所述第一训练模型获得第二训练结果;如果所述第二训练结果满足预设的第二条件,则将所述第一训练模型作为所述分类模型。
如果所述第一训练结果不满足所述第一条件,则调整所述第一训练模型的分类参数的权重,得到第二训练模型;将所述正样本的第一特征参数和第二特征参数输入所述第二训练模型,从所述第二训练模型获得新的第一训练结果;如果所述新的第一训练结果不满足所述第一条件,则依此调整第二训练模型的分类参数的权重,直到所述新的第一训练结果满足所述第一条件;然后将所述负样本的第一特征参数和第二特征参数输入第二训练模型,从所述第二训练模型获得第二训练结果;如果所述第二训练结果满足预设的第二条件,则将所述第二训练模型作为所述分类模型。
如果所述第二训练结果不满足预设的第二条件,则调整所述第一训练模型的分类参数的权重,得到第三训练模型;将所述负样本的第一特征参数和第二特征参数输入所述第三训练模型,从所述第三训练模型获得新的第二训练结果;如果所述新的第二训练结果不满足所述第二条件,则依此调整第三训练模型的分类参数的权重,直到所述新的第二训练结果满足所述第二条件,最终将所述第三训练模型作为分类模型。
从上述过程可以看出,特征参数的权重调整在分类模型中占据着重要的作用,实际上,本发明实施例中特征参数的权重是自动调整的,即可以实现对人工初选的所有特征自动进行权重分配,突出起主导作用的特征参数,弱化起非关键作用的特征参数,对于对最终判罚起不到作用的特征参数,权重会直接降为0,即此特征会被忽略。具体做法为,针对每个特征参数都会计算该特征参数对当前待分类数据的信息增益,其中信息增益的定义为特征A对训练数据集D的熵与条件熵的差,即公式(1):
g(D,A)=H(D)-H(D/A) (1);
公式(1)中,权重就是信息增益,这里熵表示的是对一个数据集分类的不确定程度,熵的计算方式为: 其中X表示数据集,pi表示数据集分类为i的概率,log表示以2为底的对数,因此最终特征A的权重计算方式为公式(2):

公式(2)中,D表示待分类的数据集,A表示某个特征参数,g(D,A)表示特征参数A在训练数据集D下获得的权重,P(D)i表示数据集D分类为i的概率,P(D/A)i表示在给定特征A的前提下,数据集D分类为i的条件概率,条件概率计算公式(3)为:

公式(3)中,P(B)表示事件B出现的概率,P(AB)表示事件A和B同时出现的概率,P(A|B)表示在事件B出现的前提下,事件A出现的概率。
信息增益就表示特征参数A的使用,对数据集D进行分类时不确定性的减少程度。举个例子,假如有一群学生,初始对其性别进行正确分类的概率是50%,此时没有任何特征信息,熵最大为1。如果告知每个学生的年龄,此时对其性别进行正确分类的概率仍然是50%,熵仍然最大,因为年龄并不能提供准确判断性别的有效信息,那么特征年龄的信息增益为0,此时可认为权重为0;假如告知每个学生的性别,然后再对其进行性别分类,那么分类正确的概率是100%,此时熵最小为0,特征性别的信息增益最大为1,此时可认为权重为1。我们可以通过乘上不同的常量系数C来放大或者缩小权重的绝对值。
从以上流程可以看出,1)本发明实施例采用了基于分类模型的过滤判罚系统,当点击流到来会综合考虑各方面因素(如第一特征参数和第二特征参数)评定此次点击是否作弊,而不是刻板的统计点击频率决定是否判罚,更加智能和灵活;2)本发明实施例引入了各种不同维度的特征参数来对训练模型进行训练,根据训练结果确定最终核实的特征参数(如第一特征参数和第二特征参数,如此提升作弊识别的准确性。3)本发明实施例采用的分类模型的一个显著特点是模型可以自我进化,根据作弊行为的变换自动进行特征权重的调整,避免基于规则的人工频繁介入调整参数。
实施例三
从实施例一和实施例二可以看出,本发明的各实施例实际上提供一种基于机器学习的分类方法,以区分广告的点击操作是否为作弊操作,对每一次点击操作的分类都会考虑所有特征维度然后综合进行判断。相比之下,本发明实施例提供的技术方案更加智能和准确,且从结果的解释上据有更强的说服力。
下面介绍一下训练模型的训练过程,图3A为发明实施例三训练模型的训练过程示意图,如图3A所示,该流程主要包括:
步骤S301,获取各种日志;
具体地,在具体实现的过程中,可以获取点击日志、广告的曝光日志、效果日志(Trace Log)以及包括用户信息的用户数据;上述日志主要用来提取不同维度的特征参数,特征参数在初始的时候要尽量多的选择,后续进行训练模型训练的时候逐渐剔除对分类作用较小的特征,特征参数对分类结果的影响可以通过特征权重来进行判别,如果某个特征参数的权重为0或者非常低,那么可以认为这个特征参数的作用很小,可以排除。这里初始选择的特征维度有三十多个,包括用户维度、广告主维度、流量主维度、长期特征、短期特征等等。由于数据量庞大,各个特征维度值的获取需要通过基于Hadoop的分布式作业来计算获得。
步骤S302,根据获取的各种日志抽取正负样本;
这里,本发明实施例选用有监督的分类回归模型作为分类模型,而有监督的分类回归模型训练需要用到正负样本,这里正负样本的选择纯靠人工存在以下问题:样本规模有限,人工认知存在偏差,标注出的样本数据也会有噪音;标注成本高。基于以上原因,本发明实施例采用程序自动化抽取正样本和负样本。正样本的获取采用基于规则的(Rule-based)的判罚方式和基于统计的(Statistics-based)的判罚方式相结合的方式来抽取。抽取样本的框架图参见图3B,如图3B所示,基于规则的判罚方式用于对上述的各种日志做粗略地筛选,其中基于规则的判罚方式中的样本抽取规则可以包括用户层的规则321、广告主层的规则322和流量主层的规则323;粗略筛选之后的样本,再通过基于统计的判罚方式进行筛选,例如选出CTR、CVR和作弊率超过一定阈值(该阈值是统计得出的,因此该筛选方式称为基于统计的判罚方式)的广告主、广告位和流量主等名单,然后使用交叉过滤的方法来对样本进行清洗,最终得到正样本324和负样本325,其中得到的正样本和负样本要符合一定的配置比例。
这里,需要说明的是,在正负样本的获取过程中,本发明实施例也利用了分类方法进行对样本进行分类。分类回归的算法目前有多种选择,比如LR、SVM、GBDT等。综合考虑数据量和运算效率,本发明实施例把目标锁定在LR和GBDT上。根据线下测试数据验证表明,LR和GBDT在分类上准确率相差不大,但是LR要求不同特征维度的特征参数要做归一化,而且需要将不同维度的特征参数转换成统一格式,相比之下GBDT可以接受任意类型的特征参数且不需要额外进行归一化。同时GBDT作为一种组合提升算法,通过组合多个弱分类器,来提升最终的分类效果,这种模式在业界也得到广泛的认可。因此作为一种优选的实施方式,选定GBDT作为分类算法。
下面简要介绍一下梯度提升决策树(Gradient Boosting Decision Tree,GBDT)。GBDT使用的元分类器是回归树(Regression Tree),回归树的工作过程包括:将待分类数据输入回归树后会输出一个分类值,通过将该分类值与设定的分类阈值进行比较,从而判定待分类数据是否作弊。GBDT的分类器(分类模型)通过组合的方式将多个回归树进行组合累加,得到最终的分类值,GBDT的分类器采用公式表示如下:

公式(4)中T(x;Θm)表示第m棵回归树分类的结果,Θm表示第m棵回归树,M表示回归树的总数目,x表示待分类的第一触发事件;
在训练训练模型的时候,每一棵回归树都去拟合前边所有已经训练完毕的树的累计结果和真实值的差(也叫Residual,残差,参见下面的公式(5)),
rmj=yj-fm-1(xj),j=1,2,...,N (5);
公式(5)中yj为真实值,fm-1(xj)为训练好的树的预测值累计,j表示第几个样本,N为样本的总数,m表示第几棵树,也就是每棵树只专注前边所有回归树预测错误的部分,从而达到不断缩小分类误差的目的。
步骤S303,根据获取的各种日志生成长期特征;
步骤S304,从正负样本中抽取短期特征;
步骤S305,将长期特征和短期特征输入交叉过滤器,形成输入特征向量;
这里,交叉过滤器的作用是交叉过滤(Cross-Fitering),即将一条点击事件分别映射到用户维度、广告主维度和流量主维度,然后交叉评判当前点击事件是否可以归类为正样本(作弊)。
步骤S306,将输入特征向量输入至训练模型,利用训练模型(GBDT)进行训练,得到训练结果;
步骤S307,如果训练结果不符合预期,则调整训练模型的参数;
步骤S308,如果训练结果符合预期,则输出训练模型作为最终的分类模型。
从以上步骤可以将上述的训练模型的训练过程简单归纳为:1)获取正负样本;2)获取特征参数,将特征参数组成特征向量;3)将点击样本转换为特征向量的形式;4)进行训练模型训练;5)输出分类模型。
下面对GBDT的分类模型进行详细说明,所述分类模型为采用梯度提升决策树而形成的模型fM(x);

其中T(x;Θm)表示第m棵回归树分类的结果,Θm表示第m棵回归树,M表示回归树的总数目,x表示待分类的第一触发事件。
其中M=1,Θ1包括:以在第一时间段内的点击数为第一根节点,以在第二时间段内的点击数为所述第一根节点的第一子节点和第一叶节点,所述第一子节点包括第二叶节点和第三叶节点;
Θ2包括:以在第二时间内的点击频率为第二根节点,所述第二根节点包括第四叶节点和第五叶节点。
上述的Θ1可以参见图3C的左图,在左图中,Θ1的输入为特征向量,该特征向量是由周点击次数(简称周点击)、日点击次数(简称日点击)和点击频率(可以替换为点击间隔,即本次点击与上一次点击的时间间隔)组成的向量。当有需要分类的点击数据时,需要从待分类的点击数据提取出周点击、日点击和点击频率这些特征参数,然后再将这些特征参数组成特征向量,在将这些特征向量输入Θ1,在Θ1中,周点击作为Θ1的根节点,该周点击的分类阈值为50次,其中大于50次的周点击作为所述Θ1的根节点的第一子节点,而小于50次的周点击作为Θ1的第一叶子节点,而第一叶子节点的作弊概率为0.2,其中叶子节点的作弊概率为该点击数据在该叶子节点被分类为作弊点击的概率。第一子节点以日点击作为分类参数,其中日点击的分类阈值为20次,大于20次的日点击作为Θ1的第二叶子节点,小于20次的日点击作为Θ1的第三叶子节点,第二叶子节点的作弊概率为0.8,而第三叶子节点的作弊概率为0.7。当一个点击数据经过二叉树的分类后,最终会由Θ1分类出一个作弊概率。
上述的Θ2可以参见图3C的右图,Θ2只有一个分类节点,其中分类参数为点击频率,而该点击频率的分类阈值为0.5,Θ2的两个叶子节点的作弊概率分别为0.15和-0.03。从Θ2和Θ1上可以看出,在图3C中的分类模型一共包括两个回归树,而输入的点击一共包括4个样本ABCD,每一个样本经过回归树分类后都会得到一个作弊概率,那么将两棵树得出的作弊概率相加即为分类模型最终得出的该样本的分类为作弊点击的概率,以样本A为例,样本A经过Θ1分类后的作弊概率为0.8,经过Θ2分类后的作弊概率为(0.15),那么分类模型最终得出的样本A的作弊概率为0.95(0.95=0.8+0.15)。
下面先介绍一种基于规则的判罚方式对作弊流量进行实时过滤的方法,广告平台或者流量平台为了对作弊流量的实时过滤,通常采用基于规则的方式(Rule-based)对作弊流量进行识别判罚,比如点击频次控制、黑名单等方式来实现对作弊流量的惩罚。参见图3D,基于对作弊流量进行实时过滤的方法一般包括以下几个步骤:
步骤S51,策略人员人工线下进行数据调研,根据调研结果和人工经验制定出不同的规则;
这里,不同的规则是设置的一些关于判罚的阈值和惩罚生效时间的规则,例如可以包括用户层的规则、广告主层的规则和流量主层的规则,其中,图3D中仅列出了一些用户层的规则,例如IP黑名单341、用户黑名单342、IP点击是否过于频繁343、用户点击是否过于频繁344等。
步骤S52,当输入的在线点击流在指定维度(例如IP黑名单或者用户)达到满足条件,则认为该点击认为作弊点击。
其中,所述条件可以是一维(只包括名单)或二维(包括阈值和时间),例如,如果指定维度是IP黑名单,那么如果点击流中的用户的IP地址是IP黑名单中的,那么则该点击被认为是作弊点击;如果指定维度是用户点击是否过于频繁,那么如果该用户的当前点击次数已经超过阈值,那么用户在之后的点击将被视为作弊点击,换句话说,之前的点击则被视为正常点击。
这种基于规则的判罚方式存在以下问题:1)基于规则的判罚方式中所涉及的所有参数均由人工根据调研结果进行设定,因此,这些参数过于经验化;2)由于基于规则的判罚方式中参数是根据经验设定,因此参数的可解释性较差;3)基于规则的判罚方式的另一大缺陷为:作弊者可以通过尝试不同作弊频率来试探,从而反向推出一些反作弊策略的参数,从而绕开基于规则的判罚;4)基于规则判罚的判罚方式中的规则过于严苛,因为一般采用的规则是这样的:认为作弊流量始终产生在时间序列的中间,故而基于规则的判罚方式中严苛地放过时间序列开头的流量,以及完全砍掉时间序列末尾的流量;但是,实际中的作弊点击可能出现在时间序列的开始、中间或者结尾,因此,基于规则的判罚方式得出的数据可能会比实际的作弊点击少,另外,基于规则的判罚方式中判罚的作弊点击可能是正常用户产生的部分有异常的点击,而正常用户产生的有一场的点击却不应该计算为作弊点击,由此可见,基于规则的判罚方式得出的数据存在一定误差;5)基于规则的判罚方式中的反作弊规则要做好保密工作,防止细节的泄露,而反作弊规则一旦遭到泄漏,那么作弊者就会绕过所有的作弊规则,从而给广告主造成经济损失以及给广告平台造成声誉损失。
实施例四
实施例三介绍了如何形成分类模型的过程,本发明实施例介绍一下如何利用形成的分类模型进行点击分类的流程,参见图4所示,该流程包括:
步骤S401,生成长期特征;
这里,从Hadoop分布式服务器获取各种日志,从上述的各种日志中抽取出长期特征。
步骤S402,将抽取的长期特征存储于内存服务器;
步骤S403,获取在线点击流;
这里,获取在线的点击流后,从在线点击流中提取待分类的点击事件;
步骤S404,将点击事件输入查询服务系统,然后加载分类模型;
步骤S405,根据点击事件确定用户的标识信息,根据用户的标识信息从内存服务器获取长期特征和短期特征;
这里,从内存服务器获取的短期特征可以理解为上一次点击的短期特征,例如在本次点击之前,该用户的点击次数为25次,如果想要获取当前用户的点击次数,那么需要获知该用户今日之前的点击次数,而用户今日之前的点击次数就以短期特征的形式存储于内存服务器。
步骤S406,根据从内存服务器获取的短期特征和当前的点击事件确定当前点击的短期特征;
步骤S407,将从内存服务器获取的长期特征,步骤S406确定的短期特征,形成特征向量输入到分类模型,然后获取分类模型输出的分类结果;
这里,还需要将本次的短期特征返回到内存服务器,以便下一次分类的时候,用来计算下一次点击的短期特征。所述分类结果即判断该点击是作弊点击还是正常点击。综合实施三和实施例四,训练模型训练完毕后得到分类模型,将分类模型加载到线上的服务器(查询服务系统),同时把一部分长期的特征数据加载到线上。当点击事件到达查询服务系统,实时将点击数据转换为特征向量,然后将特征向量输入分类模型进行分类(即打分的过程),根据分类结果(可以理解为打分结果)决定是否惩罚。
实施例五
基于前述的实施例,本发明实施例提供一种信息处理装置,该装置所包括的第一确定单元、第一获取单元、第二获取单元、第二确定单元、输入单元、第三获取单元和输出单元等各单元,以及各单元所包括的各模块,都可以通过信息处理设备中的处理器来实现,当然也可通过具体的逻辑电路实现;其中,对于用于数据处理的处理器而言,在执行处理时,可以采用微处理器、中央处理器(CPU,Central Processing Unit)、数字信号处理器(DSP,Digital Singnal Processor)或可编程逻辑阵列(FPGA,Field Programmable GateArray)实现;对于存储介质来说,包含操作指令,该操作指令可以为计算机可执行代码,通过所述操作指令来实现上述本发明实施例信息处理方法流程中的各个步骤。
本发明实施例中的终端、信息处理设备、服务器等作为硬件实体S11的一个示例如图5A所示,硬件实体S11包括处理器31、存储介质32以及至少一个外部通信接口33;所述处理器31、存储介质32以及外部通信接口33均通过总线34连接。
图5B为本发明实施例五信息处理装置的组成结构示意图,如图5B所示,该装置500包括第一确定单元501、第一获取单元502、第二获取单元503、第二确定单元504、输入单元505、第三获取单元506和输出单元507,其中:
所述第一确定单元501,用于确定待分类的第一触发事件,所述第一触发事件用于描述第一触发操作;
所述第一获取单元502,用于从所述第一触发事件中获取用户的标识信息和所述第一触发操作的属性信息;
所述第二获取单元503,用于根据所述用户的标识信息获取用于描述所述用户在第一时间段内的用户行为特征的第一特征参数;
所述第二确定单元504,用于根据所述第一触发操作的属性信息确定用于描述所述用户在第二时间段内的用户行为特征的第二特征参数,其中,所述第一时间段大于所述第二时间段;
所述输入单元505,用于将所述第一特征参数和所述第二特征参数输入预设的分类模型,所述分类模型以所述第一特征参数和所述第二特征参数为分类参数;
所述第三获取单元506,用于获取所述分类模型输出的所述第一触发事件的分类结果;
所述输出单元507,用于输出所述分类结果。
本发明实施例中,所述第一触发操作的属性信息至少包括所述第一触发事件的触发时刻,所述第二时间段包括从预设的第一时刻至所述第一触发事件的触发时刻之间的时间段;
所述第二确定单元包括第一获取模块和确定模块,其中:
所述第一获取模块,用于根据所述用户的标识信息获取第二触发事件的第三特征参数,所述第二触发事件包括距离所述第一触发操作的点击时刻之间的时间差最短的触发事件,所述第三特征参数用于所述用户从所述第一时刻至所述第二触发事件的触发时刻之间的时间段内的用户行为特征;
所述确定模块,用于根据所述第一触发操作的属性信息和所述第三特征参数确定所述第二特征参数。
本发明实施例中,所述第一确定单元包括接收模块和第一提取模块,其中,所述接收模块,用于接收在线的触发流,所述第一提取模块,用于从所述触发流中提取出所述第一触发事件;或者,
所述第一确定单元包括第二获取模块和第二提取模块,所述第二获取模块,用于获取触发操作的日志,所述第二提取模块,用于从所述操作日志中提取出所述第一触发事件。
本发明实施例中,所述装置还包括第四获取单元、提取单元、第二输入单元、调整单元和第三确定单元,其中:
所述第四获取单元,用于按照预设的正负样本的配置比例获取正样本和负样本;
所述提取单元,用于提取所述正样本的不同维度的特征参数和所述负样本的不同维度的特征参数;
所述第二输入单元,用于将所述正样本或所述负样本及其不同维度的特征参数和输入设置的第一训练模型,得到第一训练结果,所述第一训练模型以具有预设权重的不同维度的特征参数为分类参数;
所述调整单元,用于如果所述第一训练结果不满足预设的条件,则逐一调整每一所述不同维度的特征参数的权重直至所述训练结果满足所述条件,将所述第一训练结果满足所述条件的第一训练模型作为所述分类模型输出;
所述第三确定单元,用于如果所述第一训练结果满足预设的条件,则将所述第一训练模型作为所述分类模型输出。
本发明实施例中,所述每一所述不同维度的特征参数的权重,包括:
利用 从所述不同维度的特征参数中筛选出所述第一特征参数和所述第二特征参数;
其中,D表示作为训练数据集的正样本和负样本,A表示某一维度的特征参数,g(D,A)表示特征参数A在训练数据集D下获得的权重,P(D)i表示训练数据集D分类为i的概率,n表示样本一共有几种可能性,P(D/A)i表示在给定特征参数A的前提下,训练数据集D分类为i的条件概率。
本发明实施例中,所述第一特征参数包括在第一时间段内的点击数,所述第二特征参数包括在第二时间段内的点击数和点击频率。
本发明实施例中,所述分类模型为采用梯度提升决策树而形成的模型fM(x), 其中T(x;Θm)表示第m棵回归树分类的结果,Θm表示第m棵回归树,M表示回归树的总数目,x表示待分类的第一触发事件;
其中M=1,Θ1包括:以在第一时间段内的点击数为第一根节点,以在第二时间段内的点击数为所述第一根节点的第一子节点和第一叶节点,所述第一子节点包括第二叶节点和第三叶节点;
Θ2包括:以在第二时间内的点击频率为第二根节点,所述第二根节点包括第四叶节点和第五叶节点。
这里需要指出的是:以上装置实施例的描述,与上述方法实施例的描述是类似的,具有同方法实施例相似的有益效果,因此不做赘述。对于本发明装置实施例中未披露的技术细节,请参照本发明方法实施例的描述而理解,为节约篇幅,因此不再赘述。
实施例六
基于前述的实施例,本发明实施例提供一种信息处理设备,图6为本发明实施例六信息处理设备的组成结构示意图,如图6所示,该信息处理设备600包括显示装置601和处理装置602,其中:
所述显示装置601,用于显示所述处理装置输出的分类结果;
所述处理装置602,用于:确定待分类的第一触发事件,所述第一触发事件用于描述第一触发操作;从所述第一触发事件中获取用户的标识信息和所述第一触发操作的属性信息;根据所述用户的标识信息获取用于描述所述用户在第一时间段内的用户行为特征的第一特征参数;根据所述第一触发操作的属性信息确定用于描述所述用户在第二时间段内的用户行为特征的第二特征参数,其中,所述第一时间段大于所述第二时间段;将所述第一特征参数和所述第二特征参数输入预设的分类模型,所述分类模型以所述第一特征参数和所述第二特征参数为分类参数;获取所述分类模型输出的所述第一触发事件的分类结果;输出所述分类结果。
这里需要指出的是:以上设备实施例项的描述,与上述方法描述是类似的,具有同方法实施例相同的有益效果,因此不做赘述。对于本发明设备实施例中未披露的技术细节,本领域的技术人员请参照本发明方法实施例的描述而理解,为节约篇幅,这里不再赘述。
应理解,说明书通篇中提到的“一个实施例”或“一实施例”意味着与实施例有关的特定特征、结构或特性包括在本发明的至少一个实施例中。因此,在整个说明书各处出现的“在一个实施例中”或“在一实施例中”未必一定指相同的实施例。此外,这些特定的特征、结构或特性可以任意适合的方式结合在一个或多个实施例中。应理解,在本发明的各种实施例中,上述各过程的序号的大小并不意味着执行顺序的先后,各过程的执行顺序应以其功能和内在逻辑确定,而不应对本发明实施例的实施过程构成任何限定。上述本发明实施例序号仅仅为了描述,不代表实施例的优劣。
需要说明的是,在本文中,术语“包括”、“包含”或者其任何其他变体意在涵盖非排他性的包含,从而使得包括一系列要素的过程、方法、物品或者装置不仅包括那些要素,而且还包括没有明确列出的其他要素,或者是还包括为这种过程、方法、物品或者装置所固有的要素。在没有更多限制的情况下,由语句“包括一个……”限定的要素,并不排除在包括该要素的过程、方法、物品或者装置中还存在另外的相同要素。
在本申请所提供的几个实施例中,应该理解到,所揭露的设备和方法,可以通过其它的方式实现。以上所描述的设备实施例仅仅是示意性的,例如,所述单元的划分,仅仅为一种逻辑功能划分,实际实现时可以有另外的划分方式,如:多个单元或组件可以结合,或可以集成到另一个系统,或一些特征可以忽略,或不执行。另外,所显示或讨论的各组成部分相互之间的耦合、或直接耦合、或通信连接可以是通过一些接口,设备或单元的间接耦合或通信连接,可以是电性的、机械的或其它形式的。
上述作为分离部件说明的单元可以是、或也可以不是物理上分开的,作为单元显示的部件可以是、或也可以不是物理单元;既可以位于一个地方,也可以分布到多个网络单元上;可以根据实际的需要选择其中的部分或全部单元来实现本实施例方案的目的。
另外,在本发明各实施例中的各功能单元可以全部集成在一个处理单元中,也可以是各单元分别单独作为一个单元,也可以两个或两个以上单元集成在一个单元中;上述集成的单元既可以采用硬件的形式实现,也可以采用硬件加软件功能单元的形式实现。
本领域普通技术人员可以理解:实现上述方法实施例的全部或部分步骤可以通过程序指令相关的硬件来完成,前述的程序可以存储于计算机可读取存储介质中,该程序在执行时,执行包括上述方法实施例的步骤;而前述的存储介质包括:移动存储设备、只读存储器(Read Only Memory,ROM)、磁碟或者光盘等各种可以存储程序代码的介质。
或者,本发明上述集成的单元如果以软件功能模块的形式实现并作为独立的产品销售或使用时,也可以存储在一个计算机可读取存储介质中。基于这样的理解,本发明实施例的技术方案本质上或者说对现有技术做出贡献的部分可以以软件产品的形式体现出来,该计算机软件产品存储在一个存储介质中,包括若干指令用以使得一台计算机设备(可以是个人计算机、服务器、或者网络设备等)执行本发明各个实施例所述方法的全部或部分。而前述的存储介质包括:移动存储设备、ROM、磁碟或者光盘等各种可以存储程序代码的介质。
以上所述,仅为本发明的具体实施方式,但本发明的保护范围并不局限于此,任何熟悉本技术领域的技术人员在本发明揭露的技术范围内,可轻易想到变化或替换,都应涵盖在本发明的保护范围之内。因此,本发明的保护范围应以所述权利要求的保护范围为准。
Claims (13)
1.一种信息处理方法,其特征在于,所述方法包括:
确定待分类的第一触发事件,所述第一触发事件用于描述第一触发操作;
从所述第一触发事件中获取用户的标识信息和所述第一触发操作的属性信息;
根据所述用户的标识信息获取用于描述所述用户在第一时间段内的用户行为特征的第一特征参数;
根据所述第一触发操作的属性信息确定用于描述所述用户在第二时间段内的用户行为特征的第二特征参数,其中,所述第一时间段大于所述第二时间段;
将所述第一特征参数和所述第二特征参数输入预设的分类模型,所述分类模型以所述第一特征参数和所述第二特征参数为分类参数;
获取所述分类模型输出的所述第一触发事件的分类结果;所述分类结果用于表征所述第一触发事件是否为作弊操作;
输出所述分类结果。
2.根据权利要求1所述的方法,其特征在于,所述第一触发操作的属性信息至少包括所述第一触发事件的触发时刻,所述第二时间段包括从预设的第一时刻至所述第一触发事件的触发时刻之间的时间段。
3.根据权利要求2所述的方法,其特征在于,所述根据所述第一触发操作的属性信息确定用于描述所述用户在第二时间段内的用户行为特征的第二特征参数,包括:
根据所述用户的标识信息获取第二触发事件的第三特征参数,所述第二触发事件包括距离所述第一触发操作的点击时刻之间的时间差最短的触发事件,所述第三特征参数用于所述用户从所述第一时刻至所述第二触发事件的触发时刻之间的时间段内的用户行为特征;
根据所述第一触发操作的属性信息和所述第三特征参数确定所述第二特征参数。
4.根据权利要求1所述的方法,其特征在于,所述确定待分类的第一触发事件,包括:
接收在线的触发流,从所述触发流中分离出所述第一触发事件;或者,
获取触发操作的日志,从所述操作日志中提取出所述第一触发事件。
5.根据权利要求1至4任一项所述的方法,其特征在于,所述方法还包括:
按照预设的配置比例获取正样本和负样本;
提取所述正样本的不同维度的特征参数和所述负样本的不同维度的特征参数;
将所述正样本或所述负样本的不同维度的特征参数输入设置的第一训练模型,得到第一训练结果,所述第一训练模型以具有预设权重的不同维度的特征参数为分类参数;
如果所述第一训练结果不满足预设的条件,则逐一调整每一所述不同维度的特征参数的权重直至所述训练结果满足所述条件,将所述第一训练结果满足所述条件的第一训练模型作为所述分类模型输出;
如果所述第一训练结果满足预设的条件,则将所述第一训练模型作为所述分类模型输出。
6.根据权利要求5所述的方法,其特征在于,所述调整每一所述不同维度的特征参数的权重,包括:
利用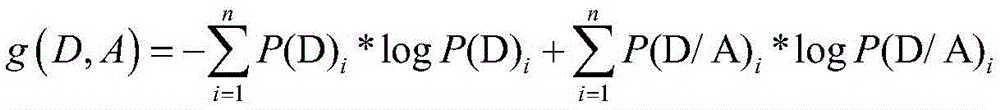 从所述不同维度的特征参数中筛选出所述第一特征参数和所述第二特征参数;
其中,D表示作为训练数据集的正样本和负样本,A表示所述不同维度的中一个维度的特征参数,g(D,A)表示特征参数A在训练数据集D下获得的权重,P(D)i表示训练数据集D分类为i的概率,P(D/A)i表示在给定特征参数A的前提下,训练数据集D分类为i的条件概率。
7.根据权利要求1至4任一项所述的方法,其特征在于,所述第一特征参数包括在第一时间段内的点击数,所述第二特征参数包括在第二时间段内的点击数和点击频率或点击的时间间隔。
8.根据权利要求6所述的方法,其特征在于,所述分类模型为采用梯度提升决策树而形成的模型fM(x),

其中T(x;Θm)表示第m棵回归树分类的结果,Θm表示第m棵回归树,M表示回归树的总数目,x表示待分类的第一触发事件;
其中M=1,Θ1包括:以在第一时间段内的点击数为第一根节点,以在第二时间段内的点击数为所述第一根节点的第一子节点和第一叶节点,所述第一子节点包括第二叶节点和第三叶节点;
Θ2包括:以在第二时间内的点击频率为第二根节点,所述第二根节点包括第四叶节点和第五叶节点。
9.一种信息处理装置,其特征在于,所述装置包括第一确定单元、第一获取单元、第二获取单元、第二确定单元、输入单元、第三获取单元和输出单元,其中:
所述第一确定单元,用于确定待分类的第一触发事件,所述第一触发事件用于描述第一触发操作;
所述第一获取单元,用于从所述第一触发事件中获取用户的标识信息和所述第一触发操作的属性信息;
所述第二获取单元,用于根据所述用户的标识信息获取用于描述所述用户在第一时间段内的用户行为特征的第一特征参数;
所述第二确定单元,用于根据所述第一触发操作的属性信息确定用于描述所述用户在第二时间段内的用户行为特征的第二特征参数,其中,所述第一时间段大于所述第二时间段;
所述输入单元,用于将所述第一特征参数和所述第二特征参数输入预设的分类模型,所述分类模型以所述第一特征参数和所述第二特征参数为分类参数;
所述第三获取单元,用于获取所述分类模型输出的所述第一触发事件的分类结果;所述分类结果用于表征所述第一触发事件是否为作弊操作;
所述输出单元,用于输出所述分类结果。
10.根据权利要求9所述的装置,其特征在于,所述第一触发操作的属性信息至少包括所述第一触发事件的触发时刻,所述第二时间段包括从预设的第一时刻至所述第一触发事件的触发时刻之间的时间段;
所述第二确定单元包括第一获取模块和确定模块,其中:
所述第一获取模块,用于根据所述用户的标识信息获取第二触发事件的第三特征参数,所述第二触发事件包括距离所述第一触发操作的点击时刻之间的时间差最短的触发事件,所述第三特征参数用于所述用户从所述第一时刻至所述第二触发事件的触发时刻之间的时间段内的用户行为特征;
所述确定模块,用于根据所述第一触发操作的属性信息和所述第三特征参数确定所述第二特征参数。
11.根据权利要求10所述的装置,其特征在于,所述第一确定单元包括接收模块和第一提取模块,其中,所述接收模块,用于接收在线的触发流,所述第一提取模块,用于从所述触发流中提取出所述第一触发事件;或者,
所述第一确定单元包括第二获取模块和第二提取模块,所述第二获取模块,用于获取触发操作的日志,所述第二提取模块,用于从所述操作日志中提取出所述第一触发事件。
12.根据权利要求10或11所述的装置,其特征在于,所述装置还包括第四获取单元、提取单元、第二输入单元、调整单元和第三确定单元,其中:
所述第四获取单元,用于按照预设的配置比例获取正样本和负样本;
所述提取单元,用于提取所述正样本的不同维度的特征参数和所述负样本的不同维度的特征参数;
所述第二输入单元,用于将所述正样本或所述负样本的不同维度的特征参数输入设置的第一训练模型,得到第一训练结果,所述第一训练模型以具有预设权重的不同维度的特征参数为分类参数;
所述调整单元,用于如果所述第一训练结果不满足预设的条件,则逐一调整每一所述不同维度的特征参数的权重直至所述训练结果满足所述条件,将所述第一训练结果满足所述条件的第一训练模型作为所述分类模型输出;
所述第三确定单元,用于如果所述第一训练结果满足预设的条件,则将所述第一训练模型作为所述分类模型输出。
13.一种信息处理设备,其特征在于,所述设备包括显示装置和处理装置,其中:
所述显示装置,用于显示所述处理装置输出的分类结果;
所述处理装置,用于:确定待分类的第一触发事件,所述第一触发事件用于描述第一触发操作;从所述第一触发事件中获取用户的标识信息和所述第一触发操作的属性信息;根据所述用户的标识信息获取用于描述所述用户在第一时间段内的用户行为特征的第一特征参数;根据所述第一触发操作的属性信息确定用于描述所述用户在第二时间段内的用户行为特征的第二特征参数,其中,所述第一时间段大于所述第二时间段;将所述第一特征参数和所述第二特征参数输入预设的分类模型,所述分类模型以所述第一特征参数和所述第二特征参数为分类参数;获取所述分类模型输出的所述第一触发事件的分类结果;所述分类结果用于表征所述第一触发事件是否为作弊操作;输出所述分类结果。
Priority Applications (1)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| CN201510990666.0A CN106919579B (zh) | 2015-12-24 | 2015-12-24 | 一种信息处理方法及装置、设备 |
Applications Claiming Priority (1)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| CN201510990666.0A CN106919579B (zh) | 2015-12-24 | 2015-12-24 | 一种信息处理方法及装置、设备 |
Publications (2)
| Publication Number | Publication Date |
|---|---|
| CN106919579A CN106919579A (zh) | 2017-07-04 |
| CN106919579B true CN106919579B (zh) | 2020-11-06 |
Family
ID=59456890
Family Applications (1)
| Application Number | Title | Priority Date | Filing Date |
|---|---|---|---|
| CN201510990666.0A Active CN106919579B (zh) | 2015-12-24 | 2015-12-24 | 一种信息处理方法及装置、设备 |
Country Status (1)
| Country | Link |
|---|---|
| CN (1) | CN106919579B (zh) |
Families Citing this family (24)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| CN110069617A (zh) * | 2017-11-09 | 2019-07-30 | 北京嘀嘀无限科技发展有限公司 | 论坛帖的管理方法、装置、服务器和计算机可读存储介质 |
| CN107908522B (zh) * | 2017-11-15 | 2021-05-04 | 北京小米移动软件有限公司 | 信息展示方法、装置及计算机可读存储介质 |
| CN107993078B (zh) * | 2017-12-22 | 2020-08-14 | 北京三快在线科技有限公司 | 用于评价信息展示效果方法和装置以及计算设备 |
| CN109961080B (zh) * | 2017-12-26 | 2022-09-23 | 腾讯科技(深圳)有限公司 | 终端识别方法及装置 |
| CN110213209B (zh) * | 2018-05-11 | 2022-01-07 | 腾讯科技(深圳)有限公司 | 一种推送信息点击的作弊检测方法、装置及存储介质 |
| CN108694616A (zh) * | 2018-05-24 | 2018-10-23 | 百度在线网络技术(北京)有限公司 | 广告作弊的识别方法和装置 |
| CN108763574A (zh) * | 2018-06-06 | 2018-11-06 | 电子科技大学 | 一种基于梯度提升树的微博谣言检测算法与谣言检测特征集合 |
| CN109255391B (zh) * | 2018-09-30 | 2021-07-23 | 武汉斗鱼网络科技有限公司 | 一种识别恶意用户的方法、装置及存储介质 |
| CN109509028A (zh) * | 2018-11-15 | 2019-03-22 | 北京奇虎科技有限公司 | 一种广告投放方法及装置、存储介质、计算机设备 |
| CN111435507A (zh) * | 2019-01-11 | 2020-07-21 | 腾讯科技(北京)有限公司 | 广告反作弊方法、装置、电子设备及可读存储介质 |
| CN109947344B (zh) * | 2019-02-20 | 2020-09-04 | 腾讯科技(深圳)有限公司 | 一种应用策略模型的训练方法及装置 |
| CN111832789B (zh) * | 2019-09-24 | 2024-09-06 | 北京嘀嘀无限科技发展有限公司 | 位置确定方法、模型训练方法、装置、设备和存储介质 |
| CN112657172B (zh) * | 2019-10-15 | 2025-07-22 | 腾讯科技(深圳)有限公司 | 一种目标任务控制方法、装置、电子设备及存储介质 |
| CN110909984B (zh) * | 2019-10-28 | 2023-04-07 | 苏宁金融科技(南京)有限公司 | 业务数据处理模型训练方法、业务数据处理方法及装置 |
| CN110935176B (zh) * | 2019-11-27 | 2023-09-12 | 上海畅造网络科技有限公司 | 一种基于大数据的游戏指令预判系统及其工作方法 |
| CN111061954B (zh) * | 2019-12-19 | 2022-03-15 | 腾讯音乐娱乐科技(深圳)有限公司 | 搜索结果排序方法、装置及存储介质 |
| CN111786938B (zh) * | 2020-03-06 | 2021-10-15 | 北京沃东天骏信息技术有限公司 | 防止恶意获取资源的方法、系统和电子设备 |
| CN111651538B (zh) * | 2020-05-11 | 2022-11-01 | 腾讯科技(深圳)有限公司 | 一种位置映射方法、装置、设备及可读存储介质 |
| CN111833101B (zh) * | 2020-06-30 | 2025-08-05 | 腾讯科技(深圳)有限公司 | 信息处理方法、装置、介质及电子设备 |
| CN112506981A (zh) * | 2021-02-05 | 2021-03-16 | 深圳市阿卡索资讯股份有限公司 | 一种线上培训服务推送方法和装置 |
| CN113052632B (zh) * | 2021-03-25 | 2024-05-17 | 北京沃东天骏信息技术有限公司 | 一种广告流量数据的识别方法、装置、设备及存储介质 |
| CN112802456A (zh) * | 2021-04-14 | 2021-05-14 | 北京世纪好未来教育科技有限公司 | 一种语音评测打分方法、装置、电子设备及存储介质 |
| CN115495971A (zh) * | 2021-06-17 | 2022-12-20 | 中国移动通信有限公司研究院 | 重要事件提取方法、装置及设备 |
| CN114240471A (zh) * | 2021-11-01 | 2022-03-25 | 上海珍玩网络科技有限公司 | 一种游戏软件推广观看数据分析方法 |
Family Cites Families (19)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| US7676394B2 (en) * | 2005-09-14 | 2010-03-09 | Jumptap, Inc. | Dynamic bidding and expected value |
| US20070073579A1 (en) * | 2005-09-23 | 2007-03-29 | Microsoft Corporation | Click fraud resistant learning of click through rate |
| US8509750B2 (en) * | 2005-11-05 | 2013-08-13 | Jumptap, Inc. | System for targeting advertising content to a plurality of mobile communication facilities |
| EP2321742A1 (en) * | 2008-07-09 | 2011-05-18 | Kxen | A method of generating an analytical data set for input into an analytical model |
| US8326777B2 (en) * | 2009-07-31 | 2012-12-04 | Yahoo! Inc. | Supplementing a trained model using incremental data in making item recommendations |
| CN102176698A (zh) * | 2010-12-20 | 2011-09-07 | 北京邮电大学 | 一种基于迁移学习的用户异常行为检测方法 |
| CN103685423B (zh) * | 2012-09-24 | 2018-09-04 | 腾讯科技(深圳)有限公司 | 一种信息接收的方法、装置及系统 |
| CN103077240B (zh) * | 2013-01-10 | 2015-09-23 | 北京工商大学 | 一种基于概率图模型的微博水军识别方法 |
| US9342842B2 (en) * | 2013-04-01 | 2016-05-17 | Apple Inc. | Context-switching taxonomy for mobile advertisement |
| CN103605697B (zh) * | 2013-11-06 | 2016-08-24 | 北京掌阔移动传媒科技有限公司 | 一种手机广告作弊点击的判断方法 |
| CN104091276B (zh) * | 2013-12-10 | 2015-08-26 | 深圳市腾讯计算机系统有限公司 | 在线分析点击流数据的方法和相关装置及系统 |
| CN104778173B (zh) * | 2014-01-10 | 2020-01-10 | 腾讯科技(深圳)有限公司 | 目标用户确定方法、装置及设备 |
| CN104866296B (zh) * | 2014-02-25 | 2019-05-28 | 腾讯科技(北京)有限公司 | 数据处理方法和装置 |
| CN104270373B (zh) * | 2014-10-11 | 2017-07-14 | 国家电网公司 | 一种基于时间特征的Web服务器匿名访问流量检测方法 |
| CN104731937B (zh) * | 2015-03-30 | 2018-05-01 | 百度在线网络技术(北京)有限公司 | 用户行为数据的处理方法及装置 |
| CN104965874B (zh) * | 2015-06-11 | 2019-09-13 | 腾讯科技(北京)有限公司 | 信息处理方法及装置 |
| CN104933157A (zh) * | 2015-06-26 | 2015-09-23 | 百度在线网络技术(北京)有限公司 | 用于获取用户属性信息的方法、装置及服务器 |
| CN105072089B (zh) * | 2015-07-10 | 2018-09-25 | 中国科学院信息工程研究所 | 一种web恶意扫描行为异常检测方法与系统 |
| CN105025170B (zh) * | 2015-08-05 | 2017-10-10 | 张京源 | 一种手机非正常使用的检测告警方法 |
-
2015
- 2015-12-24 CN CN201510990666.0A patent/CN106919579B/zh active Active
Also Published As
| Publication number | Publication date |
|---|---|
| CN106919579A (zh) | 2017-07-04 |
Similar Documents
| Publication | Publication Date | Title |
|---|---|---|
| CN106919579A (zh) | 一种信息处理方法及装置、设备 | |
| CN101937545B (zh) | 触点定制系统 | |
| CN108427690B (zh) | 信息投放方法及装置 | |
| CN103763361A (zh) | 一种基于用户行为推荐应用的方法、系统及推荐服务器 | |
| CN109961296A (zh) | 商户类型识别方法及装置 | |
| TW201520936A (zh) | 使用者參與度上下文相關之非保證交付自動標價 | |
| CN105678317B (zh) | 一种信息处理方法及服务器 | |
| CN107346496A (zh) | 目标用户定向方法及装置 | |
| CN108427708A (zh) | 数据处理方法、装置、存储介质和电子装置 | |
| CN108510303A (zh) | 广告投放方法及装置 | |
| WO2018130201A1 (zh) | 确定关联账号的方法、服务器及存储介质 | |
| WO2023000491A1 (zh) | 一种应用推荐方法、装置、设备及计算机可读存储介质 | |
| CN106097043A (zh) | 一种信用数据的处理方法及服务器 | |
| CN110035302B (zh) | 信息推荐及模型训练方法和装置、计算设备、存储介质 | |
| CN113362095A (zh) | 一种信息投放的方法和装置 | |
| WO2019137485A1 (zh) | 一种业务分值的确定方法、装置及存储介质 | |
| CN105631708B (zh) | 一种信息处理方法及装置 | |
| CN110197389A (zh) | 一种用户识别方法及装置 | |
| WO2014193700A1 (en) | Social media pricing engine | |
| CN116383480B (zh) | 通话场景下媒体推荐的方法、装置、电子设备及存储介质 | |
| CN115392944A (zh) | 一种推广内容的处理方法、装置、计算机设备和存储介质 | |
| CN116228320B (zh) | 一种直播广告投放效果分析系统及方法 | |
| CN112015970A (zh) | 产品推荐方法、相关设备及计算机存储介质 | |
| CN115936782A (zh) | 广告投放效果预估方法、装置、电子设备和存储介质 | |
| KR102397014B1 (ko) | 광고 목표 별 가격 경쟁력 및 상기 광고 목표 별 병목도에 기초하여 광고 예산을 집행하기 위한 광고 제공 방법 및 시스템 |
Legal Events
| Date | Code | Title | Description |
|---|---|---|---|
| PB01 | Publication | ||
| PB01 | Publication | ||
| SE01 | Entry into force of request for substantive examination | ||
| SE01 | Entry into force of request for substantive examination | ||
| GR01 | Patent grant | ||
| GR01 | Patent grant |